ControlNetとは何か、プロンプトやimg2imgと何が違うのか
構図もポーズも「条件画像」で固定できるということ
 室谷代表取締役
ControlNetって、ひとことで言うと何をしてくれるものなんですか。名前だけ聞くと「制御する何か」くらいの理解で止まってる人が多そうで。
 テキトー教師DotAI 認定講師
追加の「条件画像」を入力に足す仕組みなんですよ。エッジ検出マップとか深度マップとか、ポーズの骨格とか。
それで構図やポーズをがっちり固定できるんです。
それで構図やポーズをがっちり固定できるんです。
室谷代表取締役なるほど、テキストで「こういう構図で」と頼む代わりに、画像で指定するわけですね。それは精度の話で言うとかなり違う。
テキトー教師DotAI 認定講師全然違います。言葉で伝えきれない配置を、画像1枚で渡せる。
ここが最初に押さえておきたいところですね。
ここが最初に押さえておきたいところですね。
プロンプト頼みの生成やimg2imgとの決定的な違い
室谷代表取締役img2imgがあるじゃないですか。あれとの違いは何なんですか。
テキトー教師DotAI 認定講師img2imgは元画像に近い絵を作る方向で、ControlNetは「構造だけ借りる」感じなんですよ。線だけ、奥行きだけを取り出して、絵柄は別で決められる。
室谷代表取締役構造と画風を分離できる、と。これ、制作の現場で見ると効きますね。
意図した構図に届くまで何十枚も引き直すコストが消えるので、そこは無視できない差なんですよ。
意図した構図に届くまで何十枚も引き直すコストが消えるので、そこは無視できない差なんですよ。
テキトー教師DotAI 認定講師現場でよく聞くのが「同じポーズで服だけ変えたい」なんですけど、まさにそこなんですよ。言葉で何度も言い直す作業がなくなります。
ロックされたコピーと学習可能なコピー、ゼロ畳み込みの役割
室谷代表取締役中身の話も聞きたいです。どうやって元モデルを保ったまま条件を覚えさせてるのか。
テキトー教師DotAI 認定講師元モデルのエンコーダ部分を2つに複製するんです。片方は重みを凍結した「ロックされたコピー」、もう片方が新しい条件を学ぶ「学習可能なコピー」。
この2つを「ゼロ畳み込み」でつなぎます。
この2つを「ゼロ畳み込み」でつなぎます。
室谷代表取締役ゼロ畳み込み、名前がもう分かりにくいんですけど。
テキトー教師DotAI 認定講師重みもバイアスもゼロで初期化した1×1の畳み込み層なんです。初期状態だと出力がゼロなので、学習前は元モデルの出力に何の影響も与えない。
ここが設計の上手いところですね。
ここが設計の上手いところですね。
小規模なデータセットでも元モデルを壊さない理由
室谷代表取締役これ、個人が手元のデータで追加学習しても元モデルが壊れない、という理解で合ってます?
テキトー教師DotAI 認定講師そうなんですよ。ゼロから始まるので、学習が進むにつれて条件の効き方だけが徐々に乗ってくる。
だから小規模なデータセットでも元の性能を保ったまま新しい条件を覚えられるんです。
だから小規模なデータセットでも元の性能を保ったまま新しい条件を覚えられるんです。
室谷代表取締役論文がICCV 2023で、それが今はWebUIやComfyUIの標準パーツとして使われてる。研究と実務の距離が短い領域だなと感じます。
U-Netの各層に14回繰り込んで、SDのエンコーダをそのままバックボーンに再利用してるのも効いてるんですよね。
U-Netの各層に14回繰り込んで、SDのエンコーダをそのままバックボーンに再利用してるのも効いてるんですよね。
テキトー教師DotAI 認定講師最初に戸惑うのが「学習させるほど元が壊れるんじゃないか」という不安なんですけど、そこは構造で解決済みなんですよね。
Canny・Depth・OpenPose、どれを選べばいいのか
プリプロセッサ別の向き不向き
エッジ・線画系
- Canny:線画抽出で画風変換
- M-LSD:直線検出、インテリアなど直線構造が多い絵
- HED:柔らかい輪郭で着色や画風変換向け
- Scribble:手書き線から絵を作る、疑似スクリブルでも可
- Lineart:線画をきれいに保ちたいとき
奥行き・形状系
- Depth:深度マップで奥行きと構図を指定、構図固定に効く
- SD1.5版Depthは512×512で細部が残りやすい(SD2は64×64)
- Normal Map:法線マップで形状の起伏を渡す
- Normal MapはDepthより細部の形状保持に強い
- 面の向きまで欲しいならNormal Map、前後関係だけならDepth
前処理とモデルはセットで1個
室谷代表取締役プリプロセッサとモデルって、単品で選ぶもんじゃないんですよね。あれ、セットで1個なんですよ。
テキトー教師DotAI 認定講師たしかに。現場でよく聞くのは、プリプロセッサだけ変えてモデルは前のまま、みたいな噛み合わない組み合わせなんですよ。
Cannyの前処理をかけたらCanny用のモデル、が基本ですね。
Cannyの前処理をかけたらCanny用のモデル、が基本ですね。
室谷代表取締役エッジ系は線の拾い方が違うだけで、向き不向きがはっきり分かれるんですよ。Cannyは線画抽出で画風変換、M-LSDは直線検出だからインテリアみたいに直線構造が多い絵、HEDは柔らかい輪郭で着色や画風変換向け・・・
テキトー教師DotAI 認定講師Scribbleは手書きの線から絵を作るので、ラフを描いて渡す感覚ですね。自動生成した疑似スクリブルでもいけるので、絵心に自信がなくても試せます。
Lineartは線画をきれいに保ちたいときの選択肢です。
Lineartは線画をきれいに保ちたいときの選択肢です。
奥行きを渡すならDepth、起伏まで欲しいならNormal Map
室谷代表取締役奥行きを渡したいときはDepthですよね。構図を固定したい場面で効くんですよ。
テキトー教師DotAI 認定講師Depthは深度マップで奥行きと構図を指定するもので、SD1.5版は512×512のフル解像度の深度マップを使うので細部が残りやすいんです。Stability社のSD2の深度モデルが64×64なのと比べると差が出る、という話があります。
室谷代表取締役そこは知らなかった。で、Normal Mapはどう使い分けるんです。
テキトー教師DotAI 認定講師Normal Mapは法線マップで形状の起伏を渡すもので、Depthより細部の形状保持に強いんですよ。面の向きまで欲しいときはNormal Map、ざっくり前後関係だけならDepth、みたいな選び方になります。
人物のポーズは骨格で渡す
テキトー教師DotAI 認定講師人物のポーズはOpenPoseが定番ですね。骨格で指定するので、ポーズを言葉で説明するより一発で決まります。
室谷代表取締役あれ、名前がHuman PoseだったりDW Openposeだったり、表記が揺れてるのが地味に困るんですよね。
テキトー教師DotAI 認定講師そうなんですよ。WebUI向けだとDW Openpose、つまりDWPose系のプリプロセッサも使われていて、呼び方が違っても骨格を渡すという役割は同じです。
配布ファイル名が control_v11p_sd15_ で始まるもので揃っているので、そこを見ると対応が分かります。
配布ファイル名が control_v11p_sd15_ で始まるもので揃っているので、そこを見ると対応が分かります。
仕上げ・一部修正・参照は別カテゴリ
室谷代表取締役仕上げ系はまた毛色が違いますよね。Tile、Inpaint、Reference only、Anime Line Drawing。
テキトー教師DotAI 認定講師Tileは拡大したときのディテール補強、Inpaintは一部分だけ描き直す、Reference onlyは構図を参照させたいとき。Anime Line Drawingはアニメ線画向けで、当初はリスク評価のため未公開だったものです。
室谷代表取締役作りたい絵から逆算して、最後にどの工程を任せるかで選ぶのが正解なんですよ。手戻りが減ると工数がそのまま落ちるので、制作の現場だとそこが効いてきます。
テキトー教師DotAI 認定講師まず1枚作りたいならCannyかOpenPoseから触ると分かりやすいと思います。ControlNet 1.1が公式の最新版として継続更新されているので、モデルはそこから揃えるのが無難ですね。
Stable Diffusion WebUIにControlNetを入れる手順
Stable Diffusion WebUIにControlNetを入れる手順
- 01拡張機能sd-webui-controlnetをインストールWebUIを起動し「Extensions」タブ→「Install from URL」を開き、URL欄に https://github.com/Mikubill/sd-webui-controlnet.git を入力して「Install」を押す。完了後「Installed」タブに戻り「Apply and restart UI」を押す(Forge版は標準搭載のため不要)
- 02専用モデルをmodels/ControlNetへ配置Hugging Faceの公式配布ページ(lllyasviel/ControlNet-v1-1)で使いたいプリプロセッサに対応する control_v11p_sd15_*.safetensors をダウンロードし、WebUIフォルダ内の models/ControlNet に置く。設定画面のModel欄にファイル名が出ているか確認する
- 03拡張機能をアップデート「Extensions」タブ→「Installed」を開き「Check for updates」を押す。更新があれば「Apply and restart UI」を押す
拡張機能sd-webui-controlnetのインストール(Forgeは標準搭載)
- WebUIを起動し、「Extensions」タブから「Install from URL」を開く
- URL欄に
https://github.com/Mikubill/sd-webui-controlnet.gitを入力する - 「Install」を押して完了を待つ
- 「Installed」タブに戻り、「Apply and restart UI」を押す
※ Forge版はControlNetが標準搭載されているため、この作業は不要
室谷代表取締役Forgeを使ってるなら話は早くて、ControlNetは最初から入ってるんですよね。AUTOMATIC1111の場合は拡張機能を1個足すだけで済みます。
テキトー教師DotAI 認定講師初めて触る人が最初に戸惑うのが、URLをどこに入れるのか分からないところで。「Extensions」タブの中の「Install from URL」にGitHubのURLを貼る、という流れなんですよ。
室谷代表取締役あのへん、タブの階層が地味に深いんですよね。で、入れたあとに再起動が要る、と。
テキトー教師DotAI 認定講師はい、「Installed」に戻って「Apply and restart UI」までが1セットです。ここで止まって「入らないんですけど」となるケースをよく見ます。
専用モデルの入手先とmodels/ControlNetへの配置
- Hugging Faceの公式配布ページ(lllyasviel/ControlNet-v1-1)を開く
- 使いたいプリプロセッサに対応する
control_v11p_sd15_*.safetensorsをダウンロードする - Stable Diffusion WebUIのフォルダ内にある
models/ControlNetにファイルを置く - 設定画面のModel欄にファイル名が出ているか確認する
室谷代表取締役モデル本体は別なんですよね。拡張機能だけ入れても、選べるものが何もない状態になる。
テキトー教師DotAI 認定講師そこが一番つまずきやすいところで、拡張機能が箱、モデルが中身、みたいな関係なんで。
models/ControlNet に置くだけで一覧に出てきます。室谷代表取締役1.1系ってファイル数が多くて、どれを落とせばいいか迷うんですよ。全部要るわけじゃないですし、ストレージも無限じゃないですからね。
テキトー教師DotAI 認定講師使うプリプロセッサに対応したものだけ持ってくれば十分です。まずは1個、動かせるものを入れてみるのが早いですよ。
拡張機能のアップデート手順
- 「Extensions」タブから「Installed」を開く
- 「Check for updates」を押す
- 更新があれば「Apply and restart UI」を押す
テキトー教師DotAI 認定講師更新はこの3ステップで、正直かなり楽です。設定画面から出ずに終わりますから。
室谷代表取締役このへんの運用、地味に差が出るんですよね。拡張機能って放っておくと古いままになりがちで、気づいたときには前提が変わってた、みたいな。
テキトー教師DotAI 認定講師ありますね。モデル側も新しいものが出るので、片方だけ新しくすると噛み合わないことがあるんですよ。
室谷代表取締役OSSのエコシステムって、本体と周辺で更新の速度が違うのが面白いところで。追う側も「いつ追うか」を決めておいた方が、結果的に静かに運用できます。
設定画面の項目と、Cannyで1枚出力するまで
PreprocessorとModel、Control Weightの考え方
室谷代表取締役ControlNetのパネル、項目が多くて初見だと固まるんですよね。まず何から分ければいいんでしょう。
テキトー教師DotAI 認定講師最初に戸惑うのが、PreprocessorとModelの違いです。Preprocessorは入力画像から条件マップを作る側、Modelはそのマップを拡散モデルに効かせる側。
二段構えなんですよ。
二段構えなんですよ。
室谷代表取締役なるほど、前処理と本体が分かれてるんですね。じゃあ Control Weight はどっちの話ですか。
テキトー教師DotAI 認定講師効かせ具合です。上げるほど条件画像の構図に縛られて、下げるほどプロンプト寄りになる。
ゼロかイチかじゃなくて、ダイヤルを回す感覚で見てます。
ゼロかイチかじゃなくて、ダイヤルを回す感覚で見てます。
Control ModeとResize Mode、Pixel Perfectの使いどころ
テキトー教師DotAI 認定講師Control Mode は3択で、「Balanced」「My prompt is more important」「ControlNet is more important」です。プロンプトの自由度を残したいなら真ん中、構図を死守したいなら右、と覚えると早いです。
室谷代表取締役名前がそのままなのがありがたい。Resize Mode はどうですか。
テキトー教師DotAI 認定講師「Just Resize」「Crop and Resize」「Resize and Fill」の3つです。参照画像と生成サイズがズレるとき、どこを犠牲にするかの選択ですね。
Pixel Perfect は、その解像度まわりの噛み合わせを気にせず済むようにする項目です。ただ細かい挙動は環境で変わるので、公式の記載を一度見ておくのが安全です。
Pixel Perfect は、その解像度まわりの噛み合わせを気にせず済むようにする項目です。ただ細かい挙動は環境で変わるので、公式の記載を一度見ておくのが安全です。
室谷代表取締役制作の現場だと、この設定の噛み合わせで崩れて、後から作り直しになるのが地味に痛いんですよね。最初に型を決めておく方が結局速い。
Cannyで実際に1枚出力するまでの操作手順
- ControlNet パネルで「Enable」にチェックを入れる
- 「Allow Preview」を有効にして、条件マップを確認できる状態にする
- 「Control Type」を選び、「Preprocessor」で canny を選択する
- 「Model」で Canny に対応するモデル(control_v11p_sd15_* 系)を選ぶ。モデルは models/ControlNet に配置済みの前提です
- 参照画像をセットし、「Control Weight」「Control Mode」「Resize Mode」を決める
- プロンプトを入力して生成を実行する
テキトー教師DotAI 認定講師最初の1枚はCannyがいちばん分かりやすいです。輪郭が残るので、結果がズレたかどうかが一目で見えるんですよ。
室谷代表取締役失敗が可視化されるのは大きいですね。
テキトー教師DotAI 認定講師そうなんです。コツは Control Weight を動かして、同じ参照画像で2〜3枚出すこと。
1枚だけで判断すると、プロンプトのせいなのか重みのせいなのか分からなくなるんです。
1枚だけで判断すると、プロンプトのせいなのか重みのせいなのか分からなくなるんです。
室谷代表取締役そこ、うちの制作でも同じで。条件を1個ずつ変えて比べる工程が一番時間を食うので、最初に比べ方を決めてから回す。
順番を決めるだけで手戻りが減ります。
順番を決めるだけで手戻りが減ります。
テキトー教師DotAI 認定講師慣れれば、この一連は数分で回せます。
ComfyUIでControlNetを組むには
Load ControlNetとApply ControlNetの役割分担
ComfyUI/models/controlnetフォルダに使いたいモデルファイルを置くLoad ControlNetノードを配置する(フォルダ内のモデルは自動で検出される)Apply ControlNetノードに positive / negative の条件付け、control_net モデル、前処理済みの参照画像、vae をつなぐApply ControlNetから出た条件付けをサンプラー側へ渡す
室谷代表取締役ComfyUI、最初に戸惑うのがノードが2つに分かれてる点なんですよね。WebUIだと1つの欄で済んだ話が、こっちでは分担されてる。
テキトー教師DotAI 認定講師たしかに。現場感覚で言うと、
制御の中身は全部
Load ControlNet は「どのモデルを使うか決めるだけ」のノードなんですよ。制御の中身は全部
Apply ControlNet 側で決まります。室谷代表取締役なるほど、読み込みと適用が分離されてるから、同じモデルを別の枝に使い回せるわけですね。ノードベースのツールが制作フローに定着していく理由がここにある気がします。
テキトー教師DotAI 認定講師そうなんです。逆に言うと、参照画像の前処理を済ませた状態で
Apply ControlNet に入れないと何も起きないので、そこだけ注意してほしいんですよね。strength・start_percent・end_percentで効き方を調整する
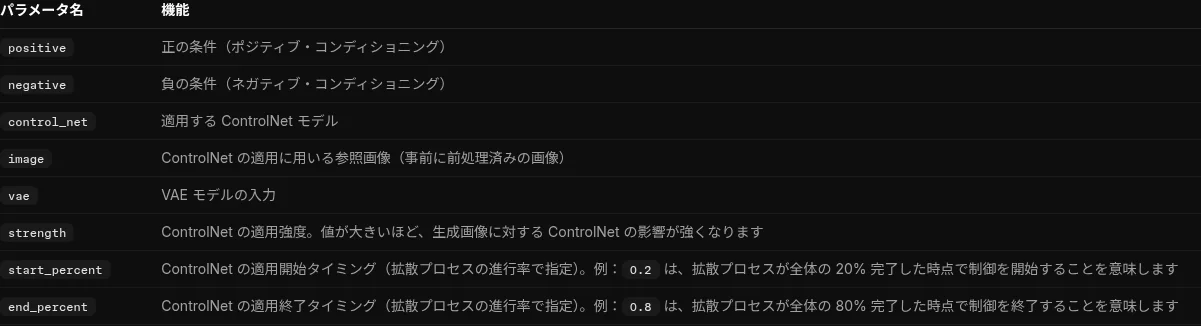
室谷代表取締役適用側の数値、3つあるじゃないですか。あれ、どう使い分けるんですか。
テキトー教師DotAI 認定講師strength は素直に効きの強さです。上げるほど条件画像に引っ張られます。で、
start_percent と end_percent は拡散プロセスの進行率で、たとえば 0.2 なら20%進んだ時点から、0.8 なら80%時点まで適用する、という意味なんですよ。室谷代表取締役途中から効かせられるなら、構図は序盤で決めて後半は自由に描かせる、みたいな調整ができるわけですね。
テキトー教師DotAI 認定講師そうそう。最初に戸惑うのが、
効きすぎると元絵に寄りすぎて、プロンプトがほぼ無視される感じになります。まず中間くらいで試して、そこから動かすのが現実的です。
strength を上げれば上げるほど良いと思ってしまうパターンで。効きすぎると元絵に寄りすぎて、プロンプトがほぼ無視される感じになります。まず中間くらいで試して、そこから動かすのが現実的です。
前処理が足りないときはカスタムノードに頼る
室谷代表取締役前処理のノードが一覧に見当たらない、ってのは。
テキトー教師DotAI 認定講師今のComfy Coreには全種類のプリプロセッサが入っているわけではないので、足りない分は
ComfyUI-Advanced-ControlNet や ComfyUI ControlNet aux といったカスタムノードで補う形になります。室谷代表取締役そこだけ外部依存になるのは、運用する側としては把握しておきたいポイントですね。あと、旧版の適用ノードが検索に出てこないことがあるのも罠ですか。
テキトー教師DotAI 認定講師Apply ControlNet (Old) は非推奨で、デフォルトの検索結果には出てきません。古い作例をそのまま真似するとノードが見つからず止まるので、そこは新しい方を使ってください。複数のControlNetを重ねられるのか、SDXLでも使えるのか
複数ControlNetを重ねる手順(ComfyUI / diffusers)
- 01前提:重ねられるComfyUIでは「Apply ControlNet」ノードを数珠つなぎ(チェーン接続)にして、前のノードの条件付けを次へ渡す
- 02強度バランスを調整両方0.8にすると合計1.6相当の縛りで絵が硬くなる。まず片方1.0、もう片方0.3〜0.5から試す
- 03適用タイミングをずらすstart_percentとend_percentで拡散プロセスの適用範囲を指定。構図は序盤、質感は後半で手を離す
- 04SDXLは専用モデルを用意SD1.5向けモデルは噛み合わないためSDXL専用ControlNetを別途ダウンロード。WebUI拡張はv1.1.4以降で対応
- 05コードから重ねる(diffusers)条件画像をリストで渡し、controlnet_conditioning_scaleも同じ順番のリストに。全条件画像を生成サイズへ先にリサイズ(忘れるとサイズ不一致で落ちる)
重ねられるのか、まず前提の整理から
室谷代表取締役ここからが実務の話なんですけど。輪郭をCannyで固定しつつ、奥行きはDepthで、みたいに二つ三つ重ねたいって普通に思うじゃないですか。
これ、できるんですよね。
これ、できるんですよね。
テキトー教師DotAI 認定講師できます。ComfyUIだと「Apply ControlNet」ノードを数珠つなぎにして、前のノードが出力した条件付けを次のノードに渡す形になります。
チェーン接続と呼ばれてるやつです。
チェーン接続と呼ばれてるやつです。
室谷代表取締役ノードが増えると配線はカオスになるんですけど、その分どこで何を効かせてるかは見えるようになる。ブラックボックスで一発ドンよりは、僕は好みです。
テキトー教師DotAI 認定講師ただ、最初に戸惑うのが「重ねた瞬間に絵が硬くなる」パターンなんですよ。原因はだいたい、強度を全部盛ってしまっていることなんです。
チェーン接続で重ねる場合の強度バランス
室谷代表取締役強度って、それぞれ独立に考えればいいんですか。
テキトー教師DotAI 認定講師そこが落とし穴で。片方0.8、もう片方も0.8にすると、合計で1.6ぶんの縛りがかかる感覚になるんですよ。
まずは片方1.0、もう片方を0.3〜0.5あたりから試すと崩れにくいです。
まずは片方1.0、もう片方を0.3〜0.5あたりから試すと崩れにくいです。
室谷代表取締役あと、効かせるタイミングをずらせるんでしたっけ。
テキトー教師DotAI 認定講師「Apply ControlNet」のstart_percentとend_percentですね。拡散プロセスの何%から何%まで適用するかを指定できるので、構図は序盤で決めて、質感は後半で手を離す、みたいな芸当ができます。
SDXL版の扱いと、モデルを分ける必要性
室谷代表取締役SDXLでも同じことできるんですか。
テキトー教師DotAI 認定講師使えます。ただしSD1.5向けのモデルをそのまま持ってきても噛み合わないので、SDXL専用のControlNetモデルを別途ダウンロードする必要があります。
WebUIの拡張機能だとv1.1.4以降で対応しています。
WebUIの拡張機能だとv1.1.4以降で対応しています。
室谷代表取締役モデル群が世代ごとに分かれて配布されてるの、エコシステムとしては正直もどかしいんですよね。ユーザー側が「どの組み合わせが正解か」を覚えるコストを払う構造になってる。
テキトー教師DotAI 認定講師現場でよく聞くのも「SDXLにしたら急に効かなくなった」なんですよ。ファイル名に付いてる世代の表記を見る癖をつけると、外しにくくなります。
コードから重ねる場合はリストで渡す
室谷代表取締役プログラムから扱う場合も、発想は同じでいいんですか。
テキトー教師DotAI 認定講師diffusersだと、条件画像をリストで渡して、それぞれに対応するcontrolnet_conditioning_scaleも同じ順番のリストにする形です。加えて、すべての条件画像を生成サイズに先にリサイズしておく必要があります。
ここを飛ばすとサイズ不一致で落ちます。
ここを飛ばすとサイズ不一致で落ちます。
Pythonとdiffusersで動かす、プロンプト無しのGuess Modeまで
diffusersで読み込む、強度はスケール値で決まる
室谷代表取締役WebUIの画面でぽちぽちやるのと、Pythonで書くの、中身は同じなんですよね。diffusersなら ControlNetModel.from_pretrained() でモデルを読んで、パイプラインの controlnet= に渡すだけで終わる。
テキトー教師DotAI 認定講師そうですね。で、最初に戸惑うのが controlnet_conditioning_scale の値で。
0〜1くらいの範囲で、大きいほど条件に縛られる。まず1.0で試して「思ったより固い」となる人がすごく多いんですよ。
0〜1くらいの範囲で、大きいほど条件に縛られる。まず1.0で試して「思ったより固い」となる人がすごく多いんですよ。
室谷代表取締役うちの現場でも、いきなり最大値で回して「絵が死んだ」って言われるパターンが定番なんですよね。0.6とか0.7で一度出して、弱いなと思ったら上げる。
その順番のほうが結果的に早いんです。
その順番のほうが結果的に早いんです。
python
import torch
from diffusers import StableDiffusionControlNetPipeline, ControlNetModel

controlnet = ControlNetModel.from_pretrained("<controlnetモデルのID>", torch_dtype=torch.float16)
pipe = StableDiffusionControlNetPipeline.from_pretrained(
    "<ベースモデルのID>", controlnet=controlnet, torch_dtype=torch.float16
)

image = pipe(prompt="a photo of a room", image=canny_image,
controlnet_conditioning_scale=0.7).images[0]強度を上げる前に、条件画像そのものがきれいかを疑うのも大事で。エッジがガタガタだと、上げるほどガタガタが強調されるだけなんです。
プロンプト無しで生成するGuess Mode
室谷代表取締役で、Guess Modeですよ。テキストプロンプトを一切書かずに、条件画像だけ渡すやつ。
テキトー教師DotAI 認定講師初めて触る人が「本当に何も書かなくていいんですか」と必ず聞くところですね。ControlNet側が条件画像から内容を推測する実験的なモードで、推奨はサンプリング50ステップ、guidance scale 3〜5。
プロンプトで縛らないぶん、ガイダンスを上げすぎると崩れやすいんですよ。
プロンプトで縛らないぶん、ガイダンスを上げすぎると崩れやすいんですよ。
室谷代表取締役diffusers側の実装が面白くて、残差をブロックの深さに応じてスケーリングしてるんです。浅い層は0.1くらい、中間から深い層は1.0に近づけていく。
浅い層が制約しすぎないようにしている、と。
浅い層が制約しすぎないようにしている、と。
テキトー教師DotAI 認定講師だからプロンプト無しでも形になるんですね。構図だけ拾わせたいときの検証には向いてます。
WebUIの拡張からも試せますし、まずそこから入るのもありです。
WebUIの拡張からも試せますし、まずそこから入るのもありです。
SDXL・Fluxなど新しいモデルに組み込むときの注意
室谷代表取締役これ、SD1.5の話で終わらないんですよね。ControlNetはSDXL、Stable Diffusion 3、Flux、Hunyuan-DiTみたいな新しいところにも対応が広がってる。
テキトー教師DotAI 認定講師ただし世代は揃える必要があります。SDXL用のControlNetをSD1.5のパイプラインに入れても動かない。
ここで時間を溶かす人が多いんですよ。
ここで時間を溶かす人が多いんですよ。
室谷代表取締役あとdiffusersが「新規の制御生成ならControlNetを推奨」と書いているのは、判断としてわかりやすいんですよ。SD1.5世代向けの軽量な代替としてT2I-Adapterもあるけど、条件の効き方を細かく詰めたいならControlNet側に軍配が上がる。
テキトー教師DotAI 認定講師実装の手数は増えますけど、そのぶん制御の自由度が返ってくる感じですね。
複数のControlNetをコードで同時に渡す
室谷代表取締役最後に複数。CannyとDepthを同時に、みたいなやつ。
テキトー教師DotAI 認定講師コードだと、条件画像をリストで渡して、controlnet_conditioning_scaleも同じ順番でリストにする。この順番がずれてもエラーにならないので、気づきにくいんですよ。
室谷代表取締役あと地味なのが、すべての条件画像を生成サイズに事前リサイズしておくこと。サイズがバラバラだとそこで止まる。
テキトー教師DotAI 認定講師強度はそれぞれ別に振れるので、輪郭は強め、奥行きは弱め、みたいな配分ができます。1枚ずつ単体で効きを確認してから重ねるのが結局いちばん近道ですね。
広告・EC・ファッションでControlNetはどう効くのか
まとめ
広告・EC・ファッションでのControlNet活用ポイント
- ポーズ骨格(OpenPose)を条件画像として固定し、同じ姿勢のまま服だけ差し替えることで商品撮影の撮り直しを削減できる
- 広告ビジュアルはシリーズでポーズが揃うことが重要で、ControlNetは画風の道具というより撮影設計の道具として捉える
- ファッションでは服の形をCannyやDepthで押さえ柄や色だけ差し替え、撮影もモデルも介さず候補を大量に出せる
- QRコードは位置と角度を固定したまま装飾だけ変えられるが、読み取りは最終的に実機で確認が必要
- 何を固定したいか(服のシルエットか背景の構図か)を先に決めることで選ぶ条件が変わる
- いきなり本番フローに入れず、撮り直しが多い案件で試験的に使い削減工数を数字で見てROIが出てから横展開する
- 生成が速くても条件画像の準備やマスク作成がボトルネックになるため、撮影で撮るものと生成で済むものを分ける判断が要る
- 商用利用の可否や権利の扱いは案件ごとに異なり、公式情報を確認したうえでフローに組み込む
ポーズ指定で商品撮影のやり直しを減らす
室谷代表取締役前の章までで仕組みと環境構築の話をしたので、ここは「で、仕事だとどう使うの」の話を。商品撮影って、モデルさんの手の位置が前回と揃わないだけで撮り直しになるじゃないですか。
あれ、地味に一番高いんですよね。
あれ、地味に一番高いんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのがまさにそれで。ポーズの骨格を条件画像として渡せば、同じ姿勢のまま服だけ差し替える、みたいなことができるんですよ。
OpenPoseの骨格を固定するイメージですね。
OpenPoseの骨格を固定するイメージですね。
室谷代表取締役広告のビジュアルって、シリーズで並べたときにポーズが揃ってるかどうかで見え方が変わるんですよ。ControlNetは画風の道具というより、撮影設計の道具として見たほうがしっくりくる。
テキトー教師DotAI 認定講師たしかに。Xでも、EC用の商品カットをポーズ指定で量産してる、という投稿を見かけるようになりました。
イラストの遊びから、制作の実務側に寄ってきてる感じがします。
イラストの遊びから、制作の実務側に寄ってきてる感じがします。
バーチャル試着とQRコードデザインへの応用
室谷代表取締役ファッションだと試着の代替ですね。服の形をCannyやDepthで押さえて、柄や色だけ差し替える。
撮影もモデルも介さずに候補を大量に出せるので、企画の当たりを引くのが早くなるわけです。
撮影もモデルも介さずに候補を大量に出せるので、企画の当たりを引くのが早くなるわけです。
テキトー教師DotAI 認定講師初めて触る人が戸惑うのが、そこは「何を固定したいか」を先に決めるのがコツなんですよ。服のシルエットを固定したいのか、背景の構図を固定したいのかで、選ぶ条件が変わってきますので。
室谷代表取締役QRコードのデザインも同じ発想で、コードの位置と角度を固定したまま周囲の装飾だけ変える、みたいな使い方ができますね。読み取りを壊さずに案を並べられるのは大きい。
テキトー教師DotAI 認定講師ただ、読み取りは最終的に実機で確認が必要です。生成物は案として使って、仕上げは人の目で、という前提で考えておくのが安全ですね。
制作フローに組み込むときの現実的な線引き
室谷代表取締役経営目線で言うと、いきなり本番フローに入れないほうがいいんですよ。まずは撮り直しが一番多い案件で試験的に使って、削減できた工数を数字で見る。
そこでROIが出てから横に広げる。
そこでROIが出てから横に広げる。
テキトー教師DotAI 認定講師現場感覚で言うと、条件画像を用意する手間を軽く見積もりすぎる人が多いんですよ。元になる写真の準備やマスクの作成に、思ったより時間を持っていかれます。
室谷代表取締役そこなんですよね。生成が速くなっても、条件を整える工程がボトルネックになる。
だから全部を生成で作るんじゃなくて、撮影で撮るべきものと生成で済むものを分ける判断が要ります。
だから全部を生成で作るんじゃなくて、撮影で撮るべきものと生成で済むものを分ける判断が要ります。
テキトー教師DotAI 認定講師あと、商用利用の可否や権利の扱いは案件ごとに違います。使うモデルや素材の条件は公式の情報を確認したうえで、フローに組み込むのが前提だと思います。
よくある質問
Q1. ControlNetとLoRAはどう使い分けるんですか?
室谷代表取締役LoRAは「絵柄や人物を覚えさせる」もの、ControlNetは「構図やポーズを縛る」もの。役割がまるで違うので、並べて使うのも普通なんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのが「LoRAを入れたら構図が崩れた」という声で。そこにControlNetを足すと戻ってくるんですよ。
室谷代表取締役用意するものの差も大きいですね。LoRAは教師データを集める必要があるけど、ControlNetは画像1枚を渡せば効く。
始めるハードルの高さで言えば段違いです。
始めるハードルの高さで言えば段違いです。
テキトー教師DotAI 認定講師たしかに。先にControlNetで構図を固めて、足りない雰囲気をLoRAで補う。
この順番だと組み立てやすいですね。
この順番だと組み立てやすいですね。
Q2. ポーズも線画も合ってるのに、生成結果が全然言うことを聞きません。
テキトー教師DotAI 認定講師最初に戸惑うのがそこなんですよ。だいたいは「入力画像の解像度が荒い」か「適用の強さが弱すぎる」のどちらかです。
室谷代表取締役あとはプロンプトを盛りすぎて、ControlNetの指定を無視してるパターン。うちでも「指示を足すほど効かなくなった」という相談が来ます。
テキトー教師DotAI 認定講師そうなんですよね。まず強さを上げてみる、それでもダメなら入力画像をきれいにする。
この順番で切り分けると早いです。
この順番で切り分けると早いです。
Q3. ControlNetのモデルファイルはどこで手に入れればいい?
室谷代表取締役配布元はいくつかありますが、ライセンスがファイルごとに違うので、商用で使うなら先にそこを確認した方がいいです。あとから揉めるパターン、地味に多いんですよね。
テキトー教師DotAI 認定講師初めて触る人は、配布ページの説明を読まずに落としてきちゃうんですよ。業務で使うかどうかで選ぶものが変わるので、そこだけは最初に見てほしいです。
室谷代表取締役組織で回すなら、使ったファイル名とライセンスを残しておく。それだけで後の確認が一気に楽になります。
Q4. 動かすのに必要なPCスペックはどれくらい?
テキトー教師DotAI 認定講師現場感覚で言うと、普通に画像生成が動いているマシンなら大抵そのまま動きます。ControlNetは画像を1枚多く読ませるだけなので、負荷の増え方は控えめです。
室谷代表取締役ただし重ねるほど素直に重くなります。ROIで考えると、まず1枚で効果を確かめてから増やすのが一番無駄が少ないですね。
テキトー教師DotAI 認定講師たしかに。最初から全部盛りにすると、どこが効いてるのか分からなくなりますしね。
Q5. ローカルに環境を作らなくてもControlNetは使える?
室谷代表取締役使えます。クラウド上で動かすタイプのツールやサービスにも、同等の機能は入ってきてます。
手元のマシンを選ばずに試せるのは大きいですよ。
手元のマシンを選ばずに試せるのは大きいですよ。
テキトー教師DotAI 認定講師最初の1枚を見るだけなら、そっちの方が早いんですよ。環境構築で半日つぶして心が折れる、というのが一番もったいないので。
室谷代表取締役とはいえ業務で回すなら、手元か自前の環境に寄せた方がコストも情報管理も読みやすくなります。試すのはクラウド、回すのは手元。
この切り分けが現実的ですね。
この切り分けが現実的ですね。
まとめ
室谷代表取締役ControlNetは、これまで言葉でしか指定できなかった構図を、画像として渡せるようにした機能なんですよね。ここを押さえると生成の再現性が一気に上がります。
テキトー教師DotAI 認定講師そうなんですよね。まずは手持ちの1枚でCannyかDepthを試す。
それだけで「今まで言うことを聞かなかったのはこの部分だったのか」と分かります。
それだけで「今まで言うことを聞かなかったのはこの部分だったのか」と分かります。
室谷代表取締役順番としては、WebUIかComfyUIで1枚出せる状態を作ってから、重ねる話に進むのがいいですね。いきなり複数枚で組むと、原因の切り分けができなくなります。
テキトー教師DotAI 認定講師あと、入力画像を変えるだけで結果が変わるので、同じ設定のまま何枚か試すのがおすすめです。1枚で判断しちゃうともったいないので。
室谷代表取締役使いどころが見えてきたら、Pythonから呼ぶ形に広げれば自動化できます。まず1枚、そこからですね。