Pineconeとは?ベクトルデータベースの仕組みと強み
ベクトルデータベースは「意味の近さ」をどう扱うのか
 室谷代表取締役
ベクトルデータベースって、結局なにをやってるものなんですか。普通のDBと何が違うのか、そこから整理したいんですよね。
 テキトー教師DotAI 認定講師
ざっくり言うと、文章を数字の並びに変換して、その並びの距離で「意味が近い」を測るんですよ。「返品したい」と「商品を送り返したい」は単語が違っても、近い場所に置かれる仕組みです。
室谷代表取締役キーワードが一致してなくても引っかかる、と。検索の当たり方が根本的に違うわけですね。
テキトー教師DotAI 認定講師そうなんです。初めて触る人は「検索なのに単語が一致しないのが不安」と言うんですが、そこが狙いでもあるんですよね。
高次元のベクトルを保存してインデックス化し、近いものを高速に返す。それがベクトルDBの仕事です。
高次元のベクトルを保存してインデックス化し、近いものを高速に返す。それがベクトルDBの仕事です。
Pineconeの特徴はフルマネージドで運用を丸ごと任せられること
室谷代表取締役Pineconeは、そこをフルマネージドで提供している、と。自前でミドルウェアを立てるのと比べて何が変わるんです?
テキトー教師DotAI 認定講師現場感覚で言うと、インデックスの構築やリバランスを自分で回さなくていいのが大きいです。書き込みが増えても自動でならしてくれる、と公式が説明している部分ですね。
室谷代表取締役経営目線で言うと、そこは人件費に直結するんですよ。エンジニアが運用で張り付く時間を時給で換算すると、マネージドに寄せる判断はかなり早い段階で出ます。
テキトー教師DotAI 認定講師たしかに。あと米サンフランシスコのPinecone Systemsが提供していて、クラウドネイティブ前提の設計なんですよね。
RAG・レコメンド・エージェントの記憶を支える土台
室谷代表取締役用途としてはRAGがまず浮かぶんですが、それだけじゃないですよね。
テキトー教師DotAI 認定講師セマンティック検索、レコメンド、あとエージェントの会話履歴のような長期記憶ですね。LLMに毎回すべてを読ませる代わりに、必要な断片をここから引いてくる形です。
室谷代表取締役なるほど。LLMの手前にこの層を置くかどうかで、コストも精度も変わってくるわけだ。
テキトー教師DotAI 認定講師そうですね。最初はRAG用のDBとして入って、あとからレコメンドにも使い回す、みたいな広がり方をよく聞きます。
どんな企業が使っているのか
室谷代表取締役実績はどうなんですか。
テキトー教師DotAI 認定講師公式トップページだと、Adobe、Workday、L'Oréal、Microsoft、Mercado Libre、OpenAI、Cohere、Fox、The Washington Post あたりが名前を出しています。Asana、Cisco、Zapier、Sanofi、Vanguard も載っていますね。
室谷代表取締役業種が散らばっているのが面白いところで。メディア、小売、金融、製薬まで入っている。
ただ業界構造として言うと、OpenAIやクラウド各社がベクトル検索を自前で出すようになってきていて、専用DBの立ち位置はこれから問われるんですよね。
ただ業界構造として言うと、OpenAIやクラウド各社がベクトル検索を自前で出すようになってきていて、専用DBの立ち位置はこれから問われるんですよね。
テキトー教師DotAI 認定講師そこは選択肢として冷静に見たほうがいいですね。まずは無料枠で触って、自分のデータで効くか確かめるのが早いです。
Organization・Project・Index・Namespaceはどう関係している?
Pineconeの管理構造(入れ子の関係)
Organization
最上位。課金の単位
Project
Organizationの下。APIキーとインデックスをプロジェクト単位で管理
Index
Projectの下。データを保持する基本単位。新規はDocument Index、Vector Indexはレガシー扱い
Namespace
Index内の仕切り。マルチテナントや検索範囲の限定に使う
Document
JSONオブジェクト。_id・全文検索用テキスト・密ベクトル・疎ベクトルをまとめられる
Record
旧来のVector Index側のデータ単位。ベクトル1本とメタデータのシンプルな形
課金はOrganization、APIキーはProject単位
室谷代表取締役Pineconeの管理構造、最初にここを押さえないと請求を見たときに「え」ってなるんですよね。一番上がOrganizationで、これが課金の単位。
その下にProjectがあって、APIキーもインデックスもプロジェクト単位で管理される、という入れ子です。
その下にProjectがあって、APIキーもインデックスもプロジェクト単位で管理される、という入れ子です。
テキトー教師DotAI 認定講師初めて触る人がまず混同するのがそこで。構造としてはOrganizationの中にProjectがあるので、区別が曖昧なままキーを1本だけ作って、本番も検証も同じキーで回す、という進め方をしがちなんですよ。
室谷代表取締役それは経営目線だと地味に怖いところで。Projectを環境ごとに分けておけば、キーが漏れたときに止める範囲がそのProjectで済む。
1本で回していると影響範囲が一気に広がるんですよね。
1本で回していると影響範囲が一気に広がるんですよね。
テキトー教師DotAI 認定講師現場感覚でも、後から分けようとすると作り直しに近くなるので、最初に分けておくほうが楽です。
Indexはデータの入れ物、Namespaceは中の仕切り
室谷代表取締役で、Projectの下にあるのがIndex。これがデータを保持する基本単位で、新規で作るならDocument Index、昔ながらのVector Indexはレガシー扱いという整理になっています。
テキトー教師DotAI 認定講師NamespaceはそのIndexの中の仕切りです。顧客ごとにデータを分けたいマルチテナントの場面とか、検索範囲を限定したいときに使う。
別のIndexを立てるほどじゃないけど混ぜたくない、というときの分離区画ですね。
別のIndexを立てるほどじゃないけど混ぜたくない、というときの分離区画ですね。
室谷代表取締役ここは設計判断なんですよ。テナントごとにIndexを分けるのか、Namespaceで分けるのか。
Indexの数にはプランごとに上限があるので、上限に当たってから慌てるより先に決めておく話です。
Indexの数にはプランごとに上限があるので、上限に当たってから慌てるより先に決めておく話です。
テキトー教師DotAI 認定講師たしかに。Namespaceは絞り込みの意味でも効くので、検索の当たり具合の設計とセットで考えたほうがいいと思います。
DocumentとRecordは何が違うのか
室谷代表取締役最後に用語。DocumentはJSONオブジェクトで、_idに加えて、全文検索用のテキストフィールド、密ベクトル、疎ベクトルを1つのドキュメントにまとめられる。
Recordは旧来のVector Index側のデータ単位で、ベクトル1本とメタデータというシンプルな形です。
Recordは旧来のVector Index側のデータ単位で、ベクトル1本とメタデータというシンプルな形です。
テキトー教師DotAI 認定講師ここが一番ハマる人多いんですよ。ネット上の古い記事はRecord前提で書かれているので、それを真似すると今のDocument Indexと噛み合わない。
用語が違うというより、データの持ち方が違うんです。
用語が違うというより、データの持ち方が違うんです。
室谷代表取締役だから覚える順番としては、OrganizationがあってProject、その下にIndexとNamespace、中身がDocument。この入れ子さえ頭に入れば、公式ドキュメントのどこを読むかで迷わなくなります。
テキトー教師DotAI 認定講師そうですね。逆にここが曖昧なまま進むと、キーの権限もデータの分け方も後戻りになるので、最初の10分で整理しておく価値は大きいです。
2026年のPineconeはDocuments APIが標準。旧APIの知識はもう古い
1つのドキュメントに全文検索・密ベクトル・疎ベクトルを同居させる
室谷代表取締役2026年のPinecone、新規で作るなら Documents API と Document Index が標準なんですよね。ドキュメントはJSON形式で、_idに加えて全文検索用のテキスト、密ベクトル、疎ベクトルを1本にまとめられる。
テキトー教師DotAI 認定講師そこが一番イメージしにくくて。ベクトルを入れる箱だと思ってると、テキストも同じドキュメントに入るって感覚が湧かないんですよ。
室谷代表取締役密ベクトルは embed で文字列から自動生成もできますし、疎ベクトルも sparse_embed で作れる。前処理を全部外側でやらなくていいんです。
テキトー教師DotAI 認定講師なるほど、1ドキュメントで意味の近さとキーワード一致を両方持てる、と。設計の出発点がだいぶ変わりますね。
スコアリング方式はtext・dense_vector・sparse_embedから選ぶ
室谷代表取締役スコアの付け方も選べる。textがBM25の全文検索、query_stringがLuceneクエリ、あとは dense_vector、sparse_vector、embed、sparse_embed という並びです。
テキトー教師DotAI 認定講師初めて触る人は、どれを選べばいいかで止まりますね。ハイブリッドにしたいなら密と疎を両方持たせておく、という整理で合ってますか。
室谷代表取締役そうです。メタデータのフィルタも $and/$or/$not、$exists、$match_phrase あたりが効くので、絞り込みはPinecone側で閉じられます。
テキトー教師DotAI 認定講師アプリ側でごりごり絞ってた人は、そこを移すだけでかなり素直になるんですよね。
Pod・Collection・ServerlessSpecはレガシー分類になった
室谷代表取締役ここが日本語記事とのズレで。pinecone.init() して create_index() で pod_type を指定、ServerlessSpec や PodSpec、Pod や Collection といった概念は、公式ドキュメントではLEGACY分類に入ってるんですよ。
テキトー教師DotAI 認定講師現場でよく聞くのは「記事通りに書いたのに動かない」なんです。書いてある前提が Vectors API と Records API の世界なんですね。
室谷代表取締役新規プロジェクトでPodベースを選ぶ理由はもう無いんです。既存の資産を触るときだけレガシーを読めばいい。
テキトー教師DotAI 認定講師逆に言えば、これから始める人はレガシーを覚えなくていいってことですね。
古い記事のコードをそのまま写すとハマる理由
室谷代表取締役古い記事のコードを写すとハマる理由は、レイヤーが違うからなんですよ。レガシーはRecord、つまりベクトル1本+メタデータ。
新しいのはDocument。
新しいのはDocument。
テキトー教師DotAI 認定講師データの単位が違うので、引数の形も揃わないんですよね。エラーを見ても何が悪いのか分からなくて、そこで詰まる人が多いんですよ。
室谷代表取締役経営目線で言うと、この手の「動かない原因の調査」にエンジニアが半日溶かすのが一番もったいない。参照するドキュメントを新しくするだけで消えるコストですから。
テキトー教師DotAI 認定講師まずは公式ガイドを開いて、Document Index 前提で組み立てる。遠回りに見えて、たぶん一番速いルートですね。
Pineconeの始め方:アカウント作成からAPIキー取得、インデックス作成まで
まずはアカウント登録とAPIキーの取得から
室谷代表取締役まず大前提として、PineconeのアカウントとAPIキーがないと何も始まらないんですよね。キーはプロジェクト単位で発行されるので、誰がどのキーを持っているかの管理が地味に効いてきます。
テキトー教師DotAI 認定講師たしかに。初めて触る人はここで「OrganizationとProjectって何が違うんですか」で止まりがちです。
アカウントを作った時点でOrganizationができて、その中のProjectにキーがぶら下がる、という順番なんですよ。
アカウントを作った時点でOrganizationができて、その中のProjectにキーがぶら下がる、という順番なんですよ。
室谷代表取締役で、キーを取ったら環境変数に入れる。
ここをコードにベタ書きしちゃう人がいるんですけど、後で必ず後悔するのでやめたほうがいい・・・
export PINECONE_API_KEY="..." ですね。ここをコードにベタ書きしちゃう人がいるんですけど、後で必ず後悔するのでやめたほうがいい・・・
テキトー教師DotAI 認定講師現場でもそこは最初に声をかけますね。キーは発行直後に控えておくのが安全です。
画面の細かい文言や位置は公式のクイックスタートで確認するのが確実ですよ。
画面の細かい文言や位置は公式のクイックスタートで確認するのが確実ですよ。
AIコーディングエージェントのプラグインで対話的に立ち上げる
AIコーディングエージェントのプラグインでPineconeを立ち上げる手順
- 01APIキーを環境変数に入れるexport PINECONE_API_KEY="..." を実行する
- 02プラグインをインストールclaude plugin install pinecone を実行する(Anthropicの公式マーケットプレイスへのアクセスが必要。Claude Codeなら初回起動時に自動で追加される)
- 03Claude Codeを再起動する再起動を挟まないとコマンドが反応しないことがある
- 04quickstartを実行する/pinecone:quickstart を実行し、対話に沿ってスキーマ設計・データ投入・初回検索まで進める
export PINECONE_API_KEY="..."でAPIキーを環境変数に入れるclaude plugin install pineconeを実行する(Anthropicの公式マーケットプレイスへのアクセスが必要。Claude Codeなら初回起動時に自動で追加される)- Claude Codeを再起動する
/pinecone:quickstartを実行し、対話に沿ってスキーマ設計・データ投入・初回検索まで進める
テキトー教師DotAI 認定講師この流れ、手を動かす量がかなり少ないんですよ。プラグインを入れてquickstartを叩くと、スキーマをどうしますか、みたいな問いに答えていくだけで最初の検索まで着地します。
室谷代表取締役これ、業界構造としてはけっこう大きい話で。ベクトルDBの導入障壁って「設計が難しい」だったのが、「対話で決められる」に変わってきてるんですよね。
CursorやCodexでも同じことができるので、エディタから離れずに済む。
CursorやCodexでも同じことができるので、エディタから離れずに済む。
テキトー教師DotAI 認定講師最初に戸惑うのが、プラグインを入れた直後にコマンドが反応しないパターンです。再起動を挟むのを忘れがちなので、そこだけ注意ですかね。
室谷代表取締役あとはquickstartが作った設定をそのまま本番に持っていかないこと。まず検証用のプロジェクトで試すのが無難です。
手動で始める場合の3つの経路
室谷代表取締役プラグインを使わない場合は、手持ちのデータの形で経路が分かれるんですよね。ここを読み違えると前処理だけが増えて、検証が進まない。
テキトー教師DotAI 認定講師分け方はシンプルです。テキストやファイルがあるなら、Pinecone Inferenceでチャンク化・埋め込み・インデックス化までまとめて任せる。
すでに埋め込みが手元にあるなら、ベクトルをそのままupsertする。
すでに埋め込みが手元にあるなら、ベクトルをそのままupsertする。
テキトー教師DotAI 認定講師3つめが、SKUやIDみたいな固有の語句で探したいケースです。この場合は全文検索(BM25)前提でインデックスを作る、という選び方になります。
室谷代表取締役で、実際は「両方やりたい」がほとんどなんですよ。全文検索用のテキストと密ベクトルを同じドキュメントに持たせられるので、最初から欲張った設計でいいと思います。
最初のインデックスを作るときに決めておくこと
室谷代表取締役最初のインデックス、名前とディメンション以外に何を決めておくべきですかね。
テキトー教師DotAI 認定講師先に決めるのが、どのスコアリング方式で引くかです。text(BM25)、query_string、dense_vector、sparse_vector、embed、sparse_embedから選ぶことになるので、検索の入り口を想像しておくと迷いません。
室谷代表取締役あとネームスペースの切り方。マルチテナントで分けるのか、検索範囲を絞るために分けるのかで設計が変わる。
後から作り直すのは地味に痛いので、ここは最初に決めたほうがいい。
後から作り直すのは地味に痛いので、ここは最初に決めたほうがいい。
テキトー教師DotAI 認定講師現場感覚だと、まず小さく1つ作って検索を1回叩いてみるのが一番早いです。作り込んでから「思ってた結果と違う」が一番もったいないので。
データ登録(upsert)と検索(query)、メタデータの絞り込みはどうやる?
テキストを渡すか、埋め込みを渡すかの2通り
室谷代表取締役登録の話からいきましょうか。いまのPineconeってドキュメント形式で、JSONの中に_idと、全文検索用のテキスト、密ベクトル、疎ベクトルを1個のドキュメントとしてまとめて入れられるんですよね。
テキトー教師DotAI 認定講師たしかに。で、初めて触る人が最初に迷うのが、ベクトルを自分で作って入れるのか、テキストを渡すだけでいいのか、そこの判断なんですよ。
室谷代表取締役テキストを渡せば、チャンク化から埋め込みまでPinecone側でやってくれる。すでに手元に埋め込みがあるなら、そのベクトルを直接入れる。
この2択で捉えると整理しやすい。
この2択で捉えると整理しやすい。
テキトー教師DotAI 認定講師現場でよく聞くのは「チャンクをどう切るか」で止まるケースですね。テキストを任せられる経路なら、そこも含めて持っていけるので検証の初速は出ます。
検索のときに指定するスコアリング方式
室谷代表取締役検索側は、どの方式でスコアを付けるかを指定する形になっていて。BM25の全文検索、Luceneクエリ、密ベクトル、疎ベクトル、それとテキストから埋め込みを生成する方式まで選べます。
テキトー教師DotAI 認定講師意味で探したいのか、語句そのもので探したいのかで選ぶイメージですね。型番やSKUみたいな固有の文字列は、ベクトルより全文検索のほうが素直に当たります。
室谷代表取締役実務だと片方に寄せないほうがよくて。意味の近さとキーワード一致を両方効かせる前提で組んでおくと、後から精度を詰めやすいんですよ。
テキトー教師DotAI 認定講師片方だけで作ると、調整しようとしたときに構造ごと入れ替える話になりますからね。
メタデータフィルタで絞り込むときの書き方
室谷代表取締役メタデータの絞り込みは条件を組み合わせる書き方で、$and、$or、$not、フィールドの有無を見る$exists、フレーズ一致の$match_phraseあたりが使えます。
テキトー教師DotAI 認定講師ここ、ハマる人多いんですよ。ベクトルだけで引くと「意味は近いけどカテゴリ違い」が普通に混ざるので、絞り込みを効かせておくと結果の体感が変わります。
室谷代表取締役フィルタを後付けにすると、テストのときだけ綺麗に見えて本番で崩れる。最初から条件込みで測っておくべきところですね。
テキトー教師DotAI 認定講師あと$existsを入れておくと、必須のはずの項目が抜けてるデータに気づけます。地味ですが効きますよ。
Namespaceでテナントや用途ごとに検索範囲を分ける
室谷代表取締役最後にNamespace。インデックスの中を区画で分ける仕組みで、顧客ごと、用途ごとに検索範囲を切れるんですよね。
テキトー教師DotAI 認定講師マルチテナントで使うならほぼ必須ですね。区画を分けずに全部同じ場所へ入れると、別の顧客のデータが検索結果に顔を出しますから。
室谷代表取締役Indexを分けるほどでもない単位ならNamespace、という判断になる。ただプランごとに作れる数に上限があるので、テナントの切り方は最初に決めておかないと、後の移行が地味に重い作業になります。
テキトー教師DotAI 認定講師最初の設計で決め打つところですね。ここはケチらず時間を使ったほうがいいと思います。
料金は4プラン構成。無料のStarterでどこまでできる?
Starterは無料、ただし使える範囲は限られる
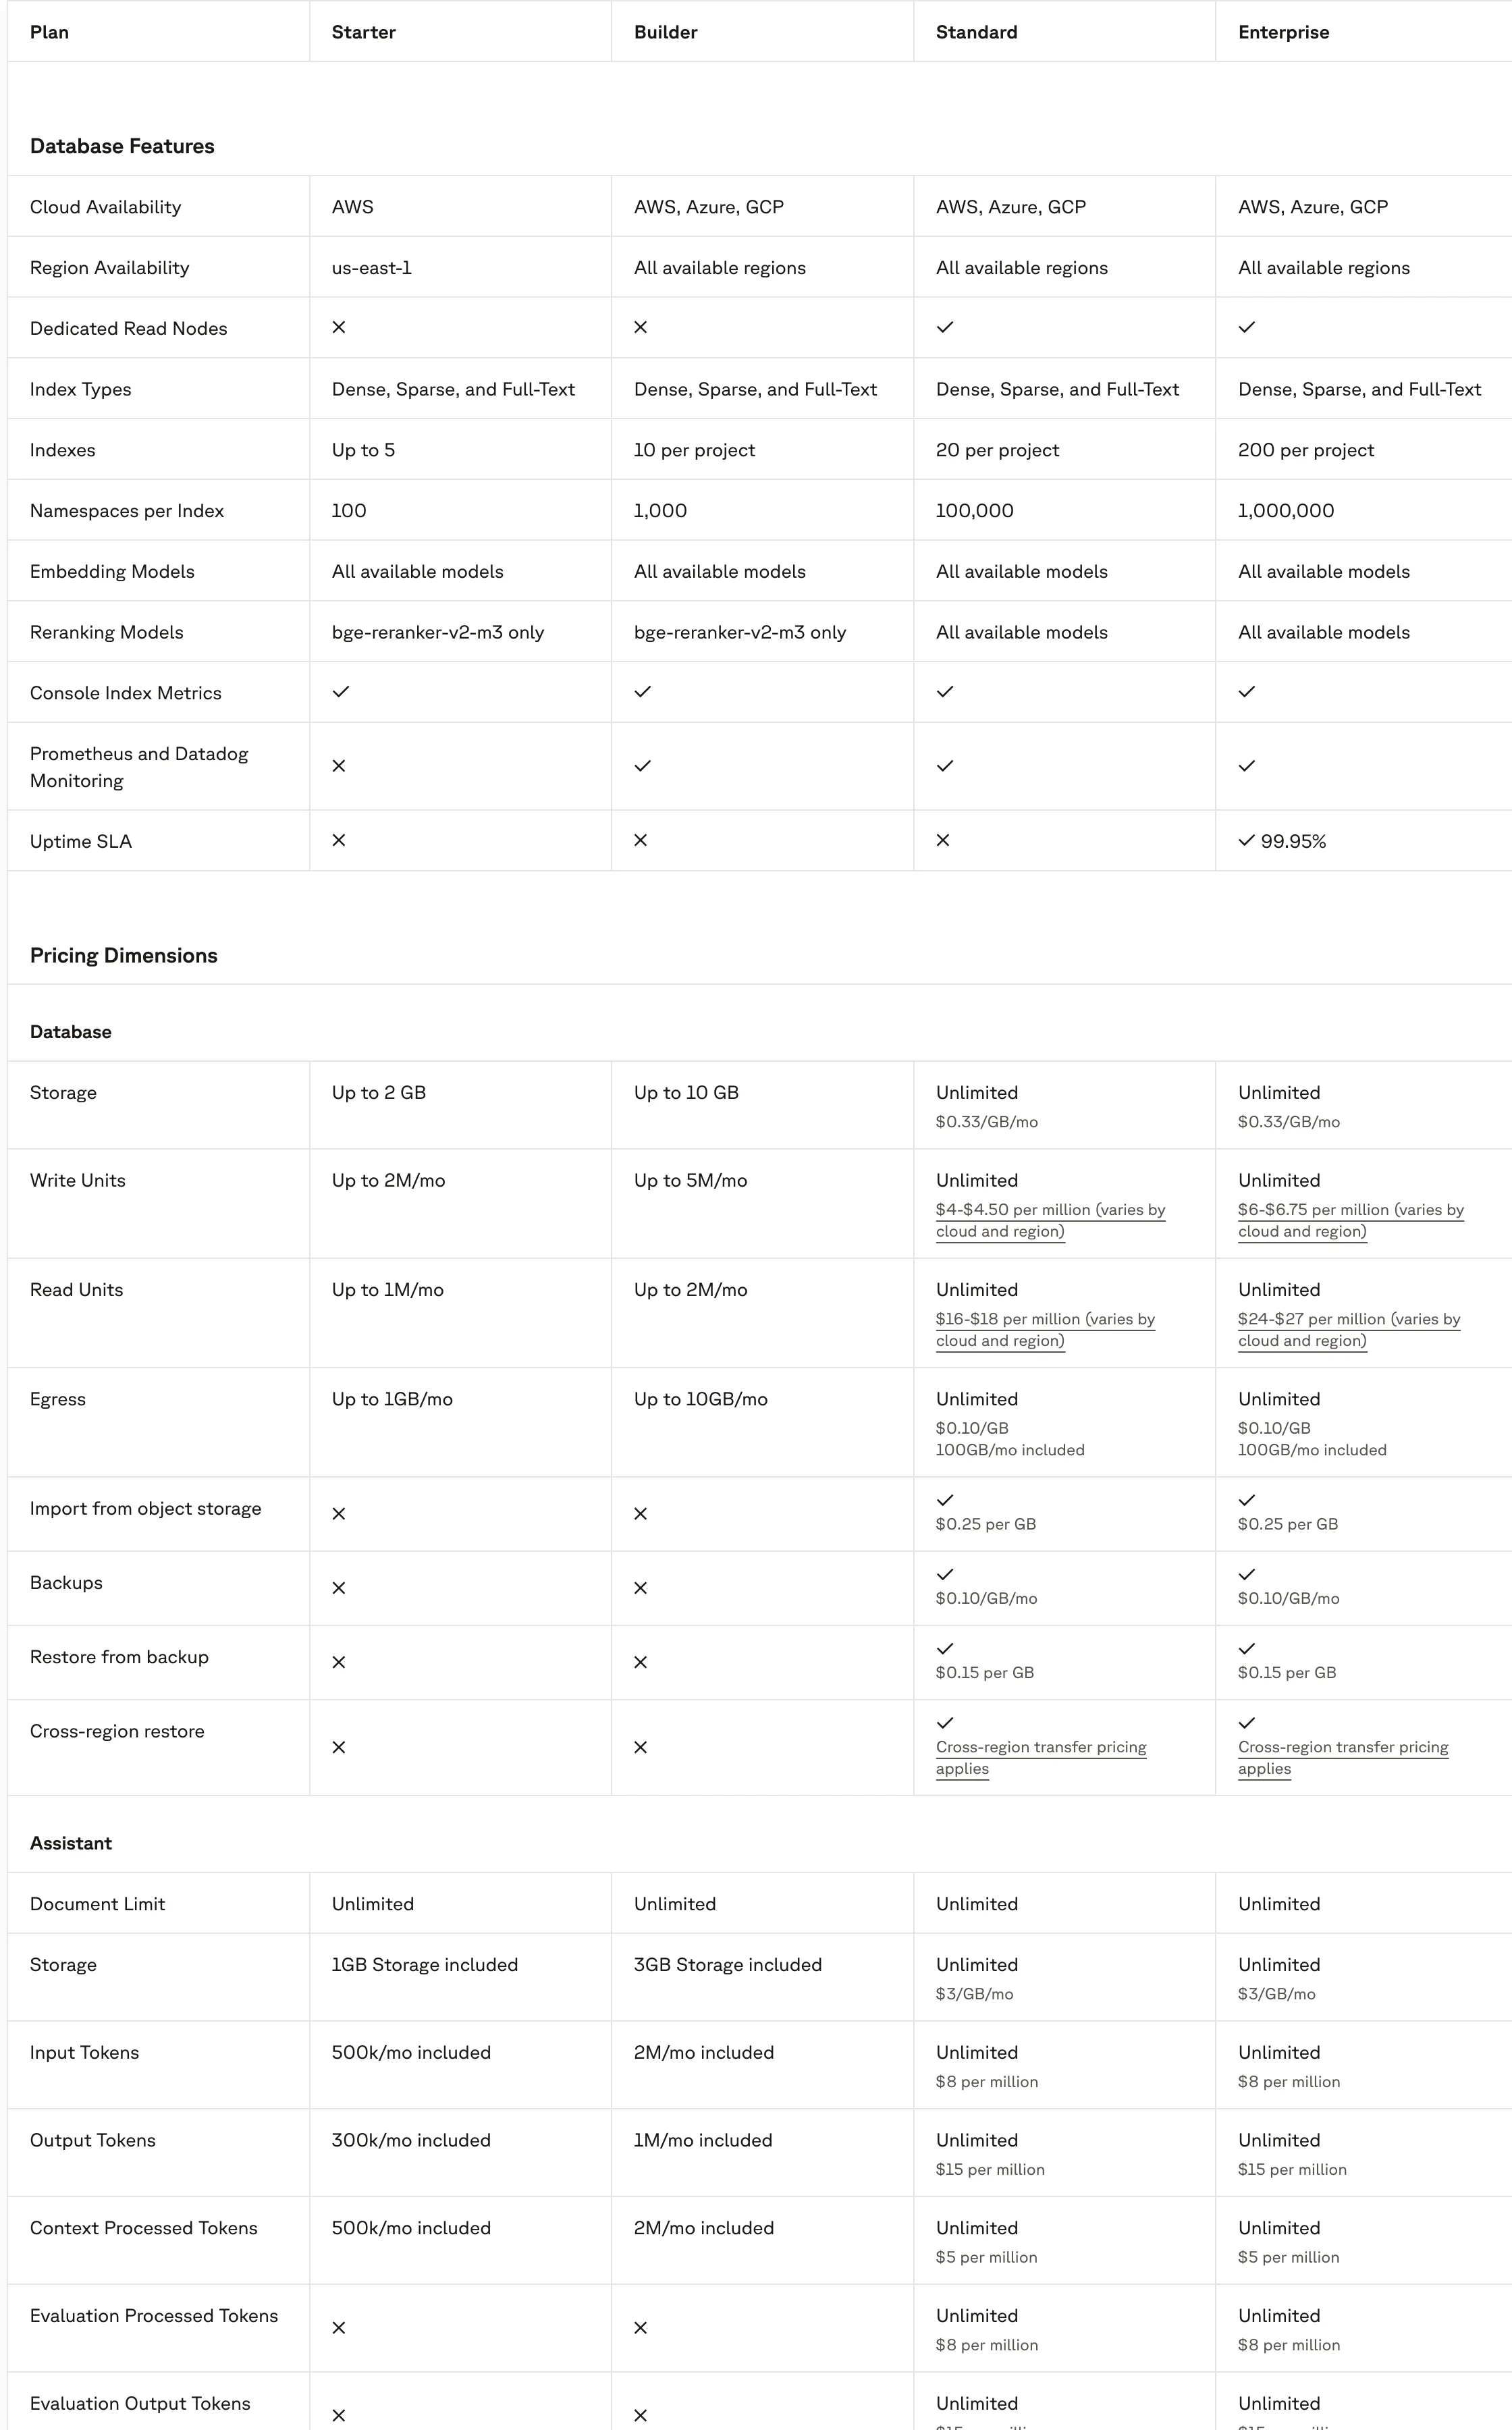
室谷代表取締役まず全体像を並べるとこうなります。細かい単価はこのあと個別に見ていきますね。
| プラン | 月額 | 主な上限 | 想定 |
|---|---|---|---|
| Starter | 無料 | ストレージ2GB / Write 200万 / Read 100万 | 検証・試用 |
| Builder | $20固定 | 10GB / Write 500万 / Read 200万 | 個人〜小規模 |
| Standard | 最低$50・従量 | 上限なし、使った分だけ加算 | 本番 |
| Enterprise | 最低$500 | 上限なし+SLA・BYOC | ミッションクリティカル |
テキトー教師DotAI 認定講師初めて触る人はまず無料で試すところから入るので、Starterの天井が気になりますよね。ストレージ2GBに書き込み200万、読み取り100万。
で、クラウドはAWSのみ、リージョンもus-east-1固定なんですよ。
で、クラウドはAWSのみ、リージョンもus-east-1固定なんですよ。
室谷代表取締役ここが地味に効くポイントで。本番を別リージョンに置きたいなら、Starterは最初から選択肢に入らないんですよね。
Indexが5個まで、Namespaceが100まで、サポートはDiscordのコミュニティのみ。個人の検証には十分ですが、チームで触り始めるとすぐ窮屈になります。
Indexが5個まで、Namespaceが100まで、サポートはDiscordのコミュニティのみ。個人の検証には十分ですが、チームで触り始めるとすぐ窮屈になります。
Builderは月20ドル固定の新しい入口
室谷代表取締役そこを埋めるのがBuilderで、月20ドルの固定なんですよ。ストレージ10GB、書き込み500万、読み取り200万、Egressが10GB。
クラウドとリージョンが選べて、複数プロジェクト・複数ユーザー、Prometheus/Datadog連携まで付いてきます。
クラウドとリージョンが選べて、複数プロジェクト・複数ユーザー、Prometheus/Datadog連携まで付いてきます。
テキトー教師DotAI 認定講師現場でよく聞くのは「個人開発で月20ドルは高いのか」というところで。監視連携と複数プロジェクトが付いてくるなら、環境を分けて検証する人には逆に安いという感覚ですね。
室谷代表取締役経営目線で言うと、20ドルって要は1時間の人件費より安いんですよ。環境分離で事故を1回防げば余裕でペイする。
固定費で読み切れるのは、費用対効果の計算がしやすいという意味でも大きいです。
固定費で読み切れるのは、費用対効果の計算がしやすいという意味でも大きいです。
Standardは月50ドル最低の本番向け
テキトー教師DotAI 認定講師本番が見えてくるとStandardで、最低50ドルから使用量課金、3週間のトライアルで300ドル分のクレジットが付くんですね。単価の並びを見ると、ストレージが$0.33/GB/月、書き込みが100万あたり$4〜$4.50、読み取りが$16〜$18で、Egressは100GBまで込み。
室谷代表取締役読み取りの単価が書き込みの4倍前後あるのがポイントで。検索中心のプロダクトは原価が読み取り側で決まるんですよ。
ここを見ずに着地すると、月末に請求書を見て「えっ」となる。
ここを見ずに着地すると、月末に請求書を見て「えっ」となる。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこです。書き込みはバッチだから読めるけど、読み取りはユーザーの操作で増える。
プロダクトの作りがそのまま原価になるので、設計段階で読む回数を意識しておくといいですね。
プロダクトの作りがそのまま原価になるので、設計段階で読む回数を意識しておくといいですね。
EnterpriseとBYOCはここから先の話
室谷代表取締役Enterpriseは最低500ドルで、稼働率99.95%のSLA、プライベートエンドポイント、顧客管理の暗号鍵、監査ログ、SCIM、SAMLロール、HIPAA準拠まで付いてきます。Indexは200、Namespaceは100万。
BYOCは自社クラウド内で運用する形で、こちらは問い合わせになります。
BYOCは自社クラウド内で運用する形で、こちらは問い合わせになります。
テキトー教師DotAI 認定講師個人で触っているうちは縁遠いんですが、社内の稟議でセキュリティ要件が出た瞬間にここが一気に効いてくるんですよね。要件を確認してからプランを選ぶ順番が大事だと思います。
埋め込み・リランキングの従量課金も見ておく
4プラン比較(料金・上限・サポート)
| 項目 | Starter | Builder | Standard | Enterprise |
|---|---|---|---|---|
| 月額 | 無料 | $20固定 | 最低$50・従量 | 最低$500・従量 |
| ストレージ | 2GB | 10GB | 上限なし($0.33/GB/月) | 上限なし($0.33/GB/月) |
| Write Units | 200万/月 | 500万/月 | 上限なし($4〜$4.50/100万) | 上限なし($6〜$6.75/100万) |
| Read Units | 100万/月 | 200万/月 | 上限なし($16〜$18/100万) | 上限なし($24〜$27/100万) |
| クラウド/リージョン | AWSのみ・us-east-1固定 | 全クラウド・全リージョン | 全クラウド・全リージョン | 全クラウド・全リージョン |
| Index数 | 最大5 | 10/プロジェクト | 20/プロジェクト | 200/プロジェクト |
| Namespace数 | 最大100 | 最大1,000 | 最大10万 | 最大100万 |
| 複数プロジェクト/ユーザー | × | ○ | ○ | ○ |
| 監視連携(Prometheus/Datadog) | × | ○ | ○ | ○ |
| SLA・BYOC | × | × | × | ○(99.95%・BYOC) |
| サポート | Discordコミュニティのみ | 無料サポート付き | 無料サポート付き | Proサポート込み |
| 想定 | 検証・試用 | 個人〜小規模 | 本番 | ミッションクリティカル |
テキトー教師DotAI 認定講師データベースの料金だけ見て見積もると崩れるのが、埋め込みとリランキングの側なんですよ。llama-text-embed-v2が100万トークンあたり$0.16、multilingual-e5-largeとpinecone-sparse-english-v0が$0.08。
リランキングは1,000リクエストあたり$2です。
リランキングは1,000リクエストあたり$2です。
室谷代表取締役しかもStarterとBuilderは月間の無料枠があって、Standard以上は無制限利用の従量課金という建て付けなんですよね。つまり上位プランに上げるほど、DBと推論の両方が同時に動く構造になっている。
テキトー教師DotAI 認定講師なので最初から両方並べて試算しておくのがおすすめです。DB側だけ見て「安い」と判断して、埋め込みで想定が崩れるケースは多いので。
料金や上限は変わるので、契約前に公式の料金ページで最新値を確認しておいてください。
料金や上限は変わるので、契約前に公式の料金ページで最新値を確認しておいてください。
pgvector・Qdrant・Weaviateとの違い、リレーショナルDBとどう使い分ける?
フルマネージドに寄せるか、自前で運用するか
ベクトルDBの選定フロー
PostgreSQLはすでに稼働しているか?
YES / はい
- pgvectorで足りる範囲を検討
- ベクトル件数・レイテンシ要求が跳ね上がったら専用DBを検討
NO / いいえ
- Qdrant・Weaviate・Milvus・Chroma等を比較
- 最初の検証は自前で軽く回す
- 本番が見えたらマネージドに寄せる
室谷代表取締役これは結局、運用を誰が持つかという話なんですよね。自前でベクトルDBを立てると、インデックス再構築やスケール時のリバランスを自分たちで見ることになる。
時給で換算すると、エンジニアの時間をそこに張り付ける判断はなかなかしんどいんですよ。
時給で換算すると、エンジニアの時間をそこに張り付ける判断はなかなかしんどいんですよ。
テキトー教師DotAI 認定講師現場感覚で言うと、最初の検証は自前で軽く回して、本番が見えてきたらマネージドに寄せる流れが多いですね。選択肢としては Qdrant、Weaviate、Milvus、Chroma あたりの名前がよく挙がります。
PostgreSQL をすでに使っているなら pgvector という発想も自然に出てきます。
PostgreSQL をすでに使っているなら pgvector という発想も自然に出てきます。
室谷代表取締役そうなんですよね。Postgres が既に回っているなら、pgvector で足りる範囲はかなりある。
ベクトルの件数やレイテンシの要求が跳ね上がったタイミングで初めて専用DBを検討する、という順番が現実的だと思います。
ベクトルの件数やレイテンシの要求が跳ね上がったタイミングで初めて専用DBを検討する、という順番が現実的だと思います。
テキトー教師DotAI 認定講師最初から専用DBを選ぶと、運用の学習コストもセットで背負うことになるんですよ。データが小さいうちは、その差が見えにくいんですけどね。
構造化データはリレーショナルDBに残して併用する
室谷代表取締役ここ、誤解されやすいところで。Pinecone はベクトルの保存と検索に特化した専用DBなので、複雑な JOIN や ACID トランザクションを期待する場所ではないんですよね。
Oracle の記事でも、多くの組織は Pinecone とリレーショナルDBを併用していると指摘されています。まあ Oracle 自身が自社DBを推したい立場なので、その点は差し引いて読むべきですけど。
Oracle の記事でも、多くの組織は Pinecone とリレーショナルDBを併用していると指摘されています。まあ Oracle 自身が自社DBを推したい立場なので、その点は差し引いて読むべきですけど。
テキトー教師DotAI 認定講師たしかに。注文・在庫・請求みたいに絶対に壊れてはいけないデータは RDB に置いたままにして、検索の入り口だけベクトル側に持たせる。
ID で突き合わせる形ですね。
ID で突き合わせる形ですね。
室谷代表取締役そうです。ベクトルDBに正解を持たせず、あくまで候補を出す係にする。
そう決めておけば、障害が起きたときの影響範囲も説明しやすいんですよ。
そう決めておけば、障害が起きたときの影響範囲も説明しやすいんですよ。
テキトー教師DotAI 認定講師メタデータの絞り込みである程度は候補を狭められますけど、集計や整合性の保証まで任せるのは無理がある。その前提で設計しておくと安心ですね。
2026年の競争環境とPineconeの位置
室谷代表取締役業界構造で見ると、2025年8月に身売り検討の報道があったり、OpenAI やクラウド各社がベクトル検索を自前で提供し始めたりして、専用DBという立ち位置の価値はかなり問い直されています。
テキトー教師DotAI 認定講師現場でも、クラウドの標準機能で足りるのではという声はよく聞きます。ただ、マネージドであることの楽さと、無料枠ですぐ試せる手軽さは依然として強みで、そこが選ばれる理由なんですよね。
室谷代表取締役だから比較表の数字だけで決めるより、運用を外に出せるか、データをどこに置けるかで見たほうがいい。先ほど見た通り有料プランは月20ドルからなので、判断にかかるコストはそこまで高くないんですよ。
テキトー教師DotAI 認定講師最初の一歩としては妥当ですね。乗り換える前提で、データを持ち出しやすいかも一緒に確認しておくと後悔が少ないです。
Pinecone Nexus・pg_pineconeなど新しめの製品と、実際の用途
Pinecone AssistantとNexusは何を楽にするのか
室谷代表取締役まず製品ラインの整理から。Pinecone Inferenceは埋め込みとリランキングをPinecone基盤上で呼べるサービス、AssistantはRAGチャットやエージェントアプリを素早く組むためのマネージドサービス。
で、Nexusがエージェント向けの知識エンジンなんですよね。
で、Nexusがエージェント向けの知識エンジンなんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのが「RAGを組んだはいいけど、検索結果をLLMに読ませる段でトークンが膨らむ」という声なんですよ。Nexusは企業データを一度コンパイルして1回のクエリで返す形で、検索・組み立て・推論をLLMから外に出す発想ですね。
室谷代表取締役公式が挙げてるのが、agentic RAGに比べてトークンが最大97%少なく、最大30倍速く、精度が最大94%向上という主張。これ原価に直撃する話なので、経営目線だと一番刺さるんですよね。
ただ現状はrequest trialなので、誰でもすぐ触れるわけではない。
ただ現状はrequest trialなので、誰でもすぐ触れるわけではない。
テキトー教師DotAI 認定講師そこは誤解されやすいところですね。「出たんだ、じゃあ使おう」ではなく、まず相談して枠を取る必要がある、と。
pg_pinecone拡張というPostgreSQLの選択肢
室谷代表取締役もう一つ、最近発表されたのがpg_pinecone拡張というオープンソースのプロジェクトです。PostgreSQLにPineconeの検索機能を組み込む方向のものなんですね。
テキトー教師DotAI 認定講師なるほど。現場でよく出るのが「できればDBを増やしたくない」という空気なんですよ。
Postgresの運用に乗せられるなら、新しいミドルウェアを覚えるコストがかなり下がります。
Postgresの運用に乗せられるなら、新しいミドルウェアを覚えるコストがかなり下がります。
室谷代表取締役とはいえ出たばかりなので、うちでは本番採用の判断はまだしません。検証環境で触って、どこまでPostgres側の使い勝手のまま行けるかを見る段階ですね。
テキトー教師DotAI 認定講師たしかに。既存のPostgres前提のチームほど、まずここから試すのが入りやすい気がします。
業界別のユースケースはどこまで広がっているか
室谷代表取締役実際どこで使われてるかというと、公式トップにはAdobe、Workday、Microsoft、OpenAI、Cohere、Fox、The Washington Post、Cisco、Zapier、Sanofi、Vanguardあたりが導入企業として並んでます。
テキトー教師DotAI 認定講師業種がバラけてるのが面白いんですよ。用途を並べるとこういうイメージです。
| 領域 | 使い方 |
|---|---|
| Eコマース・小売 | 商品レコメンド、ビジュアル検索 |
| 金融 | 不正検知、リスク評価 |
| サイバーセキュリティ | 脅威検知 |
| 製造業 | 品質管理、予知保全 |
| ヘルスケア | 医用画像解析 |
| メディア・テック | コンテンツレコメンド、高度な検索 |
室谷代表取締役現場の実例だと、Slackやメール、Google Driveのドキュメントをメタデータ付きで入れてエージェントに参照させる、みたいな使い方が増えてます。業界構造で言うと、OpenAIやクラウド各社がベクトル検索を自前で出すようになって、専業DBの立ち位置は変わってきてるんですよね。
テキトー教師DotAI 認定講師選択肢が増えたぶん、「何でもPinecone」ではなく、どこを任せるかを決める話になってきた感じがします。
導入前に確認しておきたい注意点
室谷代表取締役導入前に確認したいのは、Nexusがrequest trialだという点と、pg_pinecone拡張がまだ出たばかりという点。あとはInferenceやリランキングが従量課金なので、そこは前述の料金の話と地続きです。
テキトー教師DotAI 認定講師初めて触る人が見落としがちなのが、AssistantとNexusとDatabaseを同じ箱だと思ってしまうことなんですよ。できることが違うので、先に「何を楽にしたいのか」を一行で書いてから選ぶと迷いません。
室谷代表取締役そうですね。MYUUUの現場でも、ツール選定の前に「どの工程を削るのか」を先に決めるようにしてます。
そこが曖昧なまま契約すると、だいたい使われずに終わる。
そこが曖昧なまま契約すると、だいたい使われずに終わる。
テキトー教師DotAI 認定講師そこは痛感しますね。導入してから使い道を探すと、誰も触らなくなるんですよ。
よくある質問
Q1. 社内ドキュメントをそのまま放り込めば検索できる?
テキトー教師DotAI 認定講師ここ、最初のつまずきなんですよ。PDFを丸ごと入れると、検索は当たるのに返ってくる内容がぼやける。
長い文章は細かく刻んでから入れる必要があるんです。
長い文章は細かく刻んでから入れる必要があるんです。
室谷代表取締役刻み方の設計で精度が決まるって話ですよね。ここを適当にやると、後から全部入れ直しになるので地味に痛い。
テキトー教師DotAI 認定講師現場でよく聞くのは「分割の単位を何にするか」で止まるパターンです。見出し単位か段落単位か、先に決めておくと楽になりますよ。
Q2. Pineconeを入れればRAGは完成する?
室谷代表取締役これ、よく誤解されるんですけど、Pineconeは「似たものを探してくる」ところだけ担当するんですよね。文章を組み立てて答えるのは別の役割。
テキトー教師DotAI 認定講師たしかに。初めて触る人は「検索結果をそのまま出せば答えになる」と思いがちなんですけど、そこは繋ぎ込む工程が要ります。
室谷代表取締役パイプラインの一部品なんですよ。全体の流れを先に描いておかないと、後で繋ぎ直しになる・・・
Q3. インデックスを作り直したくなったら? データの入れ直しは?
テキトー教師DotAI 認定講師作り直しは普通に起きます。分割の仕方を変えたくなったり、扱うデータの種類が増えたり。
室谷代表取締役なので元データはPineconeの外にちゃんと持っておく。ここを忘れると詰むんですよね。
テキトー教師DotAI 認定講師登録する処理をスクリプトにしておくだけで、やり直しが一晩で終わるか一週間かかるかの差になります。
Q4. セキュリティ面は何を確認すればいい?
室谷代表取締役機密文書を預ける前提なら、最初に確認する項目ですよね。契約の形とか、データがどこに置かれるとか。
テキトー教師DotAI 認定講師現場感覚で言うと、導入ありきで進むより先に、社内の情報管理ルールに照らす作業が要ります。ここは技術より調整の話になりがちなんですよ。
室谷代表取締役この辺は更新されるので、公式の最新情報を見るのが確実。記事の内容を鵜呑みにしないほうがいいです。
Q5. 特定ベンダーにロックインされないか心配
テキトー教師DotAI 認定講師気になりますよね。ベクトル検索はまだ各サービスで書き方が違うので、乗り換えコストはゼロじゃないです。
室谷代表取締役ただ構造は「入れて、似たものを引く」で共通なんですよ。元データと変換処理を自前で持っておけば、移行は現実的です。
テキトー教師DotAI 認定講師最初から完璧に抽象化しろとは言わないですけど、生のAPI呼び出しをあちこちに散らかさないだけでも全然違います。
まとめ
室谷代表取締役というわけで、Pineconeは「ベクトルで探す」部分をマネージドで任せる選択肢なんですよね。自前で運用する手間を買うイメージです。
テキトー教師DotAI 認定講師たしかに。最初の一歩は、小さなデータを入れて検索を一回通してみるのが一番早いと思います。
挙動が見えると、設計の議論が一気に具体的になりますから。
挙動が見えると、設計の議論が一気に具体的になりますから。
室谷代表取締役経営目線だと、試す段階で「これで業務のどこが速くなるのか」を先に決めておくのが大事なんですよ。検証だけ走って効果測定がないまま終わるのが、一番もったいないパターンなので。
テキトー教師DotAI 認定講師あと、料金体系もAPIの仕様も変わりやすいので、実際に作り始める前に公式ドキュメントで最新を確認してください。この記事は2026年時点の整理、という前提で読んでもらえると助かります。
室谷代表取締役小さく触って手応えを見る、そこから本番設計に進む。その順番が安全なんですよね。