Unslothとは?ローカルでLLMを動かせる無料アプリの正体
ひとことで言うと、何ができるツールなのか
 室谷代表取締役
Unsloth、ひとことで言うと「ローカルでLLMを動かす」と「自分のデータでモデルを鍛える」が両方できて、しかも無料で使える一式なんですよね。
 テキトー教師DotAI 認定講師
そうなんです。ただ初めて触る人が最初に戸惑うのが、これって実行ツールなのか学習ツールなのか、看板が二つあるように見えるところで。
室谷代表取締役中では繋がってるんですよ。手元のモデルを試す、いまいちなら自分のデータで調整する、また動かす。
この往復が同じ環境で完結する。モデルを配る側のサービスではなく、手元で閉じたい人向けの道具なんですよね。
この往復が同じ環境で完結する。モデルを配る側のサービスではなく、手元で閉じたい人向けの道具なんですよね。
テキトー教師DotAI 認定講師そこは大きいですね。現場でよく聞くのは「APIに投げたくないデータがある」という理由。
手元で完結する選択肢があるだけで、社内の稟議の通り方が変わってきますから。
手元で完結する選択肢があるだけで、社内の稟議の通り方が変わってきますから。
ファインチューニング用ライブラリからデスクトップアプリへ
室谷代表取締役元々は2023年に始まったPythonのライブラリで、LoRAとかQLoRAっていう軽めのファインチューニングを速く、少ないメモリで回すためのものだったんですよ。それが今は Unsloth Desktop というネイティブのデスクトップアプリになっている。
テキトー教師DotAI 認定講師現場感覚で言うと、ライブラリ時代はPythonの環境構築でつまずく人が多かったんです。いまはアプリとして配布されているので、そこがかなり軽くなった印象ですね。
室谷代表取締役研究用のツールが製品に育つ流れはよくある話で、コードを書かない層まで届いた瞬間に利用のされ方が変わる。実際いまはアプリに加えてブラウザから使う形、コードから叩くPythonパッケージという入口も用意されている。
テキトー教師DotAI 認定講師入口が分かれているのは親切ですね。画面しか触らない人と、コードで書きたい人を同じ土俵に乗せられますから。
チャット以外にできること(ブラウザ操作・コード実行・Web検索)
テキトー教師DotAI 認定講師ここが誤解されやすいんですけど、チャットだけのアプリじゃないんですよ。ブラウザを操作してサイトを見たりフォームに入力したり、サンドボックスの中でBashやPythonを動かしたり、プライベートなWeb検索やディープリサーチもできます。
室谷代表取締役しかもOpenAI互換のAPIエンドポイントを出せるのが効くんですよね。既存ツールの向き先を変えるだけで手元のモデルに繋がるので、乗り換えの手間がほとんどない。
テキトー教師DotAI 認定講師あと
unsloth start でClaude CodeやCodexみたいなコーディングエージェントをローカルモデルに繋げられる。ここは知らずに使っている人が多そうだなと。室谷代表取締役ツールにどこまで権限を渡すかは、結局は運用ルールの問題なんですよ。便利さと露出は表裏一体で、CloudflareトンネルでLANの外から触れるようにもなる。
経営目線だと、導入の判断より先に社内のルール整備を決めたほうがいい領域なんですよね。
経営目線だと、導入の判断より先に社内のルール整備を決めたほうがいい領域なんですよね。
なぜ2倍速くてVRAM70%削減できるのか
2倍速・VRAM70%削減を支える3つの実装
手動逆伝播
PyTorchの自動微分に任せず、RoPE・RMSNorm・Cross Entropy Lossなど主要パーツの逆伝播を自前で実装。計算グラフを保持しない分メモリを削減
Tritonカーネル最適化
手書きした勾配をGPU上のTritonカーネルとして最適化。実測2倍を実現し、ボトルネックも追える形で残る
4bit量子化(QLoRA)ネイティブ統合
ファインチューニング向け技術を推論側のメモリ削減にも活用。精度低下なしでメモリを削減
PyTorchの自動微分に任せない「手動逆伝播」
室谷代表取締役公式が言ってる「2倍速くてVRAM70%削減」って、魔法の設定があるわけじゃなくて、泥臭い実装の積み上げなんですよね。まず効いてるのが勾配計算で、PyTorchの自動微分に任せずにRoPE、RMSNorm、Cross Entropy Lossみたいな主要パーツの逆伝播を自分たちで書いてる。
テキトー教師DotAI 認定講師そこを手で書くんですか。初めて触る人は「ライブラリが勝手にやってくれるんじゃないの」と感じるところで、僕も仕組みを聞いて驚きました。
室谷代表取締役自動微分は汎用だから安全なんですけど、その分だけ計算グラフを保持するのでメモリを食うんですよ。GPUを積み増すかどうかの判断に直結するので、70%という数字は技術の話であると同時に予算の話でもあるんですよね。
テキトー教師DotAI 認定講師なるほど、汎用性を捨ててモデル構造を絞り込んだ実装、という理解でいいんですかね。
Tritonカーネルで勾配計算を最適化する
テキトー教師DotAI 認定講師手書きした勾配って、素直にPythonで回すと逆に遅くなったりしません? 現場感覚だと、自前実装は往々にしてそうなりがちなんですよ。
室谷代表取締役そこをTritonカーネルで固めてるんですよね。GPU上で動くカーネルとして最適化するから、実測で2倍という数字が出てくる。
理屈と実装がセットで初めて効くタイプの改善なんですよ。
理屈と実装がセットで初めて効くタイプの改善なんですよ。
テキトー教師DotAI 認定講師速いツールって中身がブラックボックスで、遅くなったときに理由が追えないものが多いんですけど、ここは読める形で残ってるのが大きいですね。
室谷代表取締役そう、ボトルネックがどこか分かるのは運用では効くんですよ。公式のノートブックだとgpt-ossの20BでもLlama 3.1の8Bでも同じ2倍・70%削減が出てるので、特定モデルでたまたま出た数字ではないんですよね。
4bit量子化(QLoRA)をネイティブ統合
室谷代表取締役もう一本の柱が4bit量子化、QLoRAのネイティブ統合です。もともとファインチューニングを軽くするために育てた技術が、そのまま推論側のメモリ削減にも効いてる。
テキトー教師DotAI 認定講師量子化と聞くと精度が落ちる前提で身構える人が多いんですけど、公式は精度低下なしとうたってるんですよね。最初に戸惑うのがまさにそこです。
室谷代表取締役精度を落とさずにメモリだけ削るのが一番むずかしい。だからこそ、同じGPUで動かせるモデルの選択肢が増えるわけで、現場の判断としては「どのモデルを載せられるか」の幅が変わるんですよ。
テキトー教師DotAI 認定講師数字だけ見ると地味ですけど、載せられるモデルが変わるなら意味は大きいですね。
Desktop・Studio・Coreの3形態、どれを選べばいい?
Desktop・Studio・Coreの3形態
Desktop
- Mac/Windows/Linux向けネイティブアプリ
- 公式が最も簡単・推奨と明記
- ターミナルを開かずに使える
- 迷ったらこれ、社内配布にも向く
Studio
- ブラウザから使うWeb UI
- シェルスクリプト一発でインストール
- Docker・Homebrew・WinGetにも対応
- GPU搭載の1台を別端末から利用
- --secure時はパスワード管理必須
- 不要なら--disable-toolsで無効化
Unsloth Desktop——最も簡単で推奨されるネイティブアプリ
室谷代表取締役3形態あるって聞くと身構えるんですけど、実は「迷ったらDesktop」でほぼ終わる話なんですよね。Mac/Windows/Linux向けのネイティブアプリで、公式が最も簡単で推奨と書いているのがそれです。
テキトー教師DotAI 認定講師初めて触る人が最初に戸惑うのがまさにそこで。「3つもあるなら選ぶ基準が要るのでは」と考え込むみたいです。
でもターミナルを開かずに済むのは大きいですね。
でもターミナルを開かずに済むのは大きいですね。
室谷代表取締役そこなんですよ。導入手順を減らすのは事業判断と同じで、選択肢を絞ったほうが現場に定着するのが早い。
社内に配るならDesktopに寄せたほうがたぶん強いです。
社内に配るならDesktopに寄せたほうがたぶん強いです。
テキトー教師DotAI 認定講師現場感覚で言うと、最初の一回でつまずくとそのまま触らなくなるんですよね。そこを潰せるのはでかいです。
Unsloth Studio——ブラウザから使うWeb UI
室谷代表取締役じゃあStudioは何が違うのかというと、ブラウザから触るWeb UIのほうですね。インストールがシェルスクリプト一発で、Docker・Homebrew・WinGetにも対応している。
GPUを積んだ1台を別端末から覗きたいならこっちです。
GPUを積んだ1台を別端末から覗きたいならこっちです。
テキトー教師DotAI 認定講師あ、そこはハマる人多いんですよ。手元のノートからブラウザで開けるだけで、同じ機械を複数人で使うときの体験がまるで変わるので。
室谷代表取締役ただ、外に出すなら注意が必要で。サーバー側のツールはデフォルトで有効なので、--secure で公開するならパスワード管理は必須ですし、要らないなら --disable-tools で切れます。
LANやリモートはCloudflareトンネル経由で、これも無料の範囲です。
LANやリモートはCloudflareトンネル経由で、これも無料の範囲です。
テキトー教師DotAI 認定講師便利さと露出はセットですからね。そこだけは最初に確認しておきたいところです。
Unsloth Core——コードで学習と推論を書くPythonパッケージ
室谷代表取締役で、CoreはPythonパッケージです。uv pip install unsloth --torch-backend=auto で入れて、Python 3.13が推奨。
自前のコードに学習も推論も組み込む前提の形ですね。
自前のコードに学習も推論も組み込む前提の形ですね。
テキトー教師DotAI 認定講師ここは完全に「自分で書く人向け」なので、初めての人は後回しでいいと思います。まず動くものを見たいならDesktopかStudioで十分なので。
室谷代表取締役こうやってコアだけ残してUIを後付けできる構造にしてるの、オープンソースのツールだとよくある型なんですよね。中身を差し替えたい人を切り捨てない作りになってる。
テキトー教師DotAI 認定講師なるほど。じゃあ最初はアプリから入って、慣れてから同じ土台のCoreに降りていく順番が自然なんですね。
ライセンスが形態ごとに違うので、組み込む前にそこは確認しておきたいです。
ライセンスが形態ごとに違うので、組み込む前にそこは確認しておきたいです。
インストール手順——対応ハードウェアの確認からOS別の入れ方まで
先に確認しておきたい対応OS・GPU・バックエンド
室谷代表取締役入れる前に、まず自分の環境が対応範囲に入ってるか確認なんですよね。Windows、Linux、WSL、macOSは一通り動く前提で、GPUはNVIDIA・AMD・Intel、さらにCPUとVulkanバックエンドまで射程に入ってます。
テキトー教師DotAI 認定講師そこで最初に戸惑うのが「GPU積んでないと無理ですか」というところで。CPUやMacでも動く仕様なんですが、古いハードウェアだと十分にサポートされない場合がある、と公式に書かれています。
室谷代表取締役必要VRAMはモデル次第なので一概には言えないんですよ。24GBのノートPCで40B級のMoEモデルを動かす、みたいな事例もありますし、そこはFlintとは?UnslothがGGUF公開、24GBノートPCで動く40B級MoEコーディングモデルが参考になります。
テキトー教師DotAI 認定講師あと見落としがちなのがバックエンドの選択で。同じマシンでもVulkanを使うかCPUに落とすかで体感が変わるので、最初は素直に自動判定に任せるのがいいと思います。
Mac(Homebrew)とWindows(WinGet)での入れ方
ブラウザで使うStudioは、パッケージマネージャから入れるのが最短です。
- Macはターミナルを開き、
brew install --cask unslothを実行 - WindowsはPowerShellを開き、
winget install --id UnslothAI.Unsloth -eを実行 - 完了後、案内に従って起動し、ブラウザでStudioの画面を開く
テキトー教師DotAI 認定講師コマンド1行で終わるので、初めて触る人が一番つまずきにくいルートですね。macOSとWindowsのネイティブアプリ版は配布方法が別なので、そこは公式サイトの案内を見てもらう形になります。
室谷代表取締役この「入れるまでの摩擦の低さ」って地味に効くんですよ。どれだけ中身が良くても、最初の10分でつまずくとそこで離脱するじゃないですか。
ツールの普及速度って機能じゃなくて導入体験で決まる部分が大きいので。
ツールの普及速度って機能じゃなくて導入体験で決まる部分が大きいので。
テキトー教師DotAI 認定講師たしかに。HomebrewやWinGetに慣れてない人は、まずターミナルを開くところで止まるので、そこだけ声かけしてあげたいところです。
Linux・WSLはインストールスクリプトを1行流す
- ターミナル(WSLの場合はWSL側のシェル)を開く
curl -fsSL https://unsloth.ai/install.sh | shを実行- 表示される案内に従って初期設定を進める
室谷代表取締役Linux勢はこれで終わりなんですね。WSLも同じ扱いでいけるのは大きいです。
テキトー教師DotAI 認定講師実はそうなんですけど、WSLだとGPUのパススルー設定が絡むので、思ったよりVRAMを認識してくれないことがあります。まずは小さいモデルで動作確認してから本命を載せるのが安全です。
室谷代表取締役なるほど。最初から大きいのを読ませて「動かない」となるのが一番もったいないパターンですね。
DockerとPythonパッケージ(Unsloth Core)で入れる場合
テキトー教師DotAI 認定講師チームで同じ環境を配りたいならDocker、コードで学習まで書きたいならPythonパッケージです。Coreは
uv pip install unsloth --torch-backend=auto で入って、Pythonは3.13が推奨になっています。室谷代表取締役なるほど。検証環境を揃えるコストって地味にかかるので、そこでDockerが選べるのは大きいです。
テキトー教師DotAI 認定講師ただしDockerの具体的な起動コマンドは環境ごとに変わるので、公式の手順を確認しながら進めるのが確実です。自分のマシンに合った入れ方を1つ選べば十分なので、全部試す必要はないですよ。
室谷代表取締役了解です。まずは一番ラクなルートで動かして、足りなくなったらCoreに降りる、くらいの順番でいいですね。
基本的な使い方——モデルを選んでチャットを始めるまで
起動して最初にやること
- Unsloth Desktop を起動する(Mac / Windows / Linux のネイティブアプリ)
- 使うモデルを選ぶ(GGUF・MLX・拡散モデルに対応)
- チャット欄からメッセージを送って、応答が返ることを確認する
- 細かい設定項目は公式ドキュメントを見ながら後から足す
室谷代表取締役手順で言えば、起動してモデルを選んで送る。まずそこまでを最速でやるのが結局いちばん早いんですよね。
設定は動いてから詰めれば十分間に合います。
設定は動いてから詰めれば十分間に合います。
テキトー教師DotAI 認定講師たしかに。最初に全部理解しようとする人ほど、モデル選択の画面で止まるんですよ。
まず「返事が来た」を作るのが大事で。
まず「返事が来た」を作るのが大事で。
室谷代表取締役ですよね。で、画面の細かい表記は変更も多いので、公式ドキュメントを横に置きながら進めるのが無難です。
モデルの選び方——GGUF・MLX・拡散モデル
テキトー教師DotAI 認定講師モデルを選ぶ場面で最初に戸惑うのが、GGUFとMLXが並んでいるところなんですよ。「どっちを選べばいいんですか」というのは現場でよく聞く話で。
室谷代表取締役そこは自分の環境で決まる話なので、迷ったらGGUFから入るのが無難なんですよね。llama.cppベースなので守備範囲が広い。
MLXは別系統の選択肢として並んでいるので、公式のモデル一覧を見て判断するのが確実です。
MLXは別系統の選択肢として並んでいるので、公式のモデル一覧を見て判断するのが確実です。
テキトー教師DotAI 認定講師あと拡散モデルも同じアプリで扱えるのが、見落とされがちなポイントで。チャット専用だと思い込んでる人が多いんですよ。
室谷代表取締役GPUなし・Mac・CPUで動かすときの現実と、無料Colabだけで始められる?
室谷代表取締役GPUがないPCでも動くのか、というのは必ず聞かれるところで。公式ではGPUなしのCPUやMacでも動作する一方、古いハードウェアは十分にサポートされない場合がある、とされています。
テキトー教師DotAI 認定講師現場感覚で言うと、そこは期待値の調整が肝なんですよ。「動く」と「快適」は別物で、初めて触る人は待ち時間の長さで心が折れがちです。
室谷代表取締役で、手元に何もない人は無料のGoogle Colabで、T4 GPU上で22Bパラメータまでのほとんどのモデルを学習・実行できる無料ノートブックが用意されてるんですよね。ここから触るのは合理的な順番です。
テキトー教師DotAI 認定講師なるほど。まずColabで感触を見てから、手元のマシンを整える流れがいいんですね。
データは送られる?テレメトリとオフライン動作
室谷代表取締役これは導入判断の最初に来るところで。社内データを扱うなら、外に何が出るか説明できないツールは選べないんですよ。
Unslothは利用状況のテレメトリを収集しない、と公式に明記されてます。
Unslothは利用状況のテレメトリを収集しない、と公式に明記されてます。
テキトー教師DotAI 認定講師収集するのは互換性確認のための最小限のハードウェア情報だけ、というのも大きいですね。100%オフラインで動かせるので、機密性の高い作業でも心理的なハードルが下がります。
室谷代表取締役ただ、ネットワークに公開するときは別の話で。Cloudflareトンネルで外に出すとサーバーサイドのツールがデフォルトで有効なので、--disable-tools で切るか、--secure で公開するならパスワード管理を徹底する。
ここは事故のもとです。
ここは事故のもとです。
テキトー教師DotAI 認定講師その境目を知らないまま公開しちゃう人がいそうで、いちばん怖いところですね。
Claude CodeやCodexをローカルモデルにつなぐ方法
unsloth startで開けるコーディングエージェント
- ターミナルを開き、
unsloth startを実行する - 続けて開きたいエージェント名を指定する(claude / codex / hermes / opencode / openclaw)
- 起動したエージェントへの指示が、手元のモデルに流れる状態になる
室谷代表取締役手元のモデルをコーディングエージェントの頭脳に差し替える、これが一番刺さる使い方なんですよね。
unsloth start なら Claude Code も Codex も同じ入り口から開けます。テキトー教師DotAI 認定講師最初に戸惑うのが「Claude Code って Anthropic のものでしょう?」というところで。エージェント側の操作感はそのまま、裏のモデルだけが入れ替わるイメージなんですよ。
室谷代表取締役なるほど、道具は変わらないと。
テキトー教師DotAI 認定講師はい。
Hermes、OpenCode、OpenClaw も同じ書き方で並びます。APIキーを用意しなくていいのが、初めて触る人には特に大きいですね。
unsloth start claude なら Claude Code、codex なら Codex。Hermes、OpenCode、OpenClaw も同じ書き方で並びます。APIキーを用意しなくていいのが、初めて触る人には特に大きいですね。
--modelでモデルを指定する
テキトー教師DotAI 認定講師指定しないと既定のモデルが動きますが、現場でよく聞くのは「今どのモデルが答えてるのか分からない」という声で。
--model で明示した方が安心できます。室谷代表取締役具体的にはどう書くんです?
テキトー教師DotAI 認定講師こうです。
code
unsloth start claude --model unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_XLGGUF形式のモデルを、リポジトリ名でそのまま指定する形ですね。
室谷代表取締役GGUFの量子化まわりはUnslothが一番攻めてる領域なので、そこはUnslothの「DeepSeek-V4.1-Flash-1017」GGUFとは?Dynamic V3.1で量子化を読むと解像度が上がると思います。
待受ポートを変える
室谷代表取締役ポートの話、地味にハマるやつですよね。
テキトー教師DotAI 認定講師そうなんです。別のアプリが同じ番号を使っていると起動できなくて。
公式READMEにだけ書かれているんですが、
公式READMEにだけ書かれているんですが、
UNSLOTH_DESKTOP_PORT という環境変数でデスクトップの待受ポートを変えられます。室谷代表取締役既定のポートが埋まってるときに、そこをずらすと。
テキトー教師DotAI 認定講師はい、値を変えて起動し直せばその番号で待ち受けます。空いている番号は環境ごとに違うので、実際の指定方法は公式の手順で確認するのが確実です。
OpenAI互換APIエンドポイントとして呼び出す
テキトー教師DotAI 認定講師ここが一番応用が効くところで。UnslothはOpenAI互換のAPIエンドポイントとしても呼べるので、OpenAI前提で作ったツールの向き先をローカルに変えるだけで動く形になります。
室谷代表取締役それは構造的に大きいんですよね。互換で出すというのは乗り換えコストをゼロにする戦略で、ツール側が「OpenAI形式で話せれば中身は誰でもいい」になっているから、ローカルが一気に選択肢に入る。
テキトー教師DotAI 認定講師現場感覚で言うと効くのは「社外にデータを出せない」案件です。エンドポイントのURLやパラメータの細かい仕様は公式ドキュメントで確認してください。
ファインチューニングの手順——データ準備からデプロイまで
ファインチューニングの手順——データ準備からデプロイまで
- 01モデルと手法を選ぶフルファインチューニング/LoRA/QLoRAの三段階から選択。公式の入口は小さいモデル(Llama 3.1の8Bあたり)とQLoRAの組み合わせ
- 02データセットを用意する質問と回答のペアを形式をそろえて用意。UnslothのData RecipesでPDF・CSV・JSON・DOCXから自動生成し、生成後に目視確認
- 03ハイパーパラメータを設定して学習学習率(2e-4が目安)・バッチサイズ・エポック数を設定して学習開始。損失・勾配ノルム・GPU使用率をリアルタイム監視し、損失が横ばいならデータか学習率を見直す
- 04保存してデプロイGGUF・safetensors・LoRAアダプターの形で保存し、Ollama・vLLM・LM Studioへ渡す。全工程がローカル完結
モデルと手法を選ぶ(QLoRA・LoRA・フルファインチューニング)
室谷代表取締役ファインチューニングって聞くと身構える人が多いんですけど、流れ自体は素直なんですよ。最初に決めるのは、どのモデルをどの手法で鍛えるかという点です。
テキトー教師DotAI 認定講師たしかに。ただ最初の分岐で止まる人が多いんです。
フルファインチューニング、LoRA、QLoRAが横並びで出てくると、どれが自分用なのか分からなくなります。
フルファインチューニング、LoRA、QLoRAが横並びで出てくると、どれが自分用なのか分からなくなります。
室谷代表取締役そこで公式が入口として挙げているのが、小さいモデルとQLoRAの組み合わせなんですよね。Llama 3.1の8Bあたりで一度通すと勘所がつかめます。
テキトー教師DotAI 認定講師フルはモデル全体を更新、LoRAは差分のアダプターだけ学習、QLoRAはさらに4bitで量子化して回す、という重さの三段階。ここだけ押さえれば選択は怖くないです。
データセットを用意する(Data Recipesで自動生成)
室谷代表取締役次が一番の山で、データづくりなんですよね。ここが止まると学習が始まらない。
テキトー教師DotAI 認定講師現場でよく聞くのは「教師データって何件必要なのか」という不安です。まずは質問と回答のペアを、形式をそろえて並べるところからですね。
室谷代表取締役UnslothにはData Recipesという機能があって、PDF・CSV・JSON・DOCXあたりから学習用データを自動生成できる。手作業が減るのは実務的に大きいです。
テキトー教師DotAI 認定講師最初に戸惑うのが形式の揺れなんですよ。質問と回答の書き方が行ごとに違うと学習がうまく進みません。
生成したあとに目で確認する、結局これが一番効きます。
生成したあとに目で確認する、結局これが一番効きます。
ハイパーパラメータを設定して学習を回し、損失を監視する
手順としてはこうなります。
- 学習率・バッチサイズ・エポック数などのハイパーパラメータを設定する(学習率は2e-4が目安として案内されています)
- 学習を開始する
- 損失・勾配ノルム・GPU使用率をリアルタイムで監視する
- 損失が横ばいなら、データか学習率のどちらかを見直す
室谷代表取締役損失のグラフ、最初はみんな見入っちゃうんですけど、大事なのは下がり方の傾向なんですよね。
テキトー教師DotAI 認定講師そうなんです。動かないとパラメータをいじりたくなるんですけど、原因はデータ側のことも多い。
GPU使用率を見れば、そもそも詰まっているのかどうかが分かります。
GPU使用率を見れば、そもそも詰まっているのかどうかが分かります。
室谷代表取締役手元にGPUがない場合は、無料のGoogle ColabのT4 GPUで22Bパラメータまでのモデルを学習・実行できるノートブックが用意されています。まずそこで一周できます。
テキトー教師DotAI 認定講師そこは大きいですね。小さいモデルで一周させるのが、結局いちばんの近道です。
保存してOllama・vLLM・LM Studioへ渡す
室谷代表取締役学習が終わったら、GGUF、safetensors、LoRAアダプターの形で保存して、Ollama・vLLM・LM Studioあたりに渡す流れになります。
テキトー教師DotAI 認定講師保存形式で迷う人が多いんですよ。配布するならGGUF、コードから呼ぶならsafetensors、元モデルを変えず差分だけ持つならアダプター、という使い分けで覚えると楽です。
量子化まわりはUnslothのGGUF量子化の解説が参考になります。
量子化まわりはUnslothのGGUF量子化の解説が参考になります。
室谷代表取締役しかもこの工程、全部ローカルで完結するので社内データを外に出さずに済む。情シスの確認も通しやすいんですよね。
テキトー教師DotAI 認定講師一度この流れを通せば、次からはデータを差し替えるだけで回せるようになります。
料金とライセンス——無料の範囲と商用利用の注意点
無料で使える範囲と、Pro・Enterpriseという有料プラン
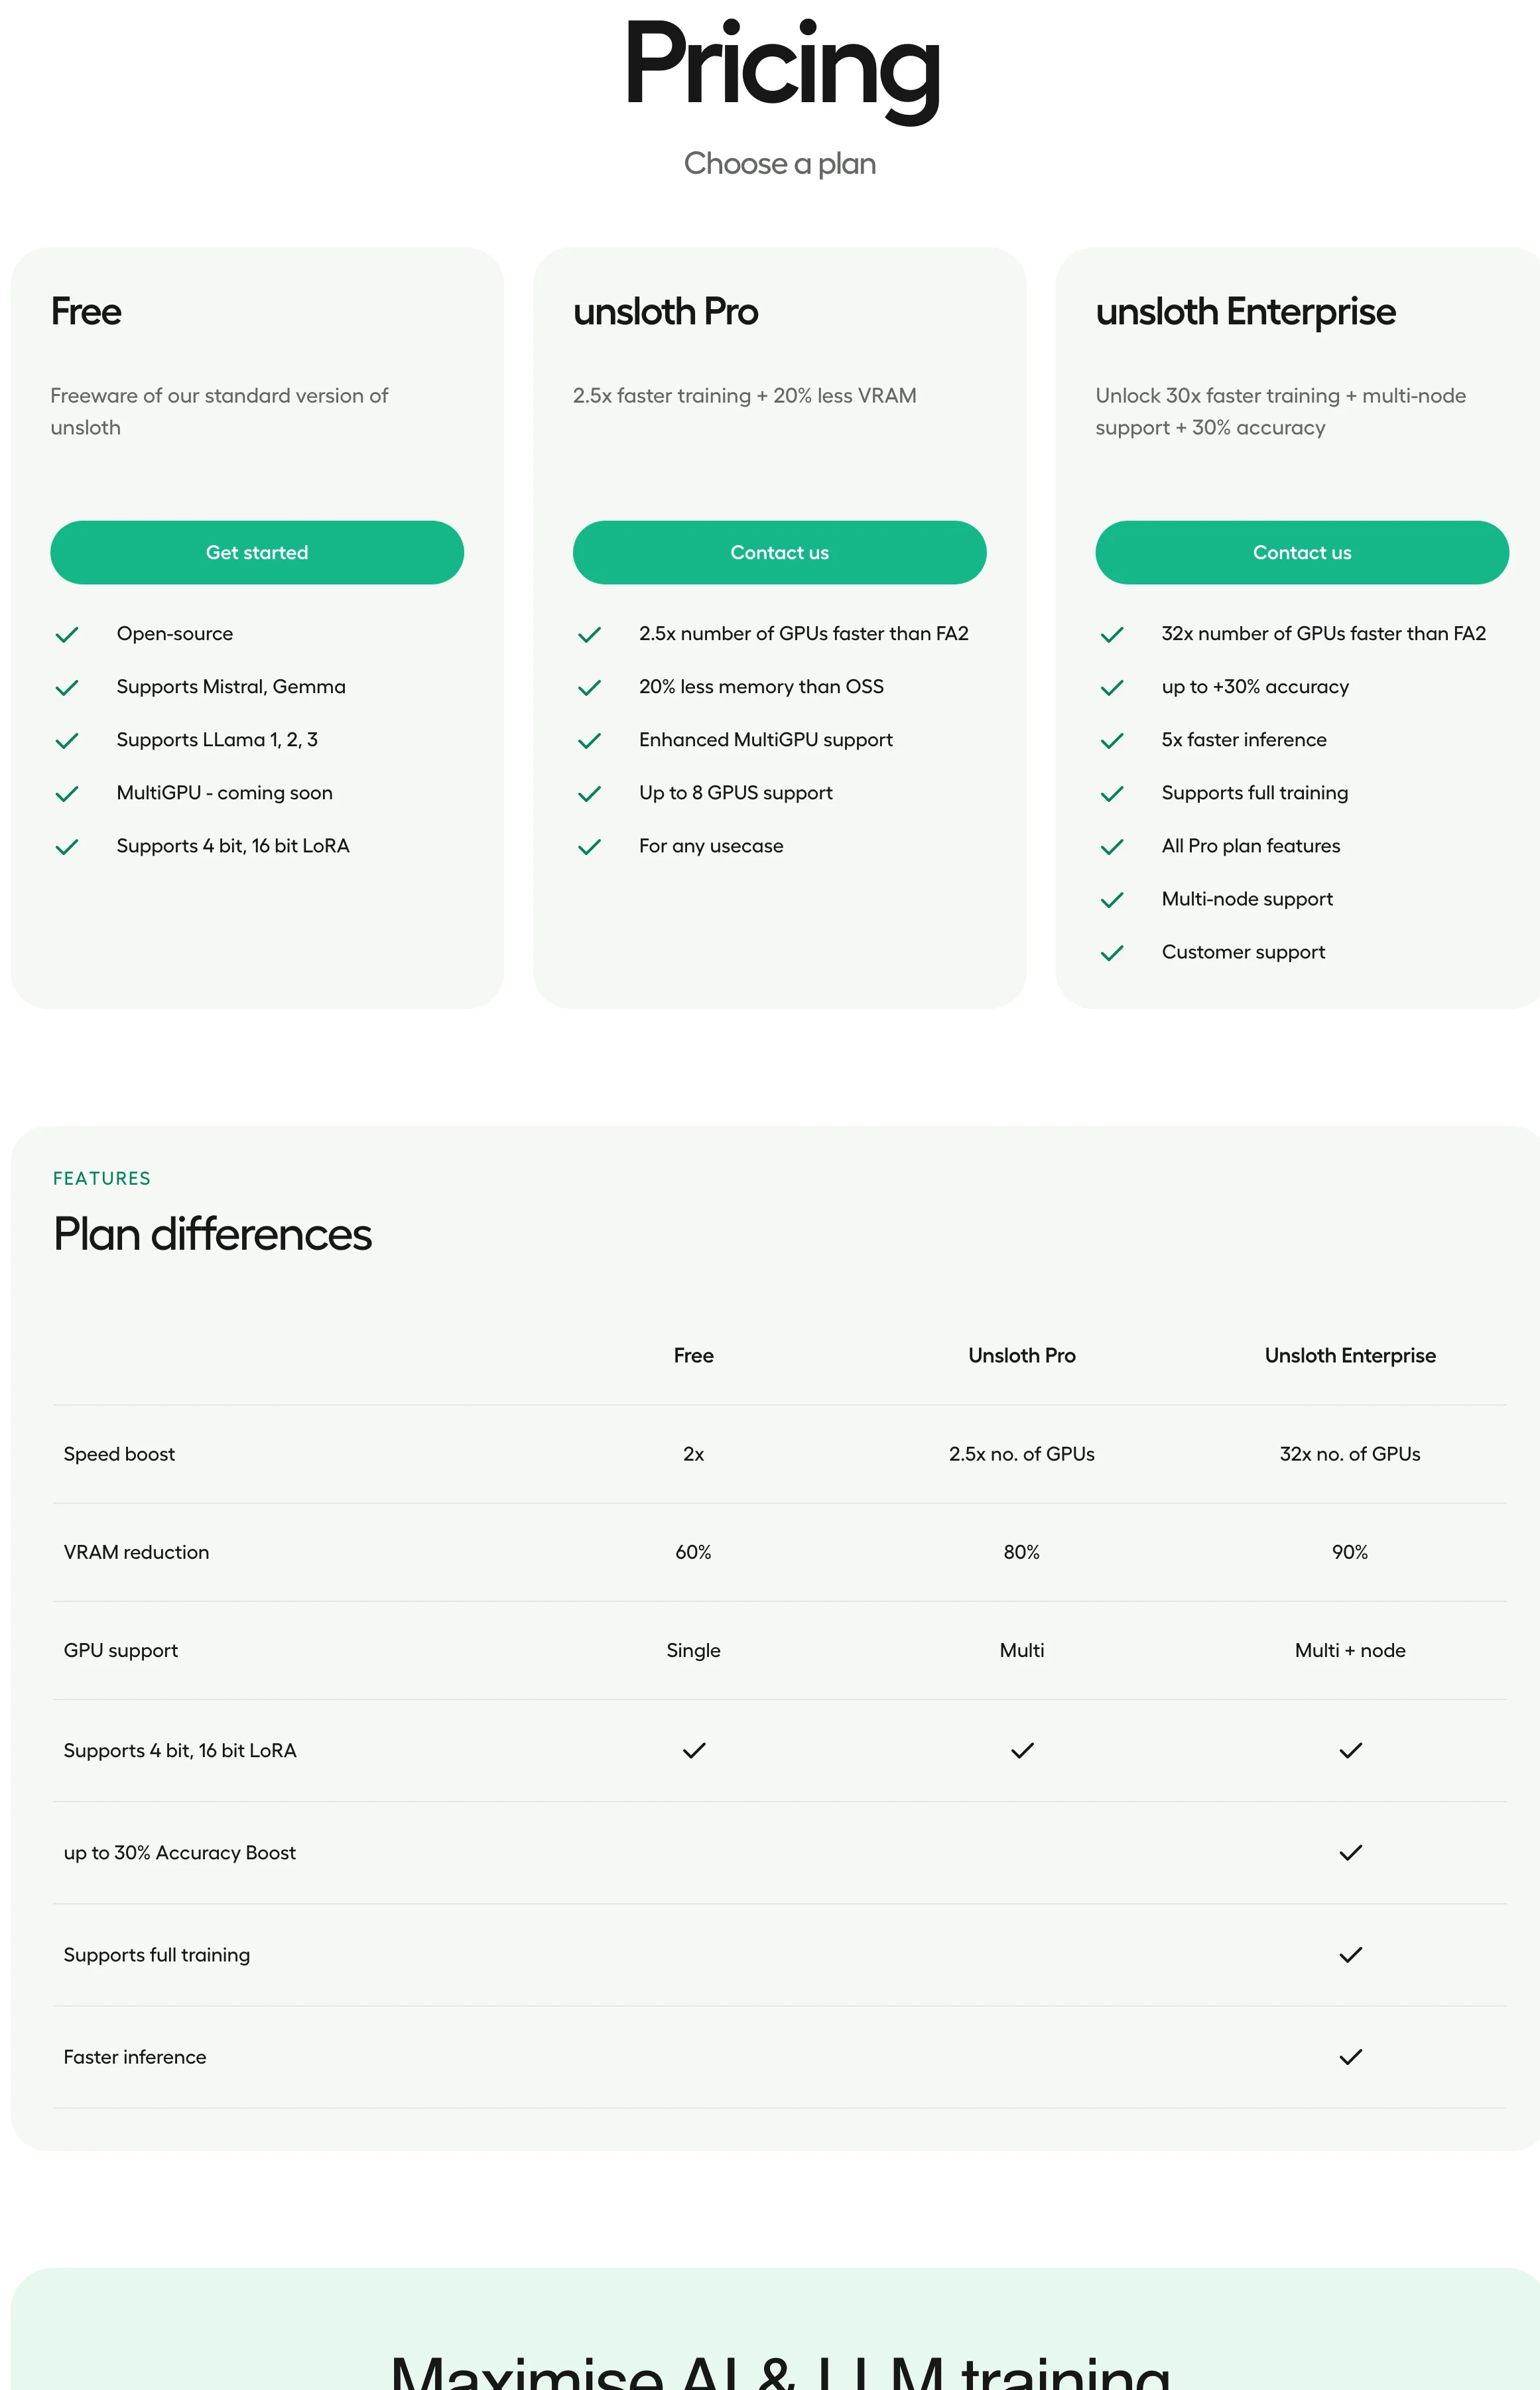
プラン別の無料範囲と有料プランの位置づけ
| 項目 | Free | Unsloth Pro | Unsloth Enterprise |
|---|---|---|---|
| Desktop / Studio / Core | ○ | ― | ― |
| Cloudflareトンネル | ○ | ― | ― |
| 料金 | 無料 | 要問い合わせ | 要問い合わせ |
| GPU数(FlashAttention2比) | ― | 2.5倍 | 32倍 |
| VRAM削減 | ― | 80% | 90% |
| マルチGPU | ― | 最大8GPU | ― |
| 精度向上 | ― | ― | 最大+30% |
| 推論速度 | ― | ― | 5倍速 |
| フルファインチューニング | ― | ― | ○ |
| マルチノード | ― | ― | ○ |
| 専任サポート | ― | ― | ○ |
室谷代表取締役料金の話、先に置いておくと、Desktop も Studio も Core も、リモートアクセス用の Cloudflare トンネルも無料なんですよね。ここは先に言っておきたいところで。
テキトー教師DotAI 認定講師たしかに。「無料と聞くと、どこかで課金されるんじゃないか」と身構える人は多いです。
実際はアプリ本体が無料で、ChatGPT や Anthropic のAPIをつなぐとそちら側の料金が別にかかる、という整理になります。
実際はアプリ本体が無料で、ChatGPT や Anthropic のAPIをつなぐとそちら側の料金が別にかかる、という整理になります。
室谷代表取締役ただ公式のPricingページを開くと、無料プランの隣に法人向けが2つ並んでるんですよ。ここを見落としたまま「無料アプリ」で片付けると、導入検討の場で詰まるんです。
まとめるとこうです。
| プラン | 内容 | 料金 |
|---|---|---|
| Free | Desktop / Studio / Core、Cloudflareトンネル | 無料 |
| Unsloth Pro | FlashAttention2比で2.5倍のGPU数、VRAM使用量80%削減、マルチGPU(最大8GPU) | 要問い合わせ |
| Unsloth Enterprise | FlashAttention2比で32倍のGPU数、VRAM削減90%、精度最大+30%、推論5倍速、フルファインチューニング・マルチノード・専任サポート | 要問い合わせ |
テキトー教師DotAI 認定講師Pro も Enterprise も問い合わせベースなんですね。個人が手元で試す分には関係ないですが、会社で稟議に上げる人はこの表を持っていく必要があります。
Apache 2.0とAGPL-3.0、何が違うのか
室谷代表取締役ライセンス、ここが地味に一番効くところで。Apache 2.0 と AGPL-3.0 のデュアルライセンスで、コアのパッケージはApache 2.0のまま、Studio のような一部のUIコンポーネントがAGPL-3.0なんですよ。
テキトー教師DotAI 認定講師現場感覚で言うと、AGPL のコピーレフトが効いてくるのは、改変したものをネットワーク越しにサービスとして提供するケースです。手元で使う分にはピンとこないんですが、そこを越えると話が変わります。
室谷代表取締役経営目線で言うと、これは技術選定じゃなくて法務の論点なんですよね。自社サービスに組み込む前提なら、開発が進んでから気づくのが一番高くつく。
テキトー教師DotAI 認定講師最初に「外に出すものか、社内で閉じるものか」を決めておく。そこだけで後の確認コストがかなり変わります。
ネットに公開するときのセキュリティ設定(--secureと--disable-tools)
Cloudflareトンネルで外に出す前に、次の順で確認します。
- まずはローカルだけで動かし、ツール類の挙動を把握する
- 公開が必要な場合のみ Cloudflare トンネルを使う
--secureを付けて公開する場合は、推測されにくいパスワードを設定し、使い回さない- その環境でコード実行が不要なら
--disable-toolsを付けてサーバーサイドツールを無効化する - 公開範囲をLAN内に留められないかも検討する
※オプションの正確な書式は公式ドキュメントで確認してください。
テキトー教師DotAI 認定講師サーバーサイドのコード実行ツールがデフォルトで有効、というのが見落としやすいところです。ローカルで試してる分には気にならないのに、URLを発行した瞬間に意味が変わってしまう。
室谷代表取締役--secure で公開するならパスワード管理は必須で、要らないなら --disable-tools で切る。できるできないの話じゃなくて、公開する前に一度立ち止まるかどうかです。テキトー教師DotAI 認定講師社内の別端末から触りたいだけなら、外に出さずにLANで済ませる選択肢もあります。そこを先に決めてから起動するのが安全ですね。
動かすモデル自体のライセンスは別で確認する
室谷代表取締役もう一個、アプリのライセンスとは別の話で。動かすモデル自体のライセンスは、Qwen でも Gemma でも Llama でも、個別に確認が必要なんですよね。
テキトー教師DotAI 認定講師ここ、初めて触る人が一番混同するところです。アプリが自由に使えるからといって、モデルも自由に使えるわけではない。
商用利用の可否はモデル側の条件を見る必要があります。
商用利用の可否はモデル側の条件を見る必要があります。
室谷代表取締役うちの現場でも、モデルを差し替えるたびにそこを確認する運用にしてます。アプリの選定より、どのモデルを何の条件で使ったかの記録を残すほうが、後から効いてくるんですよ。
よくある質問
Q1. 日本語のモデルや日本語データでも問題なく扱えますか?
室谷代表取締役日本語で使う前提だと、日本語データの学習って素直に効くものなんですかね・・・
テキトー教師DotAI 認定講師現場でよく聞くのは「英語前提のツールだと日本語が崩れるのでは」という不安です。ただ、日本語が扱えるかどうかは土台にするモデル次第なので、まずそこを選ぶのが先なんですよ。
室谷代表取締役ツール側の話と、モデル選びの話が混ざりやすい、と。
テキトー教師DotAI 認定講師そこが混ざると、うまくいかなかったときに原因を追えなくなるんですよね。データの日本語の揺れは、また別の問題として見た方が整理できます。
Q2. ローカルで動かすツールは他にもありますが、何が違うんですか?
室谷代表取締役手元でLLMを動かす道具は他にもありますよね。使い分けるなら、どこで線を引くんでしょう。
テキトー教師DotAI 認定講師ただ会話を試したいだけなら、もっと手軽な選択肢でも十分なんですよ。Unslothは、自分のデータを覚えさせるところまで一続きで見たい人が選ぶイメージです。
室谷代表取締役じゃあ「まず動かしてみたい」だけの人に、いきなり勧めるものでもない、と。
テキトー教師DotAI 認定講師そうですね。目的が「会話を試す」なのか「振る舞いを寄せたい」なのかで、選ぶ道具は変わります。
Q3. ファインチューニングとRAG、どちらから始めるべきですか?
室谷代表取締役現場だと「社内の資料を読ませたい」という相談が多くて。あれは学習させる話なんですかね。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこなんですよ。手元の資料を参照させたいだけなら、必要な情報を探して渡す仕組みの方が早いことが多いです。
室谷代表取締役学習は、言い方や振る舞いを寄せたいときに出番が来る、と。
テキトー教師DotAI 認定講師はい。覚えさせたいのか、参照させたいのか。
そこを分けるだけで、だいぶ迷わなくなります。
そこを分けるだけで、だいぶ迷わなくなります。
Q4. 会社のデータを扱っても大丈夫? 外部に送られたりしませんか?
室谷代表取締役業務で使うとなると、そこは最初に確認されますよね。
テキトー教師DotAI 認定講師手元の環境で動かす以上、推論が自分のマシンで完結するのが前提なんですけど、モデルの入手元や追加で入れるものは別で確認が要ります。
室谷代表取締役ツール自体がローカルでも、周辺で取ってくるものは自分で見ないといけない、と。
テキトー教師DotAI 認定講師その切り分けが甘いとトラブルになるので、業務利用なら社内ルールと公式の最新情報を先に当たるのが無難です。
Q5. 更新が活発と聞きます。環境が壊れたりしませんか?
室谷代表取締役更新が多いツールって、逆に「業務で固定できない」問題が出がちですよね。
テキトー教師DotAI 認定講師現場感覚で言うと、動いた状態をメモして残している人が結局強いんですよ。手順と使ったモデルを控えておくだけで、次に戻せます。
室谷代表取締役追いかけるというより、戻せる状態を作っておく、と。
テキトー教師DotAI 認定講師そうです。細かい仕様は変わるので最新は公式で確認する前提で、手元では「動いた構成」を再現できるようにしておくと安心です。
まとめ
室谷代表取締役結局、Unslothの価値って「動かす」より「自分の用途に寄せられる」側にあるんですよね。無料で試せる範囲が広いのは、判断材料を増やす意味で大きいです。
テキトー教師DotAI 認定講師たしかに。最初の一歩はすごく小さくてよくて、手持ちの環境でモデルを1つ動かしてみる、そこからで十分なんですよ。
室谷代表取締役経営目線で言うと、外に課金を積み上げる前に手元で検証を回せる状態を作っておくのは、時給換算でも悪くない投資なんですよね。試行回数が増える方が効きます。
テキトー教師DotAI 認定講師初めて触る人が止まりやすいのは、たいてい動かす手前なんですよ。だからまず1モデル動かして、慣れたら小さなデータで1回だけ学習させてみる。
そこで感覚がつかめます。
そこで感覚がつかめます。
室谷代表取締役動かす、試す、用途を決める。この順で進めるのが無駄がないと思います。
まずは自分の環境で1つ、触ってみてください。
まずは自分の環境で1つ、触ってみてください。