OpenAIがオープンにしたgpt-oss-120b、中身はどんなモデルなのか
117Bのうち、実際に動くのは5.1Bだけ
gpt-oss-120bのスペック要点
MoE構造
総パラメータ117B、層36、エキスパート128個中4個だけ選択。トークンごとに動くのは5.1B
軽い実コスト
総量は大きいが実際に計算が走るのは5.1B分。体感はより小さいモデルに近い
128kコンテキスト
位置エンコーディングはRoPE、グループサイズ8のマルチクエリアテンション。長いコードや資料をそのまま投入可能
トークナイザー
o200k_harmonyをオープンソース化。o4-miniやGPT-4oと同系統で再現性が高い
Apache 2.0
商用利用・改変・再配布が可能。著作権表示とライセンス文の保持、変更箇所の明示が条件
重みは無料公開
Hugging Faceから無料DL可能。MoE部分はMXFP4で量子化され単体80GB GPUで動作
 室谷代表取締役
「gpt-oss-120b」というモデル、名前の数字だけ見ると化け物なんですけど、中身はMoEで、トークンごとに動くのは5.1Bなんですよね。総パラメータは117B、層が36、エキスパートが128個あって、そのうち4個だけ選ばれる。
この設計のおかげで、数字の割に軽いという歪なバランスが成立してるんですよ。
この設計のおかげで、数字の割に軽いという歪なバランスが成立してるんですよ。
 テキトー教師DotAI 認定講師
初めて触る人が一番戸惑うのがそこで。「117Bって、うちの環境じゃ無理ですよね」という顔をされるんですけど、実際に計算が走るのは5.1Bのぶんだけなので、体感はもっと小さいモデルに近いんです。
全部のエキスパートを毎回使うわけじゃない、という一点で景色が変わります。
全部のエキスパートを毎回使うわけじゃない、という一点で景色が変わります。
室谷代表取締役経営目線で言うと、この「総量はでかいが実コストは小さい」構造はかなり好きで。GPUの見積もりも、117Bを丸ごと載せる前提じゃなくて、同時に動く量で読める。
見積もりが読みやすいモデルは、社内稟議が通るのも早いんですよね。
見積もりが読みやすいモデルは、社内稟議が通るのも早いんですよね。
テキトー教師DotAI 認定講師たしかに。スペック表を上から順に読むより、どこが実際に動くのかを先に押さえると、この後の話がすっと入ります。
128kのコンテキストと、地味に効くトークナイザー
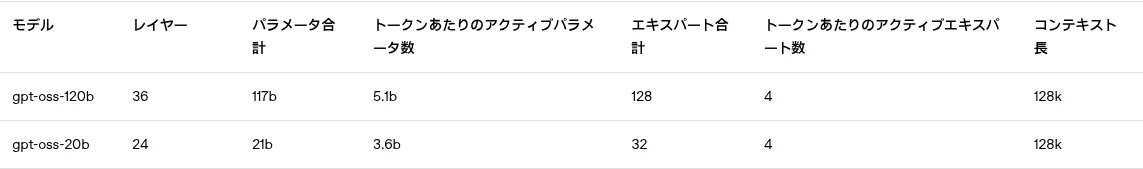
室谷代表取締役コンテキストは最大128k。位置エンコーディングはRoPEで、推論効率のためにグループサイズ8のマルチクエリアテンションを使ってる。
それと地味に重要なのが、トークナイザーが「o200k_harmony」で、これがオープンソース化されてる点なんですよ。
それと地味に重要なのが、トークナイザーが「o200k_harmony」で、これがオープンソース化されてる点なんですよ。
テキトー教師DotAI 認定講師現場感覚で言うと、トークナイザーって普段は意識しないところなんですけど、ここが揃ってないと「同じプロンプトなのに挙動が違う」みたいな沼にハマるんです。o4-miniやGPT-4oと同系統のものが公開されてるのは、再現性の面でかなり効きますね。
室谷代表取締役128kというのは、長めのコードベースや資料をそのまま放り込める量なんですよね。細かいチャンク分割を設計しなくて済むぶん、試作の回転数が変わる。
プロトタイプを何回回せるかは、そのまま開発コストですから。
プロトタイプを何回回せるかは、そのまま開発コストですから。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこなので、まずは長文をそのまま入れて挙動を見る、でいいと思います。
Apache 2.0で、商用利用はどこまでいけるのか
室谷代表取締役ライセンスがApache 2.0で、商用利用も改変も再配布も可能。条件は著作権表示とライセンス文の保持、それから変更箇所の明示なんですよね。
GPT-2以来のオープンウェイト公開というのが、業界的には大きい話で。
GPT-2以来のオープンウェイト公開というのが、業界的には大きい話で。
テキトー教師DotAI 認定講師「商用OK」だけ覚えてしまう人が多いんですけど、表示を消すとアウトなんですよ。そこさえ押さえれば、社内ツールに組み込むハードルはかなり下がります。
室谷代表取締役自社サービスに載せる前提だと、ライセンスが読めるかどうかで法務の通し方が全然違うんですよ。Apache 2.0は読み慣れてる人が多いので、そこは素直にありがたいですね。
重みが無料で落ちてくる、じゃあ料金はどうなる
室谷代表取締役重みはHugging Faceから無料でダウンロードできる。ここで「無料=タダ」と混同されがちなんですけど、モデル本体の対価がゼロなだけで、動かす計算資源は別でかかるんですよね。
MoE部分はMXFP4で量子化された状態でポストトレーニングされてて、だから単体の80GB GPUで動く、と。
MoE部分はMXFP4で量子化された状態でポストトレーニングされてて、だから単体の80GB GPUで動く、と。
テキトー教師DotAI 認定講師最初に戸惑うのがまさに値段のところで。「無料って書いてあるのに、なぜGPUの話が出てくるんですか」と聞かれるんです。
モデルの利用料がゼロなのと、電気代とハード代がゼロなのは別の話なんですよ。
モデルの利用料がゼロなのと、電気代とハード代がゼロなのは別の話なんですよ。
室谷代表取締役API課金と違って、使った分だけ青天井にならないのは強い。ただ、その代わりに固定費を先に払う構造になる。
どっちが得かは利用量で決まるので、そこは試算してから決めたほうがいいです。
どっちが得かは利用量で決まるので、そこは試算してから決めたほうがいいです。
性能はどれくらいなのか、o4-miniやo3-miniと並べてみる
コア推論でo4-miniとほぼ同等という結果をどう受け取るか
ベンチマーク別の測定内容とo4-mini/o3-miniとの比較
o3-miniを上回る領域
- Codeforces(競技コーディング)
- MMLU(一般問題解決)
- HLE(一般問題解決)
- Tau-Bench(ツール呼び出し)
- ※o4-miniに匹敵か上回る
o4-miniより上の領域
- HealthBench(健康系)
- AIME 2024(競技数学)
- AIME 2025(競技数学)
室谷代表取締役中身の話の流れで、肝心の性能なんですけど。単一の80GB GPUで動くモデルが、コア推論のベンチマークでo4-miniとほぼ同等、と発表されてるんですよね。
素直に読むとかなり不思議な話で。
素直に読むとかなり不思議な話で。
テキトー教師DotAI 認定講師まず引っかかるのがそこなんですよ。初めて触る人は「小型版でしょ」くらいの軽い気持ちで構えるのに、数字だけ見るとo4-miniと横並びに置かれている。
ここは一度、何を測った数字なのかを分けて見た方がいいです。
ここは一度、何を測った数字なのかを分けて見た方がいいです。
室谷代表取締役発表ベースだと、競技コーディングのCodeforces、一般問題解決のMMLU・HLE、ツール呼び出しのTau-Benchでo3-miniを上回って、o4-miniに匹敵か上回る。加えて健康系のHealthBenchと競技数学のAIME 2024・2025はo4-miniより上、という並びになってます。
テキトー教師DotAI 認定講師そのとき押さえておきたいのが、公開されてる評価はすべてMXFP4の量子化で測ったものだという点です。つまり配布されている重みそのままで出した数字であって、理想状態に戻したときの話ではない。
そこだけ頭に置いておけば、この表は素直に読めます。
そこだけ頭に置いておけば、この表は素直に読めます。
Codeforces・GPQA・SWE-benchの数字は何を測っているのか
室谷代表取締役個別の数字も見ておきたいんですけど。Elo評価だと「gpt-oss-120b」はツール利用で2622、o3-miniがツール無しで2073という並びになってます。
テキトー教師DotAI 認定講師たしかに、そこは条件が揃ってないんですよね。片方はツールあり、片方はツール無しなので、この2つをそのまま引き算して「大差で勝ち」と読むのは違います。
比較表は条件の列を先に見るクセをつけた方が安全です。
比較表は条件の列を先に見るクセをつけた方が安全です。
室谷代表取締役で、Hugging FaceのモデルカードだとGPQA Diamondがreasoning medium・ツールありで80.81、SWE-bench Verifiedがreasoning mediumで52.6。GPQAは大学院レベルの科学問題、SWE-benchは実際のリポジトリのIssueを直せるか。
測ってるものがまるで別なんですよね。
測ってるものがまるで別なんですよね。
テキトー教師DotAI 認定講師だから1つの数字で「賢さ」を決めつけない方がよくて。実務のコーディングに近いのはSWE-bench、知識の深さを見るならGPQA、というふうに用途で見る場所を変えるのが現場の感覚です。
クローズド側と突き合わせたいなら、GPT-5.5(Codex 5.5)徹底解説の比較が参考になると思います。
クローズド側と突き合わせたいなら、GPT-5.5(Codex 5.5)徹底解説の比較が参考になると思います。
reasoning_effortはlow・medium・highをどう切り替えるか
- システムプロンプトに一文だけ置く(例:
Reasoning: high) - 用途に応じて low / medium / high を選ぶ(低いほど速く、高いほど深く分析する)
- 数字を比べるときは同じレベルに揃える(モデルカードの評価は medium で測られている)
室谷代表取締役推論の深さ、low・medium・highの3段階で切り替えられるんですけど、やり方はシステムプロンプトに一文足すだけなんですよね。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこで。パラメータをあちこちいじる話じゃなくて、プロンプトに書くだけ。
設定ファイルの中を探しに行ってしまう人が多いんですよ。
設定ファイルの中を探しに行ってしまう人が多いんですよ。
室谷代表取締役時給で換算すると判断しやすいなと思ってて。lowで回して速く返すのか、highで時間をかけて深く考えさせるのか。
大量に流すバッチ処理はlow、設計レビューみたいな一発勝負はhigh、という振り分けが素直かなと。
大量に流すバッチ処理はlow、設計レビューみたいな一発勝負はhigh、という振り分けが素直かなと。
テキトー教師DotAI 認定講師あと自分でスコアを再現しようとするときは、モデルカードの数字がmediumで測られたものだってことを忘れずに。レベルを変えれば当然スコアも動くので、条件を揃えて比べるのが基本ですね。
動かすのに必要なGPUメモリは、80GBという壁をどう越えるか
MXFP4量子化で、なぜ単一の80GB GPUに収まるのか
室谷代表取締役まず前提として、120bはMoE部分の重みがMXFP4で量子化された状態でポストトレーニングされてるんですよね。だから総パラメータ117Bでも、単一の80GB GPU(H100やMI300Xあたり)で実行可能と公式が言い切ってる。
テキトー教師DotAI 認定講師「117Bが80GBに?」という反応は現場でよく聞きます。トークンあたりのアクティブパラメータが5.1Bしかないので、全部を毎回読んでるわけじゃないんですよ、という説明でだいたい納得されます。
室谷代表取締役公開されてるベンチマークも同じMXFP4で測った数字なんですよ。量子化版のスコアがそのまま公式のスコアになってるのは、判断材料として素直で助かります。
16GBで動く20bと、80GB前提の120b
テキトー教師DotAI 認定講師同じファミリーでも要件はかなり開きます。公式の書き方だとこうです。
| モデル | 公式に示されている実行環境 |
|---|---|
| gpt-oss-120b | 単一の80GB GPU |
| gpt-oss-20b | 16GBのメモリ |
室谷代表取締役この差、経営目線で見るとインフラの差そのものなんですよ。手元で触ってみる層と、本番で回す層がきれいに分かれる形になってる。
テキトー教師DotAI 認定講師手元のマシンで試したい人は20b、120bは素直にGPUを用意する前提で読む。最初はその線引きで構えないほうが混乱しないと思います。
GPUメモリが足りないとき、CPUオフロードで動くのか
室谷代表取締役ここが今日いちばん話したいところで。80GBって絶対の下限じゃないんですよ。
llama.cpp系のランタイム、LM StudioやOllamaはCPUとGPUへの自動オフロードに対応してて、実測ではGPU24GB+システムメモリ128GB程度でも動いたという例が共有されてます。
llama.cpp系のランタイム、LM StudioやOllamaはCPUとGPUへの自動オフロードに対応してて、実測ではGPU24GB+システムメモリ128GB程度でも動いたという例が共有されてます。
テキトー教師DotAI 認定講師最初に戸惑うのが、これが保証値じゃないという点なんですよね。「動いた人がいる」と「サポートされてる」は別物で、環境差で普通に転びます。
室谷代表取締役個人の検証では、MXFP4量子化後で60GB+αくらいをGPUとCPUの合計で確保できれば回る、という目安が示されてます。速度は落ちる前提で、検証用途と割り切るのが現実的かなと。
量子化後のメモリ目安と、実機報告を突き合わせる
テキトー教師DotAI 認定講師実機報告を見ると、H100でGPUメモリの使用が65GBくらい、という話もあります。80GBのカードを積んでも全部を使い切るわけじゃないんですよ。
室谷代表取締役だから「80GB必要」は「80GB級のカードなら快適に回る」に近い意味なんですよね。GPUを借りるコストと、CPUオフロードの遅さに耐えるコスト、どっちを取るかはもう普通に経営判断です。
テキトー教師DotAI 認定講師足りない構成で試すときは、公式要件と個人の検証結果を分けて読むこと。境界が曖昧なところは公式の最新情報を確認するのがいちばん確実です。
ローカルで動かす具体手順、Ollama・LM Studio・vLLMのどれを選ぶか
Ollamaならpullしてrunの2コマンドで終わる
ローカル実行ツールの選び分け
Ollama
- インストール後、pullとrunの2コマンドで完了
- `ollama pull gpt-oss:120b` でモデル取得
- `ollama run gpt-oss:120b` で対話開始
- 最初の一歩に一番ラク。検証用マシンを多数回す用途に向く
- つまずきどころは取得の待ち時間
LM Studio / Transformers
- `lms get openai/gpt-oss-120b` でモデル取得
- 画面から読み込んでチャットで試せる
- GUIで設定を変えながら挙動を確認できる
- PythonならTransformersのpipelineで呼ぶ
- GUIは検証、コードは実装と割り切る
- Ollamaをインストールする
- ターミナルで
ollama pull gpt-oss:120bを実行してモデルを取得 ollama run gpt-oss:120bで対話を開始
室谷代表取締役最初の一歩はOllamaが一番ラクなんですよね。pullしてrunで終わる。
MYUUUだと検証用のマシンを何台も回すので、手順が短いのは地味に効きます。
MYUUUだと検証用のマシンを何台も回すので、手順が短いのは地味に効きます。
テキトー教師DotAI 認定講師たしかに。初めて触る人がつまずくとすれば、取得の待ち時間ですね。
サイズが大きいので、回線次第ではかなり待つんですよ。
サイズが大きいので、回線次第ではかなり待つんですよ。
室谷代表取締役LM StudioとTransformersでGUI・Pythonから試す
- LM Studioで
lms get openai/gpt-oss-120bを実行してモデルを取得 - 画面から読み込んでチャットで試す
- Pythonから使うならTransformersで
pipeline("text-generation", model="openai/gpt-oss-120b")を呼ぶ
テキトー教師DotAI 認定講師GUIで触れるのは大きいですね。設定を変えながら挙動を見たい人には、コマンドだけより分かりやすい。
現場でよく聞くのは「黒い画面が怖い」なんですよ。
現場でよく聞くのは「黒い画面が怖い」なんですよ。
室谷代表取締役で、アプリに組み込む前提になった瞬間にTransformersの出番になる。GUIは検証、コードは実装、と割り切ると迷わないんですよね。
vLLMでOpenAI互換APIサーバーを立てる
室谷代表取締役複数のクライアントから叩く前提なら、vLLMでサーバーを立てる形になります。
これって結局、自社のシステムにどう組み込むかの話なんですよ。
vllm serve openai/gpt-oss-120b でOpenAI互換のAPIが上がるので、既存コードの接続先を差し替えるだけで済む。これって結局、自社のシステムにどう組み込むかの話なんですよ。
テキトー教師DotAI 認定講師実装する側からすると、呼び出しの形が変わらないのが一番ありがたいんです。モデルだけ入れ替えて比較できますから。
室谷代表取締役逆に、一人でチャットを試すだけならvLLMは大げさです。目的に対して道具が重すぎる選択は、だいたい運用で詰みます。
Harmony形式を外すと正しく動かない落とし穴
テキトー教師DotAI 認定講師ここが一番ハマる人多いんですよ。このモデルはHarmonyという形式で学習されていて、その形式以外では正しく動かないと明記されてます。
普通のプロンプトを投げて「あれ?」となるパターンですね。
普通のプロンプトを投げて「あれ?」となるパターンですね。
室谷代表取締役つまり「動いたけど出力が変」の正体がこれ、と。reasoning_effortもシステムプロンプトに一行足すだけで切り替わるので、まずそこを疑うのが早いんですよね。
テキトー教師DotAI 認定講師あと、思考の連鎖がそのまま出てくるのも仕様です。デバッグ用なので、そのまま人に見せる前提で設計しないほうがいいですよ。
実機だとどれくらいの速度が出るのか、報告を並べてみた
Mac Studio M3 Ultra・M2 Ultra・M4 Maxの実測報告
室谷代表取締役Mac Studio M3 Ultraで60〜70トークン/秒っていう報告が上がってるんですよね。個人の検証ベースですけど、数字としてはかなり現実味がある・・・
テキトー教師DotAI 認定講師たしかに。ただ、初めて触る人が戸惑うのが、これが公式の保証値じゃないところなんですよ。
同じM3 Ultraでも設定やプロンプトの長さでコロッと変わりますから。
同じM3 Ultraでも設定やプロンプトの長さでコロッと変わりますから。
室谷代表取締役M2 Ultraの192GBモデル、それからM4 Max 64GBでの動作報告も並んでますね。メモリに載せ切れるかどうかで、そもそも動くかが分かれる感じがします。
テキトー教師DotAI 認定講師現場感覚で言うと、最初の関門は速度以前に「起動して返事が返ってくるか」なんですよね。そこを越えてから数字を見る話というか。
DGX Spark、H100、Ryzen AI Max+の数値
室谷代表取締役DGX Sparkで40〜50トークン/秒、Ryzen AI Max+ 395搭載機だとVRAMの設定次第で約47トークン/秒という報告もあります。ワークステーション系も黙ってないなと。
テキトー教師DotAI 認定講師H100のケースではGPUメモリを65GB使ったという記録が残ってます。単体80GBのGPUに収まるという公式の説明と、方向としては合ってますね。
室谷代表取締役Threadripper 7980Xにメモリ384GB積んだ構成での検証もある。CPU側にかなり逃がす形でも動くんだなと、そこは素直に面白いです。
テキトー教師DotAI 認定講師まとめると、現時点で共有されている数字はこんな感じです。
| マシン | 報告されている内容 |
|---|---|
| Mac Studio M3 Ultra | 60〜70 tokens/s |
| DGX Spark | 40〜50 tokens/s |
| Ryzen AI Max+ 395搭載機 | VRAM設定により約47 tokens/s |
| H100 | GPUメモリ65GB使用(速度の記載なし) |
| Mac Studio M2 Ultra 192GB / Mac m4 max 64GB | 動作報告あり(速度の記載なし) |
いずれも個人の検証結果で、公式の保証値ではない点は押さえておきたいところです。
体感で実用になるラインはどこか
室谷代表取締役経営目線で言うと、検証機をどれにするかの判断材料になるのはベンチマークの点数よりこの速度なんですよ。何秒待てるかで、業務に乗せるかどうかが決まるので。
テキトー教師DotAI 認定講師体感では、数十トークン/秒出ていれば文章を読むテンポで流れてくる感じがします。逆に一桁台まで落ちると、考えながら使うのが正直しんどくなってくる。
室谷代表取締役ただ、この手の数字は環境でいくらでも動くので、購入前に自分の用途で一度回してみるのが前提ですね。他人の速さは他人の速さなので。
テキトー教師DotAI 認定講師そうですね。ここで並べた数値は目安として見てもらって、最終判断は手元のマシンで、というのが正直なところです。
ツール利用とエージェント機能、業務で使うなら何を見るべきか
Function calling・Web検索・コード実行はどこまで対応しているのか
まとめ
業務利用で見るべき4つの論点
- ツール利用: 120bはFunction calling・Web検索・Pythonコード実行・Structured Outputsに対応。ただし「対応」と「安定動作」は別物で、ツール定義を短く保ち1〜2個の関数から試す運用が現実的
- 思考の連鎖: 120bは思考過程を丸ごと出力するがOpenAIは開発者向けデバッグ用と明記。ハルシネーション混入前提で、ユーザーに見せる層と監査ログ層を最初から分離する
- 安全性評価: 事前学習でCBRN有害データを除外、事後学習で拒否・プロンプトインジェクション対策。悪化方向にファインチューニングした版をPreparedness Frameworkで評価し、生物・化学・サイバーで「High」未満。外部諮問グループも検証。ただし自社FT時は同じ検証を自分で実施する前提
- オンプレ運用: データを外に出さずApache 2.0で商用・改変・再配布可、単一80GB GPUで動作。一方で安全フィルタの更新・監視は自社責任、配布時点で量子化済みのため公開評価の前提を引き継ぐ。ツール利用前提の業務ならそこから検証する
室谷代表取締役エージェント用途で結局どこを見るかというと、道具を持てるかどうかなんですよね。120bはFunction callingに加えて、Web検索やPythonコード実行の組み込みツール、Structured Outputsまで対応してる。
モデル単体で手を動かせる設計になってます。
モデル単体で手を動かせる設計になってます。
テキトー教師DotAI 認定講師現場感覚で言うと、そこは大きいんですよ。これまでローカルモデルって「賢いけど道具を持てない」ケースが多くて、結局ワークフローは外側で組むしかなかった。
それが手元の環境で閉じる方向になってきた。
それが手元の環境で閉じる方向になってきた。
室谷代表取締役ただ、Function callingはfew-shotで関数を渡す形なので、プロンプト設計をサボると呼び出しが不安定になる。MYUUUだと、ツール定義は短く保つ、みたいな地味な運用ルールを先に決めますね。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこで。「対応してる」と「安定して動く」は別物なんですよ。
定義を盛りすぎると途端に崩れるので、まず1〜2個の関数から試すのが現実的です。
定義を盛りすぎると途端に崩れるので、まず1〜2個の関数から試すのが現実的です。
思考の連鎖をエンドユーザーに見せてはいけない理由
室谷代表取締役で、ここが落とし穴で。120bは思考の連鎖を丸ごと出力するんですけど、OpenAIはこれを開発者向けのデバッグ用だと明記してる。
テキトー教師DotAI 認定講師たしかに。デバッグでは嬉しいのに、そのまま画面に出すと途中でハルシネーションしてるのが見えちゃうんですよね。
プロダクトとして見せられるものじゃない。
プロダクトとして見せられるものじゃない。
室谷代表取締役ハルシネーションや有害な内容が混ざり得る、という前提で設計しないといけない。ユーザーに見せる層とログに落とす層を最初から分けておく、みたいな話です。
テキトー教師DotAI 認定講師実装の順番としても、思考の過程は握りつぶす前提で考えた方がいいですね。見せるのは結論だけで、そこに至る道筋は監査ログ側に置く。
CBRNとサイバーの安全性評価は何を確認したのか
室谷代表取締役安全性の話も整理しておくと。事前学習でCBRN関連の有害データを除外して、事後学習で安全でないプロンプトの拒否やプロンプトインジェクション対策を学習させてる。
テキトー教師DotAI 認定講師評価のやり方が面白くて、わざと悪い方向にファインチューニングした版を作って、Preparedness Frameworkの基準で測ってるんですよ。
室谷代表取締役結果として生物・化学とサイバーセキュリティの各カテゴリで「High」には届かなかった、と。外部の安全性諮問グループも検証に入ってる。
ここは経営判断の材料になる部分ですね。
ここは経営判断の材料になる部分ですね。
テキトー教師DotAI 認定講師ただ、これはその時点の評価なので、自社でファインチューニングするなら同じ検証を自分でやる前提になります。重みが手元にあるというのは、そういうことでもあるんですよ。
オンプレ運用のメリットと、現場で残るリスク
室谷代表取締役オンプレの利点は素直で、データを外に出さずに済むこと。重みはApache 2.0で商用利用も改変も再配布もできるので、閉じた環境に置いて業務フローに組み込める。
120bが単一の80GB GPUで動くのは、その判断を後押しします。
120bが単一の80GB GPUで動くのは、その判断を後押しします。
テキトー教師DotAI 認定講師現場でよく聞くのは「じゃあ安全フィルタの更新は誰が見るの」というところで。モデルを置いた瞬間から、アップデートも監視もこっちの責任になる。
室谷代表取締役そうなんですよね。あと配布時点で量子化された状態なので、公開評価の前提もそのまま引き継ぐことになる。
時給換算でペイするかは別で計算しないと、置いただけで満足するパターンに入ります。
時給換算でペイするかは別で計算しないと、置いただけで満足するパターンに入ります。
テキトー教師DotAI 認定講師健康関連のベンチマークが高いから医療領域で、という声も出ますけど、数字と現場導入の判断は別ですからね。ツール利用が前提の業務なら、まずそこから検証するのが順番だと思います。
120bと20bはどう使い分けるのか、日本語向けモデルという選択肢も含めて
120bと20bの違いを必要メモリと用途から逆引きする
120bと20bの選び方フロー
手元の環境で20bは動くか?(必要メモリ16GB)
YES / 動く
- まず20bで一通り触る
- 下書き量産・整形など高速用途に向く
- 物足りなくなったら120bへ上げる
NO / 動かない
- 素直に軽い方を選ぶ
- 大きいモデルから入ると挫折しやすい
室谷代表取締役120bと20b、スペックを並べると120bの方が上に見えるんですけど、選び方って逆から見た方が早いんですよね。必要なメモリから逆算すると、20bは16GBで動く、120bは単体80GBのGPUが前提。
ここで選択肢がほぼ決まる・・・
ここで選択肢がほぼ決まる・・・
テキトー教師DotAI 認定講師たしかに。最初に触る人がよく戸惑うのが、パラメータ数だけ見て「小さい方は性能が落ちるんでしょ」と判断しちゃうところで。
20bは総パラメータ21Bで、動かすときのアクティブは3.6B。軽さが正義になる場面があるんですよ。
20bは総パラメータ21Bで、動かすときのアクティブは3.6B。軽さが正義になる場面があるんですよ。
室谷代表取締役そうなんですよね。120bも総117Bに対してアクティブ5.1Bなので、毎回全部を動かしてるわけじゃない。
ただ重みを載せるメモリは要る。だから手元のマシンで常時回したいなら20b、品質を取るなら120b、という切り分けが現実的です。
ただ重みを載せるメモリは要る。だから手元のマシンで常時回したいなら20b、品質を取るなら120b、という切り分けが現実的です。
テキトー教師DotAI 認定講師現場感覚で言うと、20bはとにかく返答が速いので、下書きを大量に回したり、ちょっとした整形を何度も投げたりする用途で選ばれてます。逆に腰を据えた推論は120bに任せる、という分担ですね。
GPT-OSS-Swallow-120Bはどんな場面で選ぶのか
室谷代表取締役日本語で使いたいなら、日本語寄せのファインチューン版という選択肢もあります。GPT-OSS-Swallow-120Bというやつですね。
ただ注意があって、コーディングやエージェント用途だと素の「gpt-oss-120b」の方が適するという検証報告も出ているんですよ。
ただ注意があって、コーディングやエージェント用途だと素の「gpt-oss-120b」の方が適するという検証報告も出ているんですよ。
テキトー教師DotAI 認定講師ここ、ハマる人多いんですよ。日本語が自然になったから全部そっちが良い、とはならない。
ツール呼び出しやコード生成は、元のモデルが学習時に力を入れた分野に引っ張られるので。
ツール呼び出しやコード生成は、元のモデルが学習時に力を入れた分野に引っ張られるので。
室谷代表取締役つまり日本語の文章をたくさん書かせるのか、コードやエージェントを回すのかで分かれる。MYUUU の現場だと、コストの面でも用途ごとにモデルを分けた方が安く上がるんですよね。
1個で全部やろうとすると、だいたい大きい方を選んで無駄が出る。
1個で全部やろうとすると、だいたい大きい方を選んで無駄が出る。
テキトー教師DotAI 認定講師日本語版を試すときは、同じプロンプトを素の120bと並べて比べるのがおすすめです。体感で差が出るのは口調の自然さとコードの正確さで、効いてくる場所が別なんですよね。
自分の環境で動くかを最後に判断する
室谷代表取締役判断の順番を整理すると、まず20bが動くか、次に120bが動くか、動かないなら素直に軽い方を選ぶ。それだけなんですけど、ここを飛ばして大きいモデルから入って挫折する人が多い印象です。
テキトー教師DotAI 認定講師環境の確認は先にやった方がいいですね。80GBのGPUが手元にある人は多くないので、無いなら量子化版やCPUオフロードを試す流れになります。
ただこれは公式の最小要件ではないので、動いた報告があっても自分の環境で同じ速度が出るとは限らないんですよ。
ただこれは公式の最小要件ではないので、動いた報告があっても自分の環境で同じ速度が出るとは限らないんですよ。
室谷代表取締役そうなんですよね。だから「動くかどうか」と「実用的な速度が出るか」は別で考える必要がある。
前者はメモリ量、後者はレイテンシ。ここを混ぜると判断を間違える。
前者はメモリ量、後者はレイテンシ。ここを混ぜると判断を間違える。
テキトー教師DotAI 認定講師最初は20bで一通り触って、物足りなくなったら120bに上げる、という順番が失敗しにくいですね。逆に最初から120bで、しかも日本語版で、と欲張ると、どこでつまずいたのか分からなくなりやすいんですよ。
よくある質問
Q1. 商用利用はできますか?ライセンスはどう確認すればいい?
テキトー教師DotAI 認定講師ここ、最初に気になる人が多いところですね。配布ページに利用条件が書かれているので、そこを読むのが確実です。
業務で使うなら、社内の確認とセットで見ておくといいと思います。
業務で使うなら、社内の確認とセットで見ておくといいと思います。
室谷代表取締役そうなんですよね。重みが公開されてる=何にでも使っていい、ではないので。
条件の文面は更新されることがあるから、使う時点の最新を見るのが鉄則です。
条件の文面は更新されることがあるから、使う時点の最新を見るのが鉄則です。
テキトー教師DotAI 認定講師たしかに。自社サービスに組み込むのか、社内ツールに留めるのかで見え方も変わるので、用途を先に固めてから読むと判断が早いですよ。
Q2. 量子化したモデルにしても、性能はそんなに落ちない?
テキトー教師DotAI 認定講師現場感覚で言うと、まず量子化なしで一度動かして、素の挙動を見ておくのがおすすめです。比べる基準がないと、落ちたのかどうか判断できないんですよ。
室谷代表取締役これ、コスト目線でも同じで。メモリを削るために精度を譲るのか、精度のためにハードを足すのか、どっちを取るかって話なんですよね。
テキトー教師DotAI 認定講師ですね。軽くしたぶん反応は速くなるので、用途によってはそっちが効くこともあります。
Q3. GPUがないPCでも動かせますか?
テキトー教師DotAI 認定講師初めて触る人が最初に戸惑うのがここで。GPUがないと厳しい、という前提でまず考えたほうがいいですね。
動いたとしても、実用の速度かどうかは別の話になりますし。
動いたとしても、実用の速度かどうかは別の話になりますし。
室谷代表取締役そうですね。手元で試すなら小さいモデルで流れを掴んで、必要ならクラウドのGPUを時間貸しで借りる。
そのほうが結果的に安く済むことが多いです。
そのほうが結果的に安く済むことが多いです。
テキトー教師DotAI 認定講師たしかに。環境ごとに差が出るところなので、動いた・動かないの報告も参考程度に見ておくのが安全です。
Q4. APIで使えるモデルと、ローカルで動かすのは何が違うんですか?
テキトー教師DotAI 認定講師一番大きいのは、データが外に出るかどうかと、中身を自分でいじれるかどうか、ですかね。手元で完結させたい用途だと、そこが効いてきます。
室谷代表取締役あと可用性の話もあって。APIは相手の都合で仕様が変わるけど、ローカルは自分でコントロールできる。
そこを取るか、運用の手間を取らない方を選ぶか、なんですよね。
そこを取るか、運用の手間を取らない方を選ぶか、なんですよね。
テキトー教師DotAI 認定講師たしかに、そこは好みが分かれるところです。
Q5. 社内で使い始めるとき、ルール整備は何から手をつければいい?
室谷代表取締役うちだと、入力していい情報とダメな情報を先に決めます。モデルを上げる前にそこを決めないと、現場が止まるんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのは、どこまでAIに聞いていいか分からない、で手が止まるパターンです。基準が一言あるだけで動き出しが全然違います。
室谷代表取締役あとは、出てきた答えをそのまま外に出さない、という線も引いておく。この2つだけでもかなり違います。
まとめ
室谷代表取締役「gpt-oss-120b」は、手元に置いて自分で握れるモデルとして見ておくと分かりやすいんですよね。スペックの数字を追うより、自分の用途で動くかを先に確かめるほうが早いです。
テキトー教師DotAI 認定講師たしかに。最初から大きいほうで、と考えるより、小さいほうで流れを作ってから上げていくほうがつまずきにくいです。
室谷代表取締役機材の話も同じで、メモリが足りるかどうかで構成が変わりますから。まず動かして、速度と出力を見てから投資を決める。
順番はそっちが合理的なんですよね。
順番はそっちが合理的なんですよね。
テキトー教師DotAI 認定講師そうですね。動かし方は複数あるので、慣れてるやり方から入って、合わなければ乗り換えるくらいの気軽さでいいと思います。
室谷代表取締役配布元の条件や更新は変わるので、使う直前に一次情報を見る。そこだけ習慣にしておけば大丈夫です。