Hugging Faceとは何か?何ができるプラットフォームなのか
モデル・データセット・Spacesが並ぶHubの全体像
 室谷代表取締役
Hugging Faceって、ひとことで言うと何の置き場なんですかね。うちのエンジニアは普通に使ってますけど、外から見ると輪郭が掴みにくいというか・・・
 テキトー教師DotAI 認定講師
現場でよく聞くのは「GitHubのAI版みたいなもの?」という理解なんですよ。近いんですけど、並んでいるのがコードじゃなくて、学習済みモデルとデータセット、あとブラウザで動くデモアプリなんです。
室谷代表取締役公式ドキュメントだと、モデルが200万件超、データセットとアプリがそれぞれ150万件超。もう「探しに行く場所」というより、事実上の標準の棚になってるんですよね。
テキトー教師DotAI 認定講師そうなんです。モデルカードに制限やバイアスが書いてあったり、学習曲線が見られたり。
最初に戸惑うのが、コードを書かなくてもブラウザ上で試せる推論ウィジェットがあることなんですよ。
最初に戸惑うのが、コードを書かなくてもブラウザ上で試せる推論ウィジェットがあることなんですよ。
GitベースのリポジトリとXetという大容量ファイル管理
室谷代表取締役中身の管理はどうなってるんですか。モデルの重みって、普通は数GBとかになりますよね。
テキトー教師DotAI 認定講師全リポジトリがGitベースなんです。commit履歴、差分、ブランチがそのまま使えて、10MBを超えるファイルは Xet という仕組みで扱う流れになります。
慣れている人ほどありがたい設計ですよね。
慣れている人ほどありがたい設計ですよね。
室谷代表取締役そこは効きますよ。バージョンが追えないと「どの重みで出した結果か」が辿れなくなる。
開発の現場だと再現性が確保できないだけで、やり直しのコストが跳ね上がるんです。
開発の現場だと再現性が確保できないだけで、やり直しのコストが跳ね上がるんです。
テキトー教師DotAI 認定講師たしかに。あと S3 ライクな Storage Buckets という置き場もあって、大容量データの保管とリポジトリを分けて考えられるようになってます。
2026年9月のNVIDIA買収で、何が変わって何が変わらないのか
室谷代表取締役ここは外せないんですけど、2026年9月3日にNVIDIAがHugging Faceを約129.3億ドルで買収すると発表してるんですよ。
テキトー教師DotAI 認定講師ニュースで見ました。買収発表時点で1,800万人超の開発者、300万件超のモデルが公開されていたと。
ただ計測時点が違うので、数字は動く前提で見たほうがいいですね。
ただ計測時点が違うので、数字は動く前提で見たほうがいいですね。
室谷代表取締役経営目線で言うと、見るべきは金額より方針なんですよ。NVIDIAは「引き続きオープンな基盤として存続させ、自社の計算資源は必須にしない。
他社クラウドや他社アクセラレータでの開発・デプロイも支援を続ける」と明言してる。これって結局、モデルを配る側と計算資源を持つ側の構造の話で、囲い込んだ瞬間にオープンさの価値が消えるから、あえて縛らないと宣言したと読めるんです。
他社クラウドや他社アクセラレータでの開発・デプロイも支援を続ける」と明言してる。これって結局、モデルを配る側と計算資源を持つ側の構造の話で、囲い込んだ瞬間にオープンさの価値が消えるから、あえて縛らないと宣言したと読めるんです。
テキトー教師DotAI 認定講師そこは現場としても安心材料ですね。ブランドとチームも維持される方針とされているので、明日から使い方が変わる、という話ではないんですよ。
日本語のモデルやデータセットはどのくらいあるのか
室谷代表取締役で、日本語のものってどのくらいあるんですかね。実務だとそこが一番気になる。
テキトー教師DotAI 認定講師全体として8,000以上の言語に対応していると公式に書かれているので、日本語のモデルやデータセットも普通に公開されています。ただ、どこに何があるかは自分で探す必要があるんですよ。
室谷代表取締役そうなんですよね。英語前提のモデルをそのまま日本語で使うと、同じ内容でもトークン数が増えがちで、推論コストにじわっと効いてくる。
MYUUUの現場でも、日本語向けに調整されたものがあるかどうかで月の推論費用が変わるので、最初にそこを探すのが定石になってます。
MYUUUの現場でも、日本語向けに調整されたものがあるかどうかで月の推論費用が変わるので、最初にそこを探すのが定石になってます。
テキトー教師DotAI 認定講師探すときはタスクと言語で絞り込むと早いです。公開数は増え続けているので、正確な件数は公式のHubで確認するのが確実ですね。
Models・Datasets・Spaces・Transformersは何が違う?
Models・Datasets・Spaces・Transformersの違い
Models:モデルの置き場
Git管理でcommit履歴や差分まで見える。モデルカードに制限やバイアスまで記載され、学習曲線も確認可能。ブラウザ上で試せる推論ウィジェット付き。
Datasets:データの置き場
Gitベースで履歴と差分が見える。公式には8,000以上の言語をカバー。専用ライブラリからワンラインで読め、ストリーミングにも対応。
Spaces:デモアプリの置き場
新規作成で選べるSDKはGradio・Docker・静的HTMLの3つ。Gradioが最も手軽。静的HTMLは無料、Dockerは有料プランが必要。ZeroGPUを使うGradio Spacesは無料で2つまで。
Transformers:手元で動かすPythonライブラリ
Hub上のリポジトリではなく、手元で動かすライブラリ。PyTorch・TensorFlow・JAXをまたぎ、文章・画像・音声・マルチモーダルを扱える。Hub側に100万件超のチェックポイント。
Modelsはモデルカードと推論ウィジェットで中身が見える
室谷代表取締役まず押さえておきたいのが、Hugging Faceの中身はリポジトリの種類が分かれてるんですよね。Modelsはモデルの置き場で、Git管理なのでcommit履歴や差分まで見える。
テキトー教師DotAI 認定講師たしかに。初めて触る人が戸惑うのが、モデルページの情報量で。
モデルカードに制限やバイアスまで書かれてるので、落とす前に読む習慣がつくと安心です。
モデルカードに制限やバイアスまで書かれてるので、落とす前に読む習慣がつくと安心です。
室谷代表取締役学習曲線が見られるのも地味に効くし、ブラウザ上でそのまま試せる推論ウィジェットもある。動きを確認してから手元に持ってくる、という順番が取れるわけです。
テキトー教師DotAI 認定講師現場でよく聞くのは「とりあえず重みを落として動かしてから読む」パターンで、それで事故るんですよ。カードを先に読む方が結局速いんです。
Datasetsはワンラインで取得でき、ストリーミングにも対応
室谷代表取締役Datasetsはデータの置き場ですね。こちらもGitベースで、履歴と差分が見える。
公式には8,000以上の言語をカバーしてると書かれています。
公式には8,000以上の言語をカバーしてると書かれています。
テキトー教師DotAI 認定講師実務だと取得の軽さが効くんですよ。専用ライブラリからワンラインで読めて、ストリーミングにも対応してる。
全部ダウンロードしてから考える必要がないんです。
全部ダウンロードしてから考える必要がないんです。
室谷代表取締役MYUUUの現場だと、評価用データを毎回自前で作るコストが地味に重かったんですよね。公開データセットを叩き台にできるだけで、検証の立ち上がりが一段速くなる。
テキトー教師DotAI 認定講師ただ、公開データをそのまま社内の検証に使うならライセンスの確認は要ります。そこは使い方の話として切り分けておきたいところです。
SpacesはGradio・静的HTML・Dockerで作るデモの置き場
室谷代表取締役Spacesはデモアプリの置き場。新規作成で選べるSDKはGradio・Docker・静的HTMLの3つなんですよね。
Gradioが一番手軽で、UIをほぼ書かずに入出力を出せる。
Gradioが一番手軽で、UIをほぼ書かずに入出力を出せる。
テキトー教師DotAI 認定講師静的HTMLは無料で誰でも置けるので、見せるハードルが低いんです。モデルの中身を触らせずに「動く形」で渡せるのが大きいです。
室谷代表取締役Dockerは自由度が上がる代わりに、動かすには有料プランが要る。無料の個人アカウントでもZeroGPUを使うGradio Spacesは2つまでホストできるので、まずそこで試すのが現実的です。
テキトー教師DotAI 認定講師順番としては、Gradioで作って足りなくなったらDockerに逃がす。最初からDockerで組もうとする人は、だいたい途中で疲れて止まります。
TransformersはPyTorch・TensorFlow・JAXをまたぐライブラリ
室谷代表取締役で、Transformersだけは性質が違うんですよ。これはHub上のリポジトリではなく、手元で動かすPythonライブラリ。
文章・画像・音声・マルチモーダルを同じ書き味で扱えます。
文章・画像・音声・マルチモーダルを同じ書き味で扱えます。
テキトー教師DotAI 認定講師ここが一番混同されるポイントで。「Hub=Transformers」だと思ってる人は、Spacesの話になると急に分からなくなる。
置き場と道具は別物ですからね。
置き場と道具は別物ですからね。
室谷代表取締役フレームワークをまたげるのも効きます。学習コードの事情に合わせて使う側を選べるので、既存の資産に乗せやすい。
Hub側には100万件を超えるチェックポイントがあるので、探す母数も十分です。
Hub側には100万件を超えるチェックポイントがあるので、探す母数も十分です。
テキトー教師DotAI 認定講師逆に、Hubから落としたものを別のライブラリで動かすのも普通にできます。Transformersは選択肢のひとつ、と捉えると分かりやすいですね。
アカウント登録から最初のリポジトリ作成までの始め方
アカウント登録から最初のリポジトリ作成までの流れ
- 01無料アカウントを登録公式サイト(huggingface.co)の登録フォームにメールアドレス・パスワード・ユーザー名を入力する
- 02確認メールで認証届いた確認メールのリンクを開いて認証する
- 03ログインログイン画面から同じメールアドレスでログインする
- 04リポジトリ作成画面で4項目を指定huggingface.co/new で「所有者(個人/組織)」「リポジトリ名」「公開か非公開か」「ライセンス」を決める
- 05Web UIでファイルを追加リポジトリのページを開き「Files」タブ→「Add file」からファイルを選ぶ
- 06CLI/gitでアップロード(ファイルが増えたら)CLIは hf auth login → hf upload <repo> <path>。gitは「Clone repository」のURLをcloneしてpush(10MB超はgit-xetで管理)
無料アカウントを作ってログインするまで
- Hugging Faceの公式サイト(huggingface.co)を開き、登録フォームにメールアドレス・パスワード・ユーザー名を入力する
- 届いた確認メールのリンクを開いて認証する
- ログイン画面から同じメールアドレスでログインする
テキトー教師DotAI 認定講師ここは拍子抜けするくらい簡単で、メールアドレスとユーザー名を入れて確認メールのリンクを開くだけです。画面の文言が多少違っても、やることは同じですね。
室谷代表取締役無料でここまでできるのが大きいですよね。公開されているモデルもデータセットも、アカウントさえあれば触れるわけですから。
テキトー教師DotAI 認定講師最初に戸惑うのが個人アカウントと組織の違いで、「会社で使うならどっちを作るの?」と聞かれることが多いです。まず個人で試して、必要になったら組織を作る形でも困りません。
リポジトリ作成画面で決める4つの項目
作成画面(huggingface.co/new)で指定するのは次の4つです。
- 所有者(個人アカウントか組織か)
- リポジトリ名
- 公開か非公開か
- ライセンス
室谷代表取締役決めることは実質この4つだけなんですよね。名前と公開範囲とライセンス。
選択肢が少ないので、迷いようがないというか。
選択肢が少ないので、迷いようがないというか。
テキトー教師DotAI 認定講師ライセンスの欄で手が止まる人は多いです。ここで完璧を目指すより、まず1つ作って動かしてみる方が結果的に早いですよ。
室谷代表取締役公開か非公開かの選択は、会社で使うときは効いてきますね。非公開で置けるかどうかで、そもそも試せるかどうかが変わってくるので。
Web UIのFilesタブからファイルを追加する
- 作成したリポジトリのページを開く
- 「Files」タブを選ぶ
- 「Add file」から追加したいファイルを選ぶ
テキトー教師DotAI 認定講師手軽さで言うとこのルートが一番で、「Files」タブの「Add file」からそのまま置けます。数ファイルを試しに上げるだけなら、これで完結しますね。
室谷代表取締役Gitを知らなくても公開まで行けるのが強いですよね。初回の心理的なハードルを、かなり下げてくれている。
hf CLIとgitでアップロードするときのコマンド例
ファイルが増えてきたら、CLIとgitの2通りが使えます。CLIは pip install hf または brew install hf で入れて、hf auth login でログインしたあと、hf upload <repo> <path> でアップロードします。
code
pip install hf
hf auth login
hf upload <repo> <path>
gitを使う場合は、リポジトリのページの「Clone repository」に表示されるURLをコピーしてcloneし、10MBを超えるファイルはgit-xetで管理します。
code
git clone <コピーしたURL>
git xet install
git add .
git commit -m "最初のアップロード"
git pushファイルが増えてくるとCLIなんですよね。ログインしてアップロードのコマンドを打つだけなので、ブラウザで1つずつ上げるより速い。
テキトー教師DotAI 認定講師gitを使う人は、大きなファイルの扱いでつまずくケースが多いです。そこはgit-xetを入れておくと素直にpushできます。
室谷代表取締役最初にコマンドの型を覚えてしまえば、あとは同じことの繰り返しですからね。
モデルを探してダウンロードする具体的な手順
検索とタスク絞り込みで候補を減らす
室谷代表取締役モデルを探すとき、いきなりダウンロードから入る人が多いんですけど、あれはけっこう危ないんですよね。まずHub上で候補を絞るところから始めた方がいい。
テキトー教師DotAI 認定講師現場でよく聞くのは「名前が良さそうだから落としてみた」パターンですね。動かしてみたら自分のタスクと噛み合わなくて、時間だけ溶けるやつです。
室谷代表取締役絞り込みはタスクで切るのが早いです。画像なのか、文章なのか、音声なのか。
そこを決めてから検索すると候補が一気に減る。供給側が増えすぎて、選ぶ側のコストの方が重くなってるんですよ。
そこを決めてから検索すると候補が一気に減る。供給側が増えすぎて、選ぶ側のコストの方が重くなってるんですよ。
テキトー教師DotAI 認定講師同じタスクでもサイズが違いますからね。大きいのを先に落とすと手元で動かない、みたいなことが起きます。
小さめで試すのが結局は近道です。
小さめで試すのが結局は近道です。
モデルカードで確認しておきたい制限とバイアス
テキトー教師DotAI 認定講師で、落とす前に必ず読んでほしいのがモデルカードです。ここに制限やバイアスが明示されているんですよ。
室谷代表取締役モデルカードは僕も選定の場では真っ先に見ます。学習データの偏りと、想定していない用途が書いてあるかどうか。
ここが曖昧なまま本番に載せると、後で全部やり直しになる。
ここが曖昧なまま本番に載せると、後で全部やり直しになる。
テキトー教師DotAI 認定講師初めて触る人は性能の数字だけ見ればいいと思いがちなんですけど、実はそうじゃなくて。苦手な入力や推論時の前提条件が書いてある方が大事なんですよね。
室谷代表取締役あと、書いてあることをそのまま信じずに、自分のデータで一度確かめる。ここを飛ばすと検証コストが倍で返ってくるんですよ。
ブラウザの推論ウィジェットで先に試す
室谷代表取締役カードを読んだら、次は落とさずに試す。モデルページにはブラウザで動く推論ウィジェットが付いてるので、まずそこで感触を見るんですよ。
テキトー教師DotAI 認定講師これ、ハマる人多いんですよね。いきなりローカルに環境を作って依存関係で詰まって、モデルの良し悪しまで辿り着かない。
順番が逆なんです。
順番が逆なんです。
室谷代表取締役ウィジェットで思ってたのと違うと分かれば、ダウンロードの手間がまるごと消える。無駄な工数を先に削るのは現場でも同じ判断です。
テキトー教師DotAI 認定講師相性が良さそうなら、そのまま次のステップに進めばいいですからね。
Transformersで読み込む場合の流れ
手元に持ってくる流れは次のとおりです。
- モデルページ右上の「Clone repository」からURLをコピーする
- ターミナルで
git clone <コピーしたURL>を実行する - 10MBを超えるファイルを扱う場合は
git xet installでgit-xetを入れておく - 更新を取り込みたいときは
git pullを実行する
室谷代表取締役クローンして、そのまま自分のコードから読み込む。PythonのTransformersで扱うなら、これが一番素直な入り口なんですよね。
テキトー教師DotAI 認定講師最初に戸惑うのが、どのモデル名を指定すればいいのか分からない問題ですね。モデルページの名前をそのまま使えばいいと知ってしまえば拍子抜けなんですけど。
室谷代表取締役HubにはTransformersで読めるチェックポイントが100万件を超えてるので、探す側からすると逆に選べない。だから絞り込みの順番が効いてくるんですよ。
テキトー教師DotAI 認定講師探す、読む、試す、落とす。この順番を守るだけで、最初のつまずきはかなり減ります。
Spacesでデモアプリを作って公開するには
「Create new Space」で最初に決める名前・ライセンス・可視性
- Spacesのページで「Create new Space」を開く
- 名前、ライセンス、可視性(public / protected / private)を入力する
- 使うSDKを選び、「Create Space」で作成する
室谷代表取締役作成画面、最初に名前とライセンスと可視性を聞かれるんですよ。ここで手が止まる人が多い・・・
テキトー教師DotAI 認定講師現場でよく聞くのは、可視性の3択で悩むパターンですね。publicは誰でも見られる、protectedはリンクを知っている人だけ、privateは自分だけ。
人に見せるデモならpublicが基本です。
人に見せるデモならpublicが基本です。
室谷代表取締役ライセンスも名前も、あとから直せるとはいえ、公開した時点で外から見えているわけで。最初の一手が一番重いんですよね。
テキトー教師DotAI 認定講師たしかに。「これは人に見せる前提か」を先に決めてから作ると、あとで焦らずにすみます。
SDKの選択で何が変わるのか — Gradio・Docker・静的HTML
室谷代表取締役で、SDKの選択が地味に一番効くんですよ。Gradio、Docker、静的HTMLで、その後の運用がまるで変わる。
テキトー教師DotAI 認定講師入門で多いのはGradioですね。Pythonで書いた処理をそのまま画面付きのデモにできるので、モデルを触ってもらう用途に向いています。
室谷代表取締役静的HTMLはHTMLを置くだけ。Dockerは何でも入る代わりに、自分で面倒を見る範囲が増える。
自由度と手間のトレードオフなんですよね。
自由度と手間のトレードオフなんですよね。
テキトー教師DotAI 認定講師最初に戸惑うのがそこなんですよ。「どれが一番すごいか」ではなく「何を動かしたいか」で選ぶと迷いません。
無料でホストできる範囲とZeroGPUの扱い
テキトー教師DotAI 認定講師ここは誤解されやすいんですが、静的Spacesはすべてのユーザーが無料で置けます。一方、GradioやDockerのSpacesをコンピュート上で動かすには、個人ならPRO、組織ならTeam以上が必要です。
室谷代表取締役ただし、無料の個人アカウントでも、ZeroGPUを使うGradio Spacesは2つまで無料でホストできるんですよ。ここが実質の入口になってる。
テキトー教師DotAI 認定講師ZeroGPUは動的割当で、NVIDIA RTX Pro 6000 Blackwellまで最大96GB。空いているときに割り当てられる仕組みなので、常時GPUを握るわけではないんですよね。
室谷代表取締役GPU時間は有限な資源だから、誰にどれだけ割くかはプラットフォーム側の設計次第。無料枠の範囲は変わりうるので、料金ページで都度確認するのが確実です。
公開したあとの更新と、公開範囲の考え方
室谷代表取締役公開後の更新は、Hugging FaceのSpacesも普通のGitの流れなんですよ。ファイルを直してpushすれば反映される。
テキトー教師DotAI 認定講師現場感覚で言うと、ここで「反映ボタンはどこ」と探す人が多いです。Web UIの「Files」タブから「Add file」で足すこともできます。
室谷代表取締役公開範囲は、最初から全公開にしなくていいんですよね。privateで作って中身が固まってから見せる、という順番が取れるのが大きい。
テキトー教師DotAI 認定講師段階を踏めるのは安心材料ですね。切り替えの操作は公式ヘルプの表記に沿って進めるのが確実です。
料金プランはFree・PRO・Team・Enterpriseでどう違う?
料金プラン別の違い(Free / PRO / Team / Enterprise)
Free(無料)
公開モデル・データセットの利用とCPU BasicのSpacesが無料。ZeroGPUを使うGradio Spacesは2つまで無料でホスト可。公開リポジトリは誰でも見られる前提の設計
PRO(個人・月額9ドル)
非公開ストレージ10倍、公開ストレージ2倍、推論クレジット20倍、ZeroGPUクォータ8倍+優先キュー。自分のSpacesをホストでき、Spaces Dev ModeでSSHやVS Codeから入れる
Team(1ユーザー月額20ドル)
SAML/OIDCによるSSO、監査ログ、リソースグループ単位のアクセス制御。機能の話ではなく統制が取れるかの層
Enterprise(1ユーザー月額50ドル)
SCIMによる自動ユーザー管理、年間契約の一括請求。人数が増えるほど差が出る
Freeでもできることと、公開リポジトリの扱い
室谷代表取締役まず無料でどこまで行けるか。公開モデル・データセットの利用と、CPU BasicのSpacesは無料で使えるんですよね。
公開リポジトリは誰でも見られる前提の設計です。
公開リポジトリは誰でも見られる前提の設計です。
テキトー教師DotAI 認定講師ここで最初に戸惑うのが、公開にした時点で中身が全体公開になる点です。「あとで非公開にすればいい」と思って上げる人、現場でよく聞きます。
室谷代表取締役後から戻せても、誰かが持って行ったら終わりなんですよ。公開はリリースと同じ判断で、社外に出せないものは最初から別に分けてます。
テキトー教師DotAI 認定講師たしかに。ただ無料の個人アカウントでも、ZeroGPUを使うGradio Spacesなら2つまで無料でホストできるので、試すだけなら十分なんですよ。
PRO(個人・月額9ドル)で広がる範囲、TeamとEnterpriseの統制機能
室谷代表取締役PROは個人向けで月額9ドル。非公開ストレージが10倍、公開ストレージが2倍、推論クレジット20倍、ZeroGPUのクォータ8倍に優先キューが付きます。
自分のSpacesをホストできるようになるのも大きい。
自分のSpacesをホストできるようになるのも大きい。
テキトー教師DotAI 認定講師初めて触る人が一番反応するのは、Spaces Dev Modeです。SSHやVS Codeから入れるので、公開したあとの手直しが一気に楽になります。
室谷代表取締役組織で使うならTeamで1ユーザー月額20ドル。SAML/OIDCでのSSO、監査ログ、リソースグループ単位のアクセス制御が付きます。
うちの感覚だと、この層は機能の話じゃなくて統制が取れるかの話なんですよね。
うちの感覚だと、この層は機能の話じゃなくて統制が取れるかの話なんですよね。
テキトー教師DotAI 認定講師さらにEnterpriseは1ユーザー月額50ドルで、SCIMによる自動ユーザー管理や年間契約の一括請求。人数が増えるほど差が出てきますね。
ストレージ課金とSpaces・Inference Endpointsの時間単価
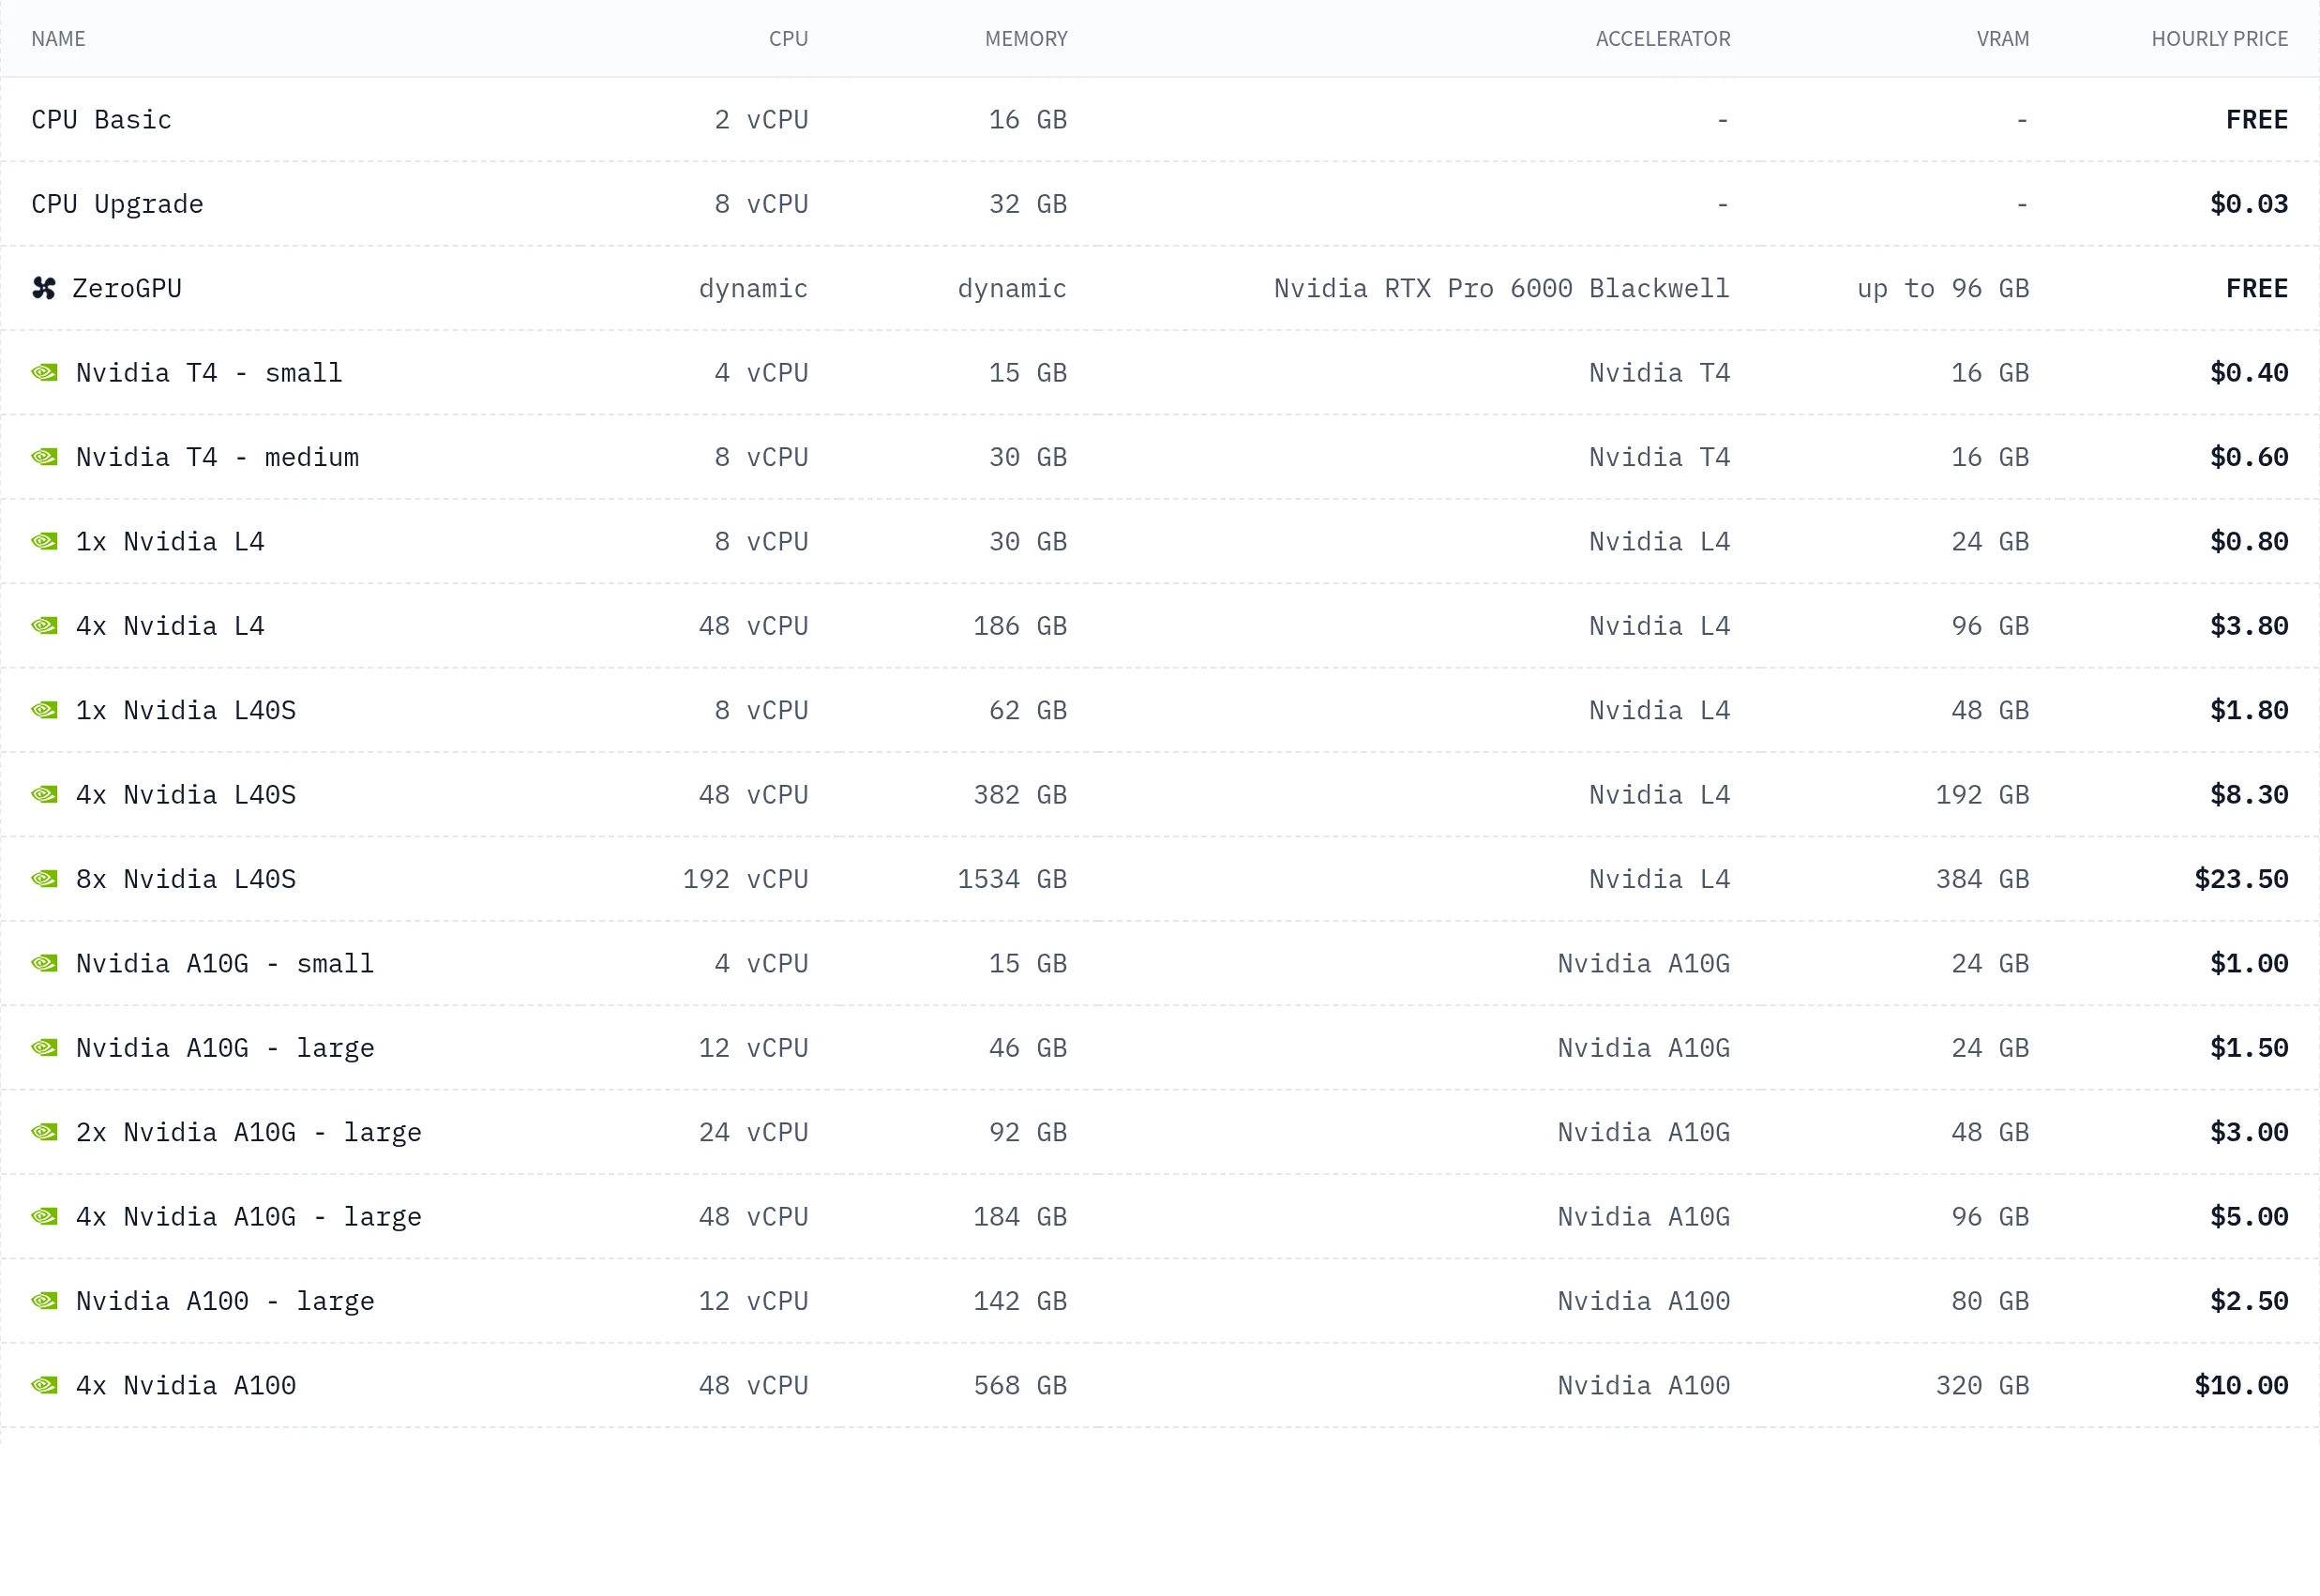
室谷代表取締役ストレージは容量課金で、公開が$12/TB/月、非公開が$18/TB/月。50TB以上で20%引き、200TB以上で25%引き、500TB以上で33%引き。
EgressとCDNは追加料金なしです。
EgressとCDNは追加料金なしです。
テキトー教師DotAI 認定講師計算資源は時間単価で出ていて、こうなってます。
| ハードウェア | 時間単価 |
|---|---|
| CPU Basic(2vCPU・16GB) | 無料 |
| CPU Upgrade(8vCPU・32GB) | $0.03 |
| ZeroGPU | 無料 |
| Nvidia T4-small | $0.40 |
| 1x L4 | $0.80 |
| 1x A100-large | $2.50 |
| 8x A100 | $20.00 |
室谷代表取締役Inference Endpointsは時間$0.033から。これは個人が試す額じゃなくて、組織が本番で回す前提の数字です。
常時起動で月額に直してから判断した方がいい。
常時起動で月額に直してから判断した方がいい。
テキトー教師DotAI 認定講師ZeroGPUが無料なのが大きいですね。まずそこで当たりをつけて、重くなったら有料GPUに上げる順番が現実的だと思います。
倍率表記しかない項目は公式ページで確認する
室谷代表取締役注意したいのが、公式の料金ページに倍率しか載っていない項目があることです。非公開ストレージの実容量やZeroGPUの日次上限は、絶対値が明記されていないんですよ。
テキトー教師DotAI 認定講師倍率だけ見て「十分だ」と決めると、実際の数字を知らないまま契約することになります。金額で出ている部分と、そうでない部分を分けて見た方がいいですね。
室谷代表取締役判断するときは、金額で出ている部分から見て、枠の部分は公式の最新情報で確認する。この順番が安全だと思います。
商用利用はできる?ライセンスはどう確認する?
ライセンスはモデル・データセットごとに違う
室谷代表取締役ここ、一番誤解されてる部分なんですよ。プラットフォーム全体で商用OKみたいに思われがちなんですが、実際はモデルごと、データセットごとにライセンスがバラバラなんですよね。
テキトー教師DotAI 認定講師たしかに。現場でよく聞くのは「Hugging Faceって商用利用できるんですか?」という一言です。
まずプラットフォーム単位で答えを探してしまうんですね。
まずプラットフォーム単位で答えを探してしまうんですね。
室谷代表取締役そこが落とし穴で。MIT や Apache 2.0、Creative Commons みたいに緩いものもあれば、研究目的に限定されたモデルもある。
同じ場所に並んでるのに条件が違う・・・
同じ場所に並んでるのに条件が違う・・・
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこなんですよ。モデルカードには制限やバイアスの記載まであるので、そこを読む習慣をつけると事故が減ります。
商用利用の前に必ず見る確認手順
商用利用の前に必ず見る確認手順
- 01モデル・データセットのページを開く使いたいモデル・データセットのページを開く
- 02ライセンス表記を確認モデルカードのライセンス表記を確認する
- 03想定用途・制限事項を読む想定用途・制限事項の記載を読む
- 04商用可否が不明なら最新情報を確認商用可否が読み取れない場合は、配布元や公式の最新情報を確認する
- 使いたいモデル・データセットのページを開く
- モデルカードのライセンス表記を確認する
- 想定用途・制限事項の記載を読む
- 商用可否が読み取れない場合は、配布元や公式の最新情報を確認する
室谷代表取締役手順としてはこの4つで、特別なことは何もないんですよ。ただ、これを飛ばしてそのまま導入する例が本当に多い。
テキトー教師DotAI 認定講師初めて触る人は、ダウンロードボタンが先に見えちゃうんですよね。ライセンス表記は下のほうにあるので、つい素通りしてしまう。
室谷代表取締役経営目線で言うと、後から「このモデルは商用NGだった」と発覚するのが一番痛い。手戻りのコストは時給換算だと洒落にならないんですよ。
テキトー教師DotAI 認定講師しかもデータセット側にも同じ確認が要るので、モデルだけ見て終わりにしないことですね。
企業導入では非公開リポジトリとTeam以上の統制機能を組み合わせる
室谷代表取締役法人で使うなら、ライセンス確認とセットで効いてくるのが統制の部分です。機密データは非公開リポジトリに置く、権限はリソースグループ単位で絞る、といった設計が前提になる。
テキトー教師DotAI 認定講師個人で使ってる感覚のまま組織に持ち込むと、公開範囲の設定でヒヤッとする場面が出てきますからね。
室谷代表取締役Team なら SAML/OIDC の SSO、監査ログ、トークンの集中管理と承認あたりが使える。Enterprise はさらに SCIM での自動管理や高度なアクセス制御が乗ってくる。
先ほどのプラン比較で見た層ですね。
先ほどのプラン比較で見た層ですね。
テキトー教師DotAI 認定講師セキュリティ部門に説明するとき、この統制機能の有無が効いてくるんですよ。値段だけで比較されがちですけど。
買収直前のサイバー攻撃報道から何を読み取るか
テキトー教師DotAI 認定講師買収の直前になって、サイバー攻撃の標的になったという報道がありましたよね。
室谷代表取締役そうなんですよ。CNBC の報道では、CEO の Clément Delangue が「エンジニアリング上のミスが原因」と説明していて、対応に中国発のオープンウェイトモデルを改修したNVIDIA版を使ったと述べている。
テキトー教師DotAI 認定講師攻撃の手口についてはSNSでいろんな解説が流れましたけど、確定情報として扱えるのはそこまでなんですよね。
室谷代表取締役なので、外部プラットフォームのモデルを業務に持ち込むときは、ライセンスと同時に誰が管理しているかも見ておく。2026年9月3日のNVIDIAによる買収合意では、オープンなプラットフォームとして存続し、NVIDIAの計算資源を必須にはしないと明言されている。
そこは安心材料なんですが、統制は自組織で持つのが結局一番強いんですよね。
そこは安心材料なんですが、統制は自組織で持つのが結局一番強いんですよね。
業務での活用例と、使う前に知っておきたい注意点
要約・翻訳・文字起こしなら、まず小さく試す
室谷代表取締役業務での使い方で一番イメージしやすいのは、要約・翻訳・文字起こしなんですよね。Hugging FaceのHubにはその用途のモデルが大量に公開されていて、自分で一から作らなくても探せばだいたい見つかります。
テキトー教師DotAI 認定講師現場でよく聞くのは「探すところまでは行けるけど、どれを選べばいいか分からない」なんですよ。モデルカードに用途や制限が書いてあるので、まずそこを読むのが近道ですね。
室谷代表取締役音声や画像もTransformersで扱えるので、議事録の文字起こしから画像の分類まで同じ流れで入っていける。MYUUUの現場だと、社内問い合わせの一次対応を試したら工数がそこそこ減りました。
時給で換算すると判断しやすいんですよね。
時給で換算すると判断しやすいんですよね。
テキトー教師DotAI 認定講師ただ、いきなり本番に置くのは危ないですね。まず手元で数十件流して、出力のクセを見てから業務に載せる。
この順番が現実的です。
この順番が現実的です。
品質とライセンスは、使う前に確認する
室谷代表取締役品質の見極めは、モデルカードの記載と、自分のデータで流してみた結果の両方を見るのが基本。ベンチマークの数字が良くても、自社データでは崩れることが普通にあります。
テキトー教師DotAI 認定講師ライセンスも同じくらい大事なんですよ。モデルやデータセットごとに条件がバラバラで、商用OKのものもあれば研究目的だけのものもある。
使う前にモデルページで個別に確認するしかないですね。
使う前にモデルページで個別に確認するしかないですね。
室谷代表取締役ここは経営判断の話で、あとから揉めるのが一番高い。法務を巻き込むタイミングを後ろにずらすと、その分だけ手戻りコストが乗るんですよ。
機密データを扱うなら非公開リポジトリで、という線引きも先に決めておきたい。
機密データを扱うなら非公開リポジトリで、という線引きも先に決めておきたい。
テキトー教師DotAI 認定講師分からないものは使わない、でいいと思います。表記が読めないまま進むのが一番こわいので。
更新が速い前提で、付き合い方を決める
室谷代表取締役この界隈、ライブラリもモデルも更新が速いんですよね。昨日動いていたコードが前提を変えることがある。
バージョンは固定しておいて、上げるタイミングを自分で決める方が安全です。
バージョンは固定しておいて、上げるタイミングを自分で決める方が安全です。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこですね。新しいものが出るたびに全部追わないといけない気がしてしまう。
追わなくていい、と伝えると安心されます。
追わなくていい、と伝えると安心されます。
室谷代表取締役リポジトリがGitベースなので、commit履歴や差分が追えるのはありがたい。どの時点のモデルで出した結果なのかを残しておけば、あとから検証し直せます。
テキトー教師DotAI 認定講師再現できる状態にしておく、が結局いちばん効きますね。
無料で試してから、有料に上げる
室谷代表取締役進め方としては、無料の範囲でまず小さく試すのが現実的。公開モデルやデータセットは無料で使えますし、ZeroGPUを使うGradioのデモなら無料アカウントでも2つまでホストできます。
テキトー教師DotAI 認定講師段階を踏むのは賛成です。いきなり課金してから探し始めると、使わないまま月日が過ぎがちなので。
室谷代表取締役逆に、試して手応えが出たのに無料のまま粘るのももったいない。クォータが詰まって待ち時間が増えると、試すスピードそのものが落ちる。
そこは投資判断なんですよね。
そこは投資判断なんですよね。
テキトー教師DotAI 認定講師上げる基準を先に決めておくと楽ですね。「週に何回使ったら上げる」くらいの雑さでいいと思います。
よくある質問
Q1. GitHubとHugging Faceは何が違うんですか?
室谷代表取締役たとえるなら、GitHubはコードを置く場所、Hugging Faceはモデルとデータセットを置く場所なんですよね。リポジトリという考え方は似てるんですけど、中身の主役が違う。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこで。「Gitの操作は分かる」という人が来ても、置いてあるのが重みファイルだったりするので勝手が違うんですよ。
室谷代表取締役あと、ブラウザ上でそのまま試せるデモが一緒に置いてあるのも大きい。コードを読まなくても挙動が分かるのは、選定のスピードが変わります。
Q2. アカウントを作らなくてもモデルは使えますか?
テキトー教師DotAI 認定講師見るだけ、落とすだけならアカウントなしでいける範囲はあります。ただ、自分でアップロードしたりSpacesを公開したりするならログインが前提になりますね。
室谷代表取締役あと、モデルによっては利用条件への同意が必要なものもあるんですよ。そこは素直に登録した方が早いです。
テキトー教師DotAI 認定講師そうですね。まず無料で登録して、触りながら慣れるのが結局一番早いと思います。
Q3. 日本語に強いモデルはどうやって探せばいいですか?
室谷代表取締役タスクや言語で絞り込めるようになっているので、そこから絞るのが基本ですね。
テキトー教師DotAI 認定講師現場でよく聞くのは「英語圏で評価が高いものをそのまま持ってきて、日本語で試したら今ひとつだった」というパターンです。日本語のタグが付いているものを起点にした方が早いですよ。
室谷代表取締役あとはダウンロード数と、更新が新しいかどうか。この2つを見ておけば大きく外すことは少ないです。
Q4. 使いたいモデルが思ったように動かないときは?
テキトー教師DotAI 認定講師まずモデルカードを読みます。想定している入力の形や呼び出し方が書いてあるので、そこが噛み合っていないケースが本当に多いんですよ。
室谷代表取締役あと、動かしている環境側のバージョンが合っていないパターン。ここは切り分けが面倒なんですけど、避けて通れないところです。
テキトー教師DotAI 認定講師同じモデルをSpaces側で動かしてみるのも手ですね。自分の環境の問題なのか、モデル側の問題なのかが切り分けられます。
Q5. Hugging Face以外の選択肢とはどう使い分ければいいですか?
室谷代表取締役クラウド各社がモデルのカタログを出していますし、API経由で呼ぶだけならそっちの方が楽な場面も多いんですよね。
テキトー教師DotAI 認定講師ただ、「中身を自分で触りたい」「重みを手元に落として動かしたい」となると、やっぱりここに戻ってくる印象です。
室谷代表取締役用途で分けるのが現実的で、APIで足りるならAPI、中身を調整したいならHugging Face、という整理でいいと思います。
まとめ
室谷代表取締役結局のところ、Hugging Faceは「モデルを探す・試す・配る」ための場所なんですよね。個人が触るにも、業務に組み込むにも、入口として強い。
テキトー教師DotAI 認定講師そうですね。最初から全部を理解しようとしなくてよくて、目的のモデルを1つ決めて動かしてみる、で十分だと思います。
室谷代表取締役うちの現場でも、まず小さく試してから本番に載せる順番にしてます。いきなり業務に組み込むと、ライセンス確認が後手に回るんですよ。
テキトー教師DotAI 認定講師そこは本当に大事で、配布元と利用条件だけは最初に見ておく。ここだけは飛ばさない方がいいです。
室谷代表取締役で、料金や仕様は変わるので、判断が必要なところは公式の最新情報を見に行ってください。この記事を鵜呑みにせず一次情報に当たるのが、結局一番早いです。