Claude Codeをローカルで動かせるって本当?Ollama・llama.cpp・LiteLLMの全セットアップ手順【2026年最新】
 室谷代表取締役
今回はClaude Codeをローカルで動かす話をしたいと思います。これ、.AI(ドットエーアイ)のコミュニティでも「APIコストを下げたい」「オフラインで使いたい」という声がかなり増えてきてますよね。
 テキトー教師DotAI 認定講師
ですね。「Claude Codeを使い始めたけど料金が怖い」という方がまず検索するのが「claude code ローカル」なんですよ。
実際に講座でも聞かれますし。ただ、ローカルLLMでClaude Codeを動かすのは「Claudeモデルそのものをローカルに持ってくる」わけじゃない点を最初に整理した方がいいですね。
実際に講座でも聞かれますし。ただ、ローカルLLMでClaude Codeを動かすのは「Claudeモデルそのものをローカルに持ってくる」わけじゃない点を最初に整理した方がいいですね。
室谷代表取締役そこ、誤解されやすいんですよね・・・。Claude(Anthropicのモデル)自体は公開されていないので、ローカルには持ってこれません。
「Claude Codeというツール(シェル)を、OllamaやLlama.cppなどのローカルLLMサーバーに向けて動かす」という構成になります。
「Claude Codeというツール(シェル)を、OllamaやLlama.cppなどのローカルLLMサーバーに向けて動かす」という構成になります。
テキトー教師DotAI 認定講師整理するとこういう構造です。
- 通常のClaude Code: Claude Codeツール → Anthropic APIサーバー → Claudeモデル
- ローカルLLM接続: Claude Codeツール → ローカルサーバー(Ollama等) → Qwen・Gemmaなどのオープンモデル
室谷代表取締役そう。だからClaude Codeの「AI頭脳」の部分がQwenやGemmaになる、ということです。
課金はゼロ。ただしClaude(Anthropicのモデル)を使っているわけではないので、性能は当然変わります。
課金はゼロ。ただしClaude(Anthropicのモデル)を使っているわけではないので、性能は当然変わります。
テキトー教師DotAI 認定講師「ローカルLLMで完全無料になる!」という部分だけが一人歩きしがちなんですが、実際のところメリット・デメリットの両方を理解した上で使うのが大事ですよね。
室谷代表取締役本当にそうで。MYUUUでも試してるんですが、「APIコストを気にせず気軽に試す用途」と「本番の開発」では使い方を完全に分けてます。
どちらが向いているかは、この記事を読んでいただければわかると思います。
どちらが向いているかは、この記事を読んでいただければわかると思います。
ローカルLLMでClaude Codeを使うメリット・デメリット
テキトー教師DotAI 認定講師まずメリットから整理しましょう。一番大きいのはやっぱりコスト面ですよね。
室谷代表取締役ローカルで動かせば課金がゼロになります。Claude Codeって、がっつり使うと1日で数ドル飛ぶこともありますから。
APIコストを気にせずガンガン試せるのは大きいですよね。
APIコストを気にせずガンガン試せるのは大きいですよね。
テキトー教師DotAI 認定講師2つ目がオフライン対応です。飛行機の中、ネット環境が不安定な場所でも動く。
2026年3月にAnthropicが複数回の障害を出したんですが、そういうときでもローカルなら関係ないです。
2026年3月にAnthropicが複数回の障害を出したんですが、そういうときでもローカルなら関係ないです。
室谷代表取締役あとプライバシーですね。コードをAnthropicのサーバーに送りたくない、という企業やプロジェクトも多い。
機密性の高いコードを扱うときは特に。
機密性の高いコードを扱うときは特に。
テキトー教師DotAI 認定講師ただ、デメリットも明確です。まずは性能面。
現在のローカルモデルでClaude Sonnetと同等のコーディング性能を出すのは難しいです。
現在のローカルモデルでClaude Sonnetと同等のコーディング性能を出すのは難しいです。
室谷代表取締役ハードウェア要件も高い。「claude code ローカル 無料」と調べてくる方の多くが、自分のPCスペックの確認を忘れがちなんですよね・・・。
8GB RAMだと厳しいことが多いです。
8GB RAMだと厳しいことが多いです。
テキトー教師DotAI 認定講師そうなんですよ。「無料でできる!」と思って試したら激遅だった、というのがローカルLLM初心者の方の典型的な失敗パターンです(笑)
ローカルLLM実行に必要なハードウェア
室谷代表取締役ハードウェアの話を先にしておきましょう。「claude code ローカル 環境」で検索してくる方向けに。
テキトー教師DotAI 認定講師目安をまとめるとこうなります。
| 構成 | 使えるモデルサイズ | 速度感 |
|---|---|---|
| 8GB RAM(CPU推論) | 3B〜7Bモデルが限界 | 非常に遅い(実用困難) |
| 16GB RAM(CPU推論) | 7B〜9Bモデル | 遅め(試用レベル) |
| M1/M2/M3 Mac 16GB | 9B〜14Bモデル | 実用的(Apple Siliconの統合メモリが効く) |
| M3/M4 Mac 24GB〜 | 27B〜35Bモデル | 快適 |
| VRAM 12GB(GPU) | 14Bモデル | 快適 |
| VRAM 24GB(GPU) | 32B〜35Bモデル | 快適 |
| VRAM 48GB〜 | 70Bモデル以上 | 快適 |
室谷代表取締役Apple Siliconはコスパがいいんですよね。M3 MacBook Pro 24GBだとQwen3.5の35Bモデルが快適に動きます。
テキトー教師DotAI 認定講師受講生さんからよく聞くのが「MacBook Air M2 8GBでいけますか?」という質問で、正直に言うと「試すことはできるが実用的ではない」というレベルです。7B以下のモデルなら動きますが、コーディングに使えるクオリティは出しにくいですね。
室谷代表取締役逆にWindowsやLinuxでNVIDIA GPUがある環境なら、RTX 4090(VRAM 24GB)あたりから本格的に使えます。海外だと「$500 GPUでClaude Sonnetレベルに迫れるか」みたいなベンチマーク記事も出てきてますよね。
テキトー教師DotAI 認定講師最低でも「Apple Silicon Mac 16GB以上」か「VRAM 12GB以上のGPU搭載PC」が現実的なラインです。
Ollamaを使ったセットアップ(最速・おすすめ)
室谷代表取締役セットアップの話に行きましょう。一番手軽なのはOllamaです。
「claude code ローカル 実行」で一番最初にたどり着く方法ですね。
「claude code ローカル 実行」で一番最初にたどり着く方法ですね。
テキトー教師DotAI 認定講師Ollamaは本当によくできていて、コマンド数行でローカルモデルサーバーを立ち上げられます。Claude Codeとの接続も簡単です。
室谷代表取締役まずOllamaのインストールから。公式サイト(ollama.com)からダウンロードするだけです。
Macならdmgファイル、Linuxはシェルスクリプト一発。
Macならdmgファイル、Linuxはシェルスクリプト一発。
テキトー教師DotAI 認定講師Windowsも対応しています。インストールしたら、次にモデルをダウンロードします。
「claude code ローカル モデル」として何を選べばいいかという話ですが、2026年現在のおすすめはQwen3.5です。
「claude code ローカル モデル」として何を選べばいいかという話ですが、2026年現在のおすすめはQwen3.5です。
室谷代表取締役コーディング用途でのローカルモデルの中で、今一番バランスが良いのがQwen3.5です。特に35B-A3Bというモデルは「MoE(Mixture of Experts)」アーキテクチャを採用していて、実効パラメータ数のわりに速いのが特徴です。
テキトー教師DotAI 認定講師サイズ選びの目安はこちらです。
- メモリ16GB以下: qwen3.5:9b(約6GB)
- メモリ16GB〜24GB: qwen3.5:14b(約9GB)
- メモリ24GB以上: qwen3.5:32b(約20GB)
室谷代表取締役Ollama経由でダウンロードするコマンドはこちらです。
bash
# モデルのダウンロード(例: Qwen3.5 9Bモデル)
ollama pull qwen3.5:9b

# サーバーが自動起動していない場合
ollama serveOllamaはインストールするとバックグラウンドサービスとして自動起動します。
http://localhost:11434でOpenAI互換のAPIエンドポイントが立ち上がります。室谷代表取締役次にClaude Codeの接続設定です。環境変数を2つ設定するだけです。
bash
# ローカルのOllamaサーバーに向ける
export ANTHROPIC_BASE_URL=http://localhost:11434

# ダミーのAPIキー(ローカルサーバーなので何でもOK)
export ANTHROPIC_API_KEY=sk-dummy-keyこの設定のまま、プロジェクトフォルダでClaude Codeを起動すれば使えます。
bash
cd /your/project
claude --model qwen3.5:latest--modelオプションでモデル名を明示的に指定するのが確実です。OllamaはOpenAI互換APIなのでClaude Codeがそのまま使えます。ここが設計としてうまいなと思いますよね・・・。
テキトー教師DotAI 認定講師永続化したい場合は、
~/.zshrcか~/.bashrcに追記しておくといいですよ。bash
# ~/.zshrc に追記
export ANTHROPIC_BASE_URL=http://localhost:11434
export ANTHROPIC_API_KEY=sk-dummy-keyただし注意点があって。Anthropic APIに戻したいときは必ず
設定したままClaudeモデルを使おうとすると接続エラーになります。
unset ANTHROPIC_BASE_URLしてください。設定したままClaudeモデルを使おうとすると接続エラーになります。
テキトー教師DotAI 認定講師「claude code ローカル ファイル」の話でいうと、Claude Codeはローカルファイルへのアクセスは通常と変わらず使えます。ローカルLLMに向けても、コードの読み書きはそのままできますよ。
llama.cppを使った高度なセットアップ
室谷代表取締役次がllama.cppを使うパターンです。Ollamaより設定は複雑ですが、パラメータを細かく制御できます。
テキトー教師DotAI 認定講師特にGPUの最大活用や、サンプリングパラメータの調整、コンテキスト長の制御をしたい場合はllama.cppの方が向いています。
室谷代表取締役インストール手順はOSによって異なります。Linuxの場合はこうなります。
bash
# 依存関係のインストール
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev git-all -y

# llama.cppのビルド(CUDA GPU使用の場合)
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first \
  --target llama-cli llama-server
cp llama.cpp/build/bin/llama-* llama.cppApple Macの場合は
-DGGML_CUDA=OFFにするだけで、Metal(GPU)のサポートは自動で有効になります。室谷代表取締役モデルファイル(GGUF形式)はHugging Faceからダウンロードします。Unslothが量子化済みのモデルを大量に公開していて、使いやすいです。
bash
pip install huggingface_hub hf_transfer

# Qwen3.5-35B-A3B(MoE版・24GB VRAMに収まるサイズ)
hf download unsloth/Qwen3.5-35B-A3B-GGUF \
  --local-dir unsloth/Qwen3.5-35B-A3B-GGUF \
--include "*UD-Q4_K_XL*"UD-Q4_K_XLは量子化精度の指定です。4bit量子化で、サイズと精度のバランスが良いと言われています。室谷代表取締役llama-serverの起動コマンドはこちらです。
bash
./llama.cpp/llama-server \
  --model unsloth/Qwen3.5-35B-A3B-GGUF/Qwen3.5-35B-A3B-UD-Q4_K_XL.gguf \
  --alias "qwen3.5:35b" \
  --temp 0.6 \
  --top-p 0.95 \
  --top-k 20 \
  --port 8001 \
--ctx-size 131072--ctx-size 131072は131Kトークンのコンテキスト長を意味します。コードベースが大きい場合はここを増やすと良いですが、VRAMをより多く使います。室谷代表取締役Claude Codeとの接続はOllamaと同様です。ポートが8001の場合はこうなります。
bash
export ANTHROPIC_BASE_URL=http://localhost:8001
export ANTHROPIC_API_KEY=sk-dummy-keyllama.cppを使う場合、一点注意があります。Claude Codeは最近「Attribution Header」というヘッダーをAPIリクエストに付加するようになったんですが、これがローカルLLMのKVキャッシュを無効化して推論が遅くなるケースがあります。
室谷代表取締役これ、気づいている人が少ない話です。
~/.claude/settings.jsonに以下を追加するだけで解決します。json
{
  "env": {
    "CLAUDE_CODE_ATTRIBUTION_HEADER": "0"
  }
}環境変数で
export CLAUDE_CODE_ATTRIBUTION_HEADER=0としても効かないので、settings.jsonに書く必要があります。ここはハマりポイントなので覚えておいてください。LiteLLMを経由した接続
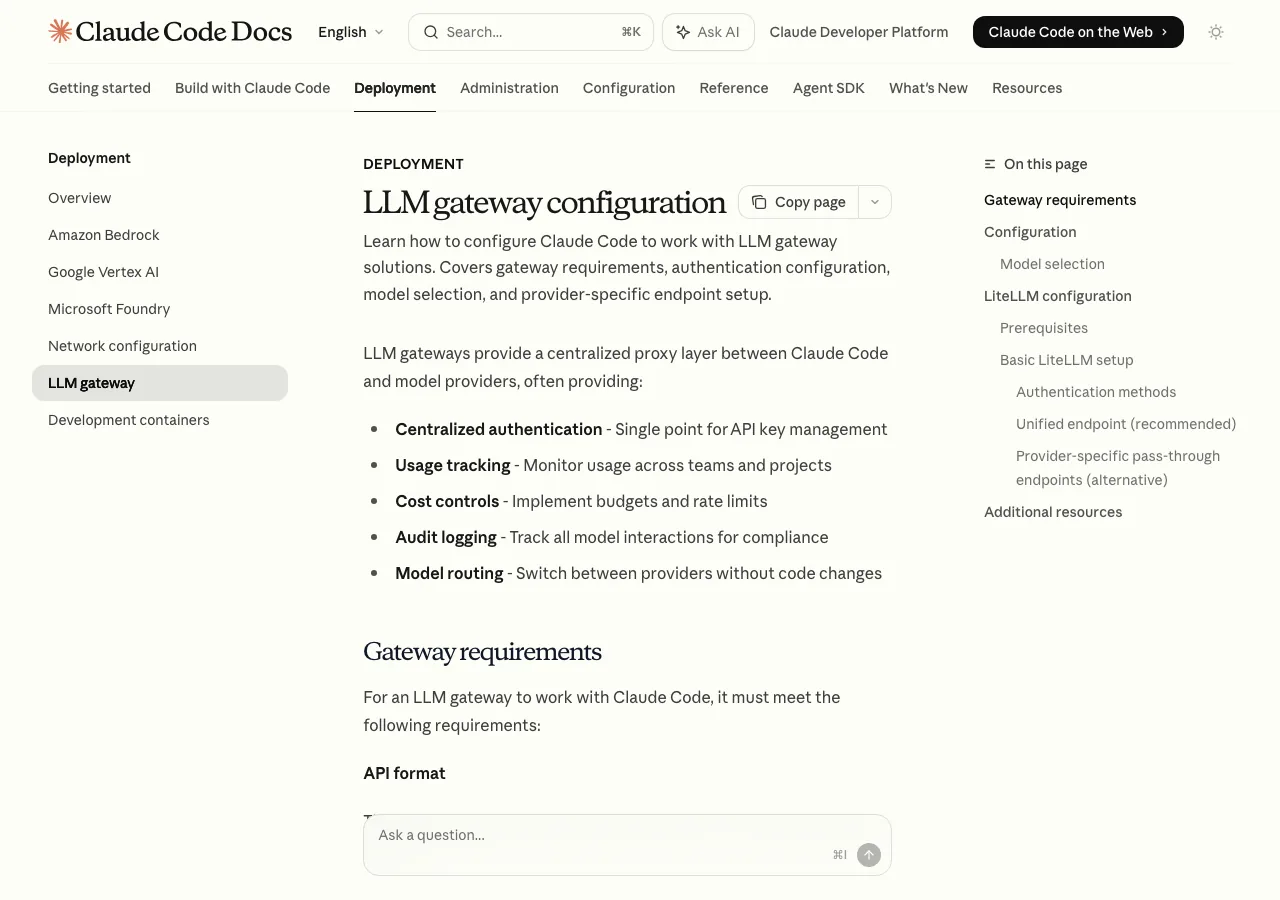
室谷代表取締役もう1つの方法がLiteLLMゲートウェイです。複数のモデルを切り替えて使いたい場合や、チームでローカルモデルを共有したい場合に便利です。
テキトー教師DotAI 認定講師LiteLLMはさまざまなLLMプロバイダーのAPIを統一したOpenAI互換インターフェースで提供するプロキシです。Ollama、Groq、Together AI、Bedrockなど、何十種類ものバックエンドをまとめて管理できます。
室谷代表取締役テキトー教師DotAI 認定講師ただ、1つ重要な注意事項があります。LiteLLMのバージョン1.82.7と1.82.8はセキュリティ上の問題(クレデンシャル盗取マルウェアが混入)が確認されています。
これらのバージョンはインストールしないでください。
これらのバージョンはインストールしないでください。
室谷代表取締役Anthropicの公式ドキュメントにも明記されているので、pip installする前にバージョンを確認するクセをつけましょう。
テキトー教師DotAI 認定講師LiteLLMを起動したら、Claude Codeの接続設定はこちらです。
bash
# LiteLLMのデフォルトポートは4000
export ANTHROPIC_BASE_URL=http://localhost:4000
export ANTHROPIC_AUTH_TOKEN=sk-litellm-your-keyLiteLLMを使う利点は「チーム全体でローカルモデルを共有できる」点ですね。LiteLLMサーバーを1台立てて、チームメンバーがそこに接続する構成が取れます。
MYUUUでも将来的にこういう構成を考えています。
MYUUUでも将来的にこういう構成を考えています。
おすすめのローカルモデル比較(2026年4月時点)
テキトー教師DotAI 認定講師「claude code ローカル llm」で検索する方向けに、現時点でのモデル比較もまとめておきましょう。
室谷代表取締役2026年4月時点で、コーディング用途のローカルモデルはかなり充実してきています。
| モデル | パラメータ | 必要メモリ目安 | コーディング性能 |
|---|---|---|---|
| Qwen3.5-35B-A3B(MoE) | 35B(実効3B) | VRAM/RAM 24GB | 高い(おすすめ) |
| Qwen3.5-27B | 27B | VRAM/RAM 18GB〜 | 高い |
| Qwen3.5-14B | 14B | VRAM/RAM 10GB〜 | 中〜高 |
| Qwen3.5-9B | 9B | VRAM/RAM 7GB〜 | 中 |
| GLM-4.7-Flash | 7B | VRAM/RAM 5GB〜 | 中 |
| Devstral | 24B | VRAM/RAM 16GB〜 | 高い(コード特化) |
テキトー教師DotAI 認定講師Qwen3.5の35B-A3Bが今一番コスパ良いですね。「A3B」はアクティブパラメータが3Bという意味で、MoEモデルは全パラメータのうち一部だけを各推論で使うため、35Bの割に速く動きます。
室谷代表取締役Devstralというモデルも注目です。Mistralが出したコーディング特化モデルで、24GBのGPUで256Kコンテキストが動くという報告もあります。
テキトー教師DotAI 認定講師ただ、どのモデルもClaude Sonnetのコーディング性能にはまだ及ばない部分があります。特に複数ファイルにまたがる変更や、複雑なリファクタリングになると差が出てきます。
室谷代表取締役使い分けのイメージとしては、「細かい修正・バグ修正・コード説明・ボイラープレート生成」はローカルモデルで十分、「複雑なアーキテクチャ設計・大規模リファクタリング」はClaudeモデル(API経由)という感じが現実的です。
テキトー教師DotAI 認定講師受講生さんには「まずProプランで3週間使ってみて、どんな作業に使っているかを把握してから、その中でローカルに移せそうな作業を探す」というアプローチをすすめています。いきなりローカル100%にしようとしても失敗しやすいです。
Windows環境でのローカル設定
室谷代表取締役WindowsユーザーはMacやLinuxと少し設定が違います。「claude code ローカル llm windows」で検索してくる方向けに補足します。
テキトー教師DotAI 認定講師Windowsの場合、環境変数の設定にPowerShellを使います。
powershell
# 現在のセッションのみ有効
$env:ANTHROPIC_BASE_URL = "http://localhost:11434"
$env:ANTHROPIC_API_KEY = "sk-dummy-key"

# 永続化する場合
setx ANTHROPIC_BASE_URL "http://localhost:11434"
setx ANTHROPIC_API_KEY "sk-dummy-key"WindowsでOllamaやllama.cppを使う場合、CUDA対応のバイナリが必要です。NVIDIA GPUがある場合はCUDA Toolkit(バージョン12.x推奨)を先にインストールしておくと、GPU推論が効きます。
テキトー教師DotAI 認定講師MCPとの連携についても触れておくと、ローカルLLM構成でもMCPは普通に使えます。MCPはClaude Codeのツール側の話で、LLMの接続先とは独立しているからです。
よくある問題とトラブルシューティング
室谷代表取締役トラブルシューティングも整理しておきましょう。
テキトー教師DotAI 認定講師「Unable to connect to API (ConnectionRefused)」というエラーが一番多いです。これは
ANTHROPIC_BASE_URLを設定したままローカルサーバーが起動していないときに起きます。bash
# Ollamaが起動しているか確認
curl http://localhost:11434/api/tags

# 起動していない場合
ollama serveあと「ANTHROPIC_BASE_URLを設定したままAnthropicに戻れない」という問題も多いですよね。
bash
# ローカルLLM設定を解除する
unset ANTHROPIC_BASE_URL
unset ANTHROPIC_API_KEY「推論が異常に遅い」場合は、先ほど説明したKVキャッシュの問題か、モデルサイズに対してVRAM/RAMが不足してスワップが発生しているケースです。
htopやnvidia-smiでメモリ使用量を確認してみてください。室谷代表取締役サインイン画面が出てきて先に進めないという場合は、
~/.claude.jsonに以下を追加します。json
{
  "hasCompletedOnboarding": true,
  "primaryApiKey": "sk-dummy-key"
}これはローカルLLMに接続するとき、Claude Codeがローカルサーバーに対してAnthropicと同じ認証を求めてしまうためです。ダミーキーを設定することで回避できます。
ローカルLLMとClaude Codeの賢い使い分け
室谷代表取締役実際の運用の話をしましょう。「ローカルLLMで全部解決!」じゃなくて、賢い使い分けが大事です。
テキトー教師DotAI 認定講師講座で教えていて気づいたんですが、ローカルLLMが輝くユースケースって結構限定的なんですよ。
室谷代表取締役うちのチームでの実感としては、こういう感じです。
- ローカルLLMが向いている: コードの読み取りと説明、シンプルな関数の生成、スタイルの修正、ドキュメント生成、APIコストを気にせずガンガン試したい探索フェーズ
- ClaudeのAPIが必要: 複数ファイルにまたがるリファクタリング、アーキテクチャの設計、バグの根本原因分析、テスト戦略の策定
テキトー教師DotAI 認定講師もう1つ面白いパターンが「Claudeでタスク設計→ローカルLLMでコード生成」という組み合わせです。コミュニティのメンバーさんが試していて、コスト削減と品質のバランスが良かったと言っていました。
室谷代表取締役それ、すごくスマートな使い方ですね。設計フェーズ(コンテキストが大事)はClaude、実装フェーズ(パターンを繰り返す)はローカルLLM、という棲み分けですよね。
まとめ
テキトー教師DotAI 認定講師まとめると、Claude Codeとローカルモデルを連携させる方法は大きく3つです。
室谷代表取締役整理するとこうなります。
- Ollama(初心者向け): インストールが最も簡単。
ANTHROPIC_BASE_URL=http://localhost:11434を設定するだけ。まずはここから始めるのがおすすめ - llama.cpp(上級者向け): パラメータを細かく制御できる。VRAM効率も高め。KVキャッシュ問題はsettings.jsonで対処
- LiteLLM(チーム利用向け): 複数モデルをまとめて管理。バージョン1.82.7/1.82.8はセキュリティ問題あり
テキトー教師DotAI 認定講師ハードウェア的には「Apple Silicon Mac 16GB以上」か「VRAM 12GB以上のGPU」が現実的なラインです。8GB RAM CPUだと試せても実用は厳しいです。
室谷代表取締役モデルはQwen3.5シリーズが2026年4月時点でのベストチョイスです。コーディング性能、速度、量子化モデルの充実度から見ても。
テキトー教師DotAI 認定講師ローカルLLMは「Claude Codeの完全な代替」ではなく「APIコスト削減と探索用途の補完ツール」として使うのが現実的です。この認識を持って使い始めると、期待値のズレも少なくなりますよ。
室谷代表取締役ローカルLLMの世界は進化が速いので、定期的に新しいモデルをチェックしておくと良いですね。半年前には「ローカルでは無理」と言われていたことが、今は普通にできる時代になってきています。
よくある質問(FAQ)
Q: Claude CodeでローカルLLMを使うと、Claudeモデルの料金はかかりますか?
ローカルLLM(Ollama・llama.cppなど)に接続している場合は、Anthropic APIへの接続は行われないため、Claudeモデルの料金はかかりません。ただしClaude Code自体の月額(Pro/Maxプラン)は継続して必要です。
Q: Claude Codeをローカルで無料で使いたいのですが、サインインなしで動かせますか?
Claude Codeはnpmパッケージとして無料でインストールできます(npm install -g @anthropic-ai/claude-code)。ローカルLLMに接続して使う場合、Anthropicへのサインインなしで動作させることも可能です。~/.claude.jsonにダミーキーを設定する方法が有効です。
Q: ローカルモデルとClaudeモデルを簡単に切り替えられますか?
切り替え自体はできますが、毎回環境変数を変更する必要があります。.zshrcにエイリアスを登録しておくと便利です。
bash
# ~/.zshrc に追加
alias cc-local='export ANTHROPIC_BASE_URL=http://localhost:11434 && export ANTHROPIC_API_KEY=sk-dummy && claude'
alias cc-cloud='unset ANTHROPIC_BASE_URL && unset ANTHROPIC_API_KEY && claude'
Q: M1/M2/M3 MacでWindowsより速く動くのはなぜですか?
Apple SiliconはCPUとGPUが統合メモリを共有しているため、モデルの重みをGPUとCPUの間で移動させるオーバーヘッドがありません。16GBのMacは実質16GBのGPUメモリとして使えます。同じ16GBのWindows PC(CPUのみ)より大きなモデルを快適に動かせます。