Stable Diffusionで動画は作れるのか?先に結論を言うと
画像生成モデルと動画生成モデルは何が違うのか
 室谷代表取締役
まず地図をはっきりさせておきたいんですけど、Stable Diffusion って名前が付いていても、画像を出すモデルと動画を出すモデルは別物なんですよね。ここを混ぜて語ると議論が噛み合わないまま終わるんですよ。
 テキトー教師DotAI 認定講師
たしかに。初めて触る人が最初に戸惑うのがまさにそこなんです。
「Stable Diffusionを入れたのに動画が出てこない」で止まってしまう。画像1枚を作るのが本体の仕事で、動きの部分は別の部品が担当する、という分担が見えないまま進みがちなんですよね。
「Stable Diffusionを入れたのに動画が出てこない」で止まってしまう。画像1枚を作るのが本体の仕事で、動きの部分は別の部品が担当する、という分担が見えないまま進みがちなんですよね。
室谷代表取締役だから記事としても、最初に「何を使えばいいか」を分けて出すのが親切だと思ってます。画像モデルと動画モデルを同じ土台で比べると混乱しますから、まず道具の名前を並べるのが先なんです。
テキトー教師DotAI 認定講師賛成です。2系統に分けて、そのあと目的別に絞る。
この順番で行くと、途中で迷子にならないはずです。
この順番で行くと、途中で迷子にならないはずです。
拡張機能で動かす系統と、専用の動画生成モデルを使う系統
室谷代表取締役系統は2つなんですよ。ひとつは WebUI や ComfyUI に拡張機能を足して動かすやり方で、AnimateDiff、Deforum、mov2mov あたりが代表ですね。
既存の画像モデルをそのまま使う延長線上にあるので、手持ちの環境が活かせます。
既存の画像モデルをそのまま使う延長線上にあるので、手持ちの環境が活かせます。
テキトー教師DotAI 認定講師もうひとつが Stability AI の Stable Video Diffusion です。こちらは最初から動画用に作られたモデルなので、写真を1枚渡して動かす、という入り口になるんですよ。
同じ「動画を作る」でも発想がまるで違います。
同じ「動画を作る」でも発想がまるで違います。
室谷代表取締役テキトー教師DotAI 認定講師現場でよく聞くのが、拡張機能から先に手を出して本体が入っていない、という順番のミスなんです。先に土台を用意する、それだけでも詰まり方が変わります。
目的別の選び分け(アニメ調・実写の変換・1枚の写真を動かす)
室谷代表取締役選び分けは、作りたい絵の種類でほぼ決まるんですよ。アニメ調のキャラを動かしたいなら AnimateDiff 系、実写の動画を絵柄ごと変換したいなら mov2mov、カメラワークで映像を作りたいなら Deforum、写真1枚から動かすなら SVD。
この住み分けで考えれば迷いにくいです。
この住み分けで考えれば迷いにくいです。
テキトー教師DotAI 認定講師ここで大事なのが、入力の違いを意識することなんです。テキストから動かすのか、動画を変換するのか、画像を1枚動かすのか。
最初にそこを押さえるだけで、使う道具が自分で選べるようになります。
最初にそこを押さえるだけで、使う道具が自分で選べるようになります。
室谷代表取締役うちの現場だと、用途が決まらないままツールを触り始めるのが一番コストが高いんですよね。時給で換算すると、試行の往復がじわじわ効いてくる。
先に絵の種類を決めてから手を動かすほうが、結果的に早いんです。
先に絵の種類を決めてから手を動かすほうが、結果的に早いんです。
テキトー教師DotAI 認定講師その順番、ほんとに大事です。では次の章から、それぞれの仕組みを1つずつ見ていきましょう。
AnimateDiffはなぜ追加学習なしで動くのか、WebUI版の使い方と落とし穴
学習済みモーションモジュールを差し込むという仕組み
室谷代表取締役AnimateDiffの面白さって、モデルを一から学習させるんじゃなくて、動きの部分だけを後から足せる点なんですよね。ICLR2024のSpotlightに採択されてるって聞くと、妙に納得します。
テキトー教師DotAI 認定講師そこが一番の売りですよね。手持ちの好きなモデルはそのまま使えて、動きのモジュールを差し替えるだけで映像になる。
絵柄を諦めなくていいのが大きいです。
絵柄を諦めなくていいのが大きいです。
室谷代表取締役公式リポジトリはApache-2.0で、メインブランチがSD1.5用、SDXL用はsdxl-betaブランチに分かれてる。中身を追うならそこを見れば足ります。
テキトー教師DotAI 認定講師モデルを選ぶ段階で「あれ、どっちのブランチだっけ」で手が止まる人は多いので、先に把握しておくと迷わないです。
sd-webui-animatediffの導入手順と生成の流れ
- Stable Diffusion WebUI(AUTOMATIC1111)をローカルに用意する
- WebUIの「Extensions」タブを開き、sd-webui-animatediffを追加する
- 動きのモジュールをダウンロードして配置する(配置先は公式READMEの指示に従う)
- プロンプトを入れて生成を実行し、結果を確認する
テキトー教師DotAI 認定講師手順だけ見ると短いんですが、WebUI本体の操作に慣れていないと、まずそこが山になります。基本の画面はStable Diffusion Web UIの使い方|AUTOMATIC1111版の導入と2026年の選び方にまとまってます。
室谷代表取締役既存のモデルをそのまま使えるから、モデルを選び直すコストが発生しないのが効くんですよ。学習を回す時間を人件費で換算すると、試行までの距離が全然違ってきます。
テキトー教師DotAI 認定講師生成の設定は、まず短い尺で何本か試すのが現実的ですね。長い尺で一発狙うと、どこを直せばいいのか分からなくなりがちです。
室谷代表取締役そういう試行の回しやすさは、そのまま制作のスピードになる。動画は単価が高いぶん、初速の差が売上に直結しますから。
ここが実務の落とし穴、WebUI拡張は非商用ライセンス
室谷代表取締役ただし、sd-webui-animatediffは作者が非商用ライセンスを採用していて、商用目的で使うなら作者への個別連絡が必要だと明記されてる。ここ、見落とすと後で止まります。
テキトー教師DotAI 認定講師個人で遊んでいる分には気にしない人が多いんですが、案件に組み込んだ瞬間に話が変わりますよね。動いてるものを見てから調べると、けっこう戻れないんですよ。
室谷代表取締役うちみたいに納品物を作る側だと、この一行で一旦止める判断になる。UIが使いやすくても、ライセンスが合わなければ別ルートに切り替える。
技術の優劣より先に、そこを見るのが順番です。
技術の優劣より先に、そこを見るのが順番です。
テキトー教師DotAI 認定講師同じAnimateDiffでも、ComfyUI側の拡張はApache-2.0なんですよね。入口が違うだけで条件が変わるので、最初に確認しておく価値は大きいです。
今の主流はComfyUI版AnimateDiff-Evolved、WebUI版と何が違う?
ComfyUI版に移っている人が多い理由
ComfyUI版AnimateDiff-Evolvedの導入手順
- 01AnimateDiff EvolvedをインストールComfyUI Managerで「AnimateDiff Evolved」を検索してインストール
- 02モーションモジュールをダウンロード例: mm_sd_v15_v2
- 03Motion LoRAをダウンロード動きを指定したい場合は別途ダウンロード
- 04所定のフォルダに配置モーションモジュールとMotion LoRAをcustom_nodes配下などへ
室谷代表取締役ComfyUI版のAnimateDiff-Evolved、ノードで組む前提だとWebUIの拡張版とは別物になってるんですよ。対応している手法の幅が広くて、AnimateDiffのv1/v2/v3にSDXL版、AnimateLCMやPIA、CameraCtrlまで載ってる。
テキトー教師DotAI 認定講師そこが大きいですね。ただ、初めて触る人はノード画面を開いた瞬間に「どこから手を付けるのか」で固まりがちです。
まずはManagerから入れるところまで行くと、景色が変わりますよ。
まずはManagerから入れるところまで行くと、景色が変わりますよ。
室谷代表取締役手順、先に置いておきますか。
- ComfyUI Managerで「AnimateDiff Evolved」を検索してインストール
- 使いたいモーションモジュール(例: mm_sd_v15_v2)をダウンロード
- 動きを指定したい場合はMotion LoRAも別途ダウンロード
- モーションモジュールとMotion LoRAを所定のフォルダ(custom_nodes配下など)に配置
テキトー教師DotAI 認定講師本体とモーションモジュールは別物なので、2と3を飛ばすと「入れたのに動かない」になります。ここが一番つまずくところですね。
Context Optionsで長さの制限を外す考え方
室谷代表取締役長尺を作るならContext Optionsが効きます。理論上は無制限の長さまで伸ばせる。
短いカットを繋ぐ前提で絵コンテを引くのと、一本物として設計するのとでは、工程の組み方が変わってくるんですよね。
短いカットを繋ぐ前提で絵コンテを引くのと、一本物として設計するのとでは、工程の組み方が変わってくるんですよね。
テキトー教師DotAI 認定講師発想の切り替えが要るところです。数秒単位で切って繋ぐ前提だと、繋ぎ目をどう誤魔化すかに意識が行きがちなんです。
後から伸ばせるなら、構図と動きの一貫性を先に決めたほうがラクですね。
後から伸ばせるなら、構図と動きの一貫性を先に決めたほうがラクですね。
室谷代表取締役制作の進め方そのものが変わる、と。試作を何回回せるかは、後工程で伸ばせるかどうかに直結しますから。
Motion LoRAで動きの種類を指定する
テキトー教師DotAI 認定講師動きの指定はMotion LoRAで種類を選ぶ形になります。プロンプトで「ゆっくりズーム」と書くのとは別のレイヤーなので、最初は戸惑いますね。
室谷代表取締役プロンプトだけで全部制御しようとすると破綻するんですよ。動きはモジュール側、絵柄はcheckpoint側、と役割を分けて考えるのが結局は早い。
テキトー教師DotAI 認定講師分けておくと、うまくいかなかったときにどこを直すかが分かりますからね。
ControlNetやIPAdapterと組み合わせる実務的な使いどころ
室谷代表取締役実務だと、ComfyUIの強みは組み合わせなんですよ。ControlNetで構図を固定して、IPAdapterでキャラの見た目を寄せる。
それが1つのグラフで完結する。
それが1つのグラフで完結する。
テキトー教師DotAI 認定講師構図が毎フレーム揺れると使い物にならないので、そこを固定できるのは大きいです。checkpointをSDXL系にするなら、SDXLは何ができる?必要スペックと商用利用の線引きも読んでおくと選びやすいですよ。
室谷代表取締役単発のデモで終わるツールと、ワークフローに固定できるツールでは、導入の判断がまるで違ってくる。そこを見極めたいところですね。
Deforumとmov2mov、この2つはどんな場面で使う拡張機能なのか
Deforumとmov2movの使い分け
Deforum
- 1枚の絵がじわじわ別の絵に変わる映像を作る
- カメラ移動やズームをキーフレーミング関数(数式)で書く
- MVっぽいループ映像や背景素材づくりに向く
- 1本作れば別案件でも使い回せる
- 人を歩かせたい・キャラを動かしたい用途には向かない
- 3Dモードは標準でVRAM約6.4GB、--lowvramで約3.8GB
mov2mov
- 既存の動画を1フレームずつ画像処理して動画に書き戻す
- 絵柄だけを差し替えるイメージ
- 撮影済み実写素材をアニメ調にしたい案件に向く
- フレーム間で色がぱたつく(フリッカー)
- キーフレーム合成でフリッカーを抑える機能あり
- bg-maskプラグイン併用がすすめられている
Deforumは数式でカメラ移動とズームを設計する
室谷代表取締役Deforumは、1枚の絵がじわじわ別の絵に変わっていく映像を作る拡張なんですよね。プロンプトに加えて、カメラの移動やズームをキーフレーミング関数という数式で書く。
AnimateDiffとは出力の性格がまるで違うんですよ。
AnimateDiffとは出力の性格がまるで違うんですよ。
テキトー教師DotAI 認定講師たしかに。AnimateDiffは学習済みのモーションモジュールを既存のStable Diffusionモデルに差し込んで、追加学習なしで短いアニメを作る仕組みです。
Deforumはモデルを差し替えるんじゃなくて、同じ絵を数式で泳がせる。手を動かす場所が全然違います。
Deforumはモデルを差し替えるんじゃなくて、同じ絵を数式で泳がせる。手を動かす場所が全然違います。
室谷代表取締役うちの現場だと、DeforumはMVっぽいループ映像とか、背景に流す素材づくりで使うことが多いですね。1本作れば別の案件でも使い回せるので、そこはコスト的に助かる。
テキトー教師DotAI 認定講師逆に「人を歩かせたい」「キャラを動かしたい」だとDeforumは向かないです。プロンプトと数式の効き方で絵が変わるので、思い通りに寄せるまでが長いんですよ。
DeforumのVRAM消費と--lowvramで抑える話
- WebUIの「Extensions」タブから sd-webui-deforum を入れる(git cloneでextensionsフォルダに置く方法もある)
- 3Dモードは標準設定でVRAMを約6.4GB消費する
- 起動オプションに「--lowvram」を付けると、3Dモードでも約3.8GBまで抑えられる
室谷代表取締役6.4GBか3.8GBか、って聞くと大差ないように見えるんですけど、手元のGPUで動くかどうかの分かれ目になるんですよね。
テキトー教師DotAI 認定講師そうなんです。3Dモードを触ろうとして途中で落ちる、というのはだいたいここが原因です。
先に「--lowvram」を付けて起動しておくと、作業が中断されずに済みます。
先に「--lowvram」を付けて起動しておくと、作業が中断されずに済みます。
室谷代表取締役mov2movは既存の動画を1フレームずつ作り直す
テキトー教師DotAI 認定講師mov2movは名前の通り、手持ちの動画を1フレームずつ画像として処理して、また動画に書き戻す拡張です。絵柄だけを差し替えるイメージですね。
WebUIの「Extensions」タブから「Install from URL」でリポジトリURLを入れて入れます。
WebUIの「Extensions」タブから「Install from URL」でリポジトリURLを入れて入れます。
室谷代表取締役なるほど。じゃあ撮影済みの実写素材をアニメ調にしたい、みたいな案件だとDeforumより素直にハマるわけですか。
テキトー教師DotAI 認定講師はい。ただ1フレームずつ別々に生成するので、フレーム間で色がぱたつくんですよ。
キーフレーム合成でフリッカーを抑える機能が入っていて、背景マスク用の「bg-mask」プラグインと併用するのがすすめられています。
キーフレーム合成でフリッカーを抑える機能が入っていて、背景マスク用の「bg-mask」プラグインと併用するのがすすめられています。
室谷代表取締役フリッカーって、素人目に見ると一気に安っぽく見えるやつですもんね。仕上げの品質に直結する工程なんだ。
変換元動画の著作権確認とクレジット表記という前提条件
室谷代表取締役mov2mov、業務で使うとなると一番引っかかるのがそこなんですよ。公式のREADMEにも、変換元の動画の著作権や利用許諾を確認する責任は使う側にある、と書かれています。
テキトー教師DotAI 認定講師さらに、変換後の動画を公開するときは元動画の出典を明記する必要がある、とも書かれています。技術的には簡単になった分、ここで手が止まる人は多いですね。
室谷代表取締役制作の現場だと、ここが曖昧なまま走り出すのが一番怖い。権利確認が済んでいない素材は、どれだけ画が良くても使わない、という線を先に引いておくべきなんですよね。
Stable Video Diffusionは何ができて、何ができないのか
Stable Video Diffusionのできること・できないこと
できること
- 画像1枚を入力して動かすimage-to-video
- 1カットを短く動かす映像生成
- 14フレーム版と25フレーム版の2種類
- fpsは3〜30の範囲で指定可能
- diffusersでローカル生成できる
- stable-video-diffusion-img2vid-xtは576x1024・最大25フレーム・約2Bパラメータ
できないこと・苦手なこと
- テキストから動画を作る(text-to-video)こと
- テキストプロンプトで動きを制御すること
- 長いカットの生成(動画は短く4秒以下)
- 文字を読める形で生成すること
- 顔や人物を正しく出すこと(失敗することがある)
- 動きがほぼない/ゆっくりしたカメラパンになる場合がある
画像1枚を入力にするimage-to-videoという立ち位置
室谷代表取締役Stable Video Diffusionは、テキストから動画を作るモデルではないんですよね。画像を1枚渡して、その絵を動かすimage-to-videoのモデル。
Stable Diffusionで動画を作る話の中では、AnimateDiff系とはそもそも系統が違うポジションです。
Stable Diffusionで動画を作る話の中では、AnimateDiff系とはそもそも系統が違うポジションです。
テキトー教師DotAI 認定講師たしかに。プロンプトを打てば動画が出てくると思って触ると空振りするんですよ。
実際は画像ありきで、その1枚がわずかに動く映像が返ってくる。
実際は画像ありきで、その1枚がわずかに動く映像が返ってくる。
室谷代表取締役発想としては絵コンテの1コマを動かす感じです。事業側の感覚で言えば、静止画の素材を少しだけ動かして広告のアイキャッチに使う、くらいの距離感。
テキトー教師DotAI 認定講師そうですね。長いカットを作る道具ではなく、1カットを短く動かす道具として見たほうがしっくりきます。
14フレーム版と25フレーム版、fpsと生成時間の目安
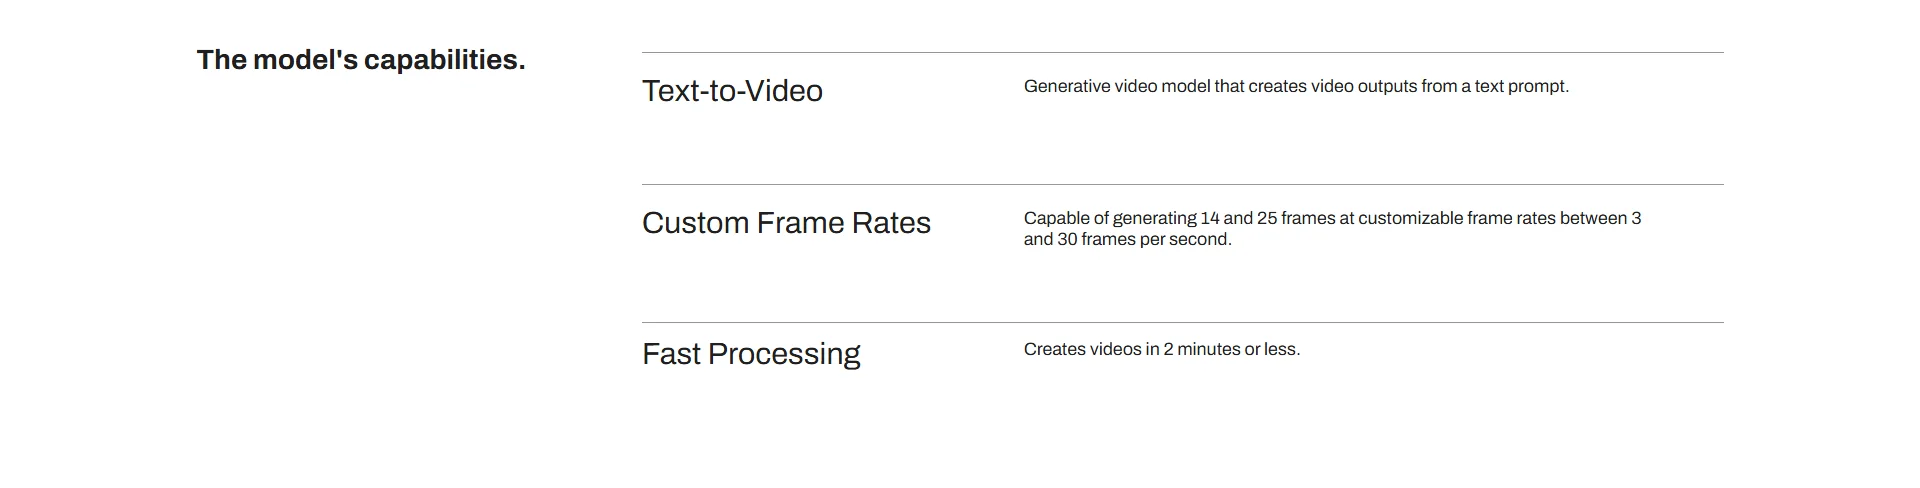
室谷代表取締役種類は14フレーム版と25フレーム版の2つで、フレームレートは3〜30fpsの範囲で指定できる。ここ、数字の読み方を間違えると期待値がずれます。
テキトー教師DotAI 認定講師フレーム数は動かせる長さの上限に関わってきますが、fpsを下げれば秒数は伸びるので、25フレーム=長い動画、ではないんですよね。秒数とコマ数の両方を見る必要があります。
室谷代表取締役公式は生成時間「2分以内」をうたっている。ただこれは提供側の環境の話で、手元のマシンで回したときの数字とは別物と考えたほうがいい。
テキトー教師DotAI 認定講師そこは混同されやすいので、公式の謳い文句として受け取っておくのが安全です。
diffusersでローカル生成するときの現実的な待ち時間
室谷代表取締役Hugging Faceで重みが公開されていて、diffusersから画像を渡すだけでローカル生成できる。stable-video-diffusion-img2vid-xtが576x1024で最大25フレーム、約2Bパラメータという構成です。
テキトー教師DotAI 認定講師待ち時間の目安は公式モデルカードに書かれていて、A100 80GBで約180秒。無印のSVDだと約100秒という記載です。
室谷代表取締役A100で3分ですから、手元のGPUならそれを上回る前提になる。1本作るたびに数分待つとなると、試行回数を稼ぎにくいのが正直なところです。
テキトー教師DotAI 認定講師公式モデルカードが認めている限界
室谷代表取締役モデルカードがかなり正直で、生成される動画は短く4秒以下。動きがほぼない、あるいはゆっくりしたカメラパンになる場合があるとも明記されている。
テキトー教師DotAI 認定講師テキストプロンプトで動きを制御できないのも書かれていますね。文字を読める形で生成できない、顔や人物が正しく出ないことがある、とも。
室谷代表取締役動画生成AIに期待する人が最初にがっかりするポイントが、先に全部書いてあるわけです。裏を返せば、短いカットを静かに動かす用途なら噛み合う。
テキトー教師DotAI 認定講師何を作りたいかで評価が真逆になりますから、触る前にここを読んでおくのが一番の近道ですね。
Stable Video Diffusionは商用利用できる?情報が古いまま出回っている問題
Stable Video Diffusionの商用利用をめぐる状況の変化
- 2023年11月研究プレビューとして発表「現段階では実世界での利用や商用アプリケーションを意図したものではない」という位置づけ
- 現在公式モデルカードの記載が変化「非商用・商用のいずれの用途も想定している」と記載。商用利用時はライセンス確認を案内
- 確認の前提stability.ai/license を確認使う前にライセンスを確認し、見た日付も残す
2023年11月の発表文は「商用を想定していない」だった
室谷代表取締役SVDの商用利用、ネット上だと「不可」で止まってる情報が多いんですよ。ただ発表当時の原文をたどると、2023年11月のリリース時点では「現段階では実世界での利用や商用アプリケーションを意図したものではない」という研究プレビュー扱いだった、というのが正確なところなんですよね。
テキトー教師DotAI 認定講師たしかに。そこだけ切り取られて「商用NGのモデル」として広まった印象があります。
当時の発表を読んだ人が、そのまま書き留めたものが残っているんでしょうね。
当時の発表を読んだ人が、そのまま書き留めたものが残っているんでしょうね。
室谷代表取締役そうなんですよ。で、これはSVDに限った話じゃなくて、動画生成まわりのモデルは発表時と現在で条件が動くのが普通なんですよ。
事業側からすると、その前提が動く前提で一次情報を追うコストを誰が持つのか、という話になる・・・
事業側からすると、その前提が動く前提で一次情報を追うコストを誰が持つのか、という話になる・・・
今のモデルカードは「商用も想定」、ただし確認が前提
テキトー教師DotAI 認定講師今のHugging Faceの公式モデルカードを開くと、書き方が変わっているんですよね。「非商用・商用のいずれの用途も想定している」と書かれていて、商用で使う場合はライセンスを確認するよう案内されています。
室谷代表取締役つまり「不可」で固定じゃなくて、「使う前にライセンスを確認する」が現在の公式スタンス。ここは曖昧にせず、stability.ai/license を見に行くのが前提なんですよね。
判断が変わる可能性がある以上、見た日付も一緒に残しておくべきですし。
判断が変わる可能性がある以上、見た日付も一緒に残しておくべきですし。
テキトー教師DotAI 認定講師初めて触る人が一番危ないのは、検索の上の方に出てくる2024年頃の解説をそのまま信じちゃうパターンです。「非商用ライセンスです」で止まってる記事、まだ普通に残ってますから。
室谷代表取締役中身が正しくても、前提が1年ズレてると事業判断を誤る。だから「公式のモデルカードとライセンスページを今日見たか」を確認手順に組み込むのが安全なんですよ。
資料の鮮度チェックって、地味に一番コストがかかる作業ですしね。
資料の鮮度チェックって、地味に一番コストがかかる作業ですしね。
AnimateDiff側のライセンスと並べると整理しやすい
テキトー教師DotAI 認定講師動画生成まわりは、SVDとAnimateDiffで条件が違うので並べると分かりやすいですね。WebUI版のAnimateDiff拡張は作者が非商用ライセンスを採用していて、商用で使うなら作者へ個別に連絡が必要と明記されています。
室谷代表取締役一方でComfyUI版のAnimateDiff-EvolvedはApache-2.0。同じAnimateDiffでも、どの実装を選ぶかで商用の扱いが変わるわけです。
機能差だけで選ぶと、後で効いてくる部分なんですよね。
機能差だけで選ぶと、後で効いてくる部分なんですよね。
テキトー教師DotAI 認定講師モデル本体のライセンスと、拡張機能のライセンスと、使った素材の権利。3つを別々に見ないといけないのが、ここが面倒なところで。
Stable Diffusion全体のライセンスの基礎はStable Diffusionのモデルとは?種類の違いから選び方、商用利用のライセンスまでで整理されてます。
Stable Diffusion全体のライセンスの基礎はStable Diffusionのモデルとは?種類の違いから選び方、商用利用のライセンスまでで整理されてます。
室谷代表取締役納品物がある仕事だと、この3点を先に潰しておかないと後から戻れない。受注前に確認する、それだけなんですけど、これが一番抜けるんですよ。
Runwayなど他の動画生成AIとどう違う?組み合わせて使う現実的な形
SVDはテキストで動きを指示できない、そこが最大の違い
室谷代表取締役SVDは画像を1枚渡すと動いてくれるんですけど、テキストで「こう動いて」と指示する仕組みがないんですよ。Runwayのようにテキストから動画を作るタイプとは、そもそも入り口が違うんですよね。
テキトー教師DotAI 認定講師そこが最初の落とし穴で。プロンプトを一生懸命書いてから「動かない」と戸惑う人が多いんですよ。
公式のモデルカードにも、テキストで動きを制御できないと明記されてます。
公式のモデルカードにも、テキストで動きを制御できないと明記されてます。
室谷代表取締役しかも生成できるのが4秒以下だったり、ほぼ止まってるカットになったり。長尺の絵コンテをこれ1本で回そうとすると、たぶん途中で詰まります。
テキトー教師DotAI 認定講師逆に言えば、止まってる絵を1カットだけ動かす用途では強いんです。全部を任せようとしないのがコツですね。
テキストから作るAIと画像から動かすAIの役割分担
室谷代表取締役実務だと、テキストから場面を作るAIと、描いた絵を動かすAIを分けて考えるほうが回るんですよ。前者で構図のバリエーションを出して、決まったカットだけSVDに渡す。
テキトー教師DotAI 認定講師順番が逆になると全部やり直しになるんですよね。先に動かしてしまうと、構図が固まらないまま揺れるだけの映像が量産されて。
室谷代表取締役制作の分業と同じで、どの工程をどれに持たせるかを決めた時点でコストが決まる。ツール選びというより工程設計の話なんです。
テキトー教師DotAI 認定講師たしかに。1本のモデルで全部やろうとするより、つなぎ目を意識したほうが仕上がりも早いですね。
Stability AIのPlatform APIでサービスに組み込む選択肢
室谷代表取締役サービスに組み込むなら、Stability AIのPlatform APIにimage-to-videoのエンドポイントがあるんですよ。UIを触らずに、アプリから画像を投げて動画を受け取れる。
テキトー教師DotAI 認定講師そこで止まる人が多いのが料金で。クレジットの消費量が変動するので、先に公式のPricingページを見てから設計したほうがいいですよ。
室谷代表取締役ここは経営判断なんですよね。自前でGPUを抱えるか、従量でAPIを叩くか。
月の生成本数が読めるなら後者のほうが身軽ですし、人を採用するより早いです。
月の生成本数が読めるなら後者のほうが身軽ですし、人を採用するより早いです。
ローカルで回すかAPIに投げるか、コストと手間の分かれ目
室谷代表取締役ローカルで回す場合、公式にはA100 80GBで3分ほどという数字が出てます。手元のGPUでどこまで待てるかが分かれ目ですね。
テキトー教師DotAI 認定講師環境構築のところで折れる人が本当に多いので、スペック確認は先にやっておいたほうがいいです。詳しくはStable Diffusionをローカルで動かすには?スペックと環境構築、商用利用の注意点で解説しています。
室谷代表取締役試作はローカル、本番はAPI。この切り分けが現実的かなと。
最初から全部自前で揃えようとすると、動かす前に予算が尽きますから。
最初から全部自前で揃えようとすると、動かす前に予算が尽きますから。
よくある質問
Q1. 動画生成を試すのに、どれくらいのPC環境が必要ですか?
室谷代表取締役ここは環境で体験がまるで別物になる部分なんですよね。解像度とフレーム数を上げるほど要求は跳ね上がるので、まず軽い設定で回して自分のマシンの上限を測るのが早いです。
テキトー教師DotAI 認定講師必要なスペックの数字はソフトの更新でも動くので、配布元の必要環境の記載と、自分の環境で実際に試した結果を突き合わせるのが確実です。ノートだと熱で張り付いて、思ったより速度が出ないこともあります。
室谷代表取締役あと動画は失敗作の連続になるので、試行回数を回せない環境だと学習が進まないんですよ。1本あたりの所要時間で見た方が判断しやすい。
テキトー教師DotAI 認定講師そうですね。まず1本作るまでの時間を測ってから、どこまでやるか決めるのが現実的です。
Q2. 何秒くらいの動画なら現実的に作れますか?
室谷代表取締役尺は欲張ると破綻するので、短いカットを作って繋ぐ前提で考えた方がいいんですよね。長回しを狙うほど難易度は上がります。
テキトー教師DotAI 認定講師最初にがっかりしやすいのがまさにそこです。「1本の長い動画」をいきなり作ろうとして、途中で絵が崩れて諦めるパターンをよく見ます。
室谷代表取締役編集で繋ぐ前提なら、カット単位で作り直せるのでやり直しも効く。工程を分けた方がトータルでは速いんですよ。
テキトー教師DotAI 認定講師映像の現場と同じで、素材を作ってから編集する感覚に近いですね。
Q3. 生成した動画がチラつく、途中で崩れる。どう直せばいいですか?
テキトー教師DotAI 認定講師チラつきは、フレームごとに関係のない絵として生成されているサインのことが多いです。まず動きの量を小さくしてみてください。
室谷代表取締役あと元画像を作り込みすぎるのも裏目に出ますね。細かい模様があるほど、フレームごとに解釈がぶれて揺れる。
テキトー教師DotAI 認定講師プロンプトを短くするのも効きますよ。あれもこれもと足すと、モデルが毎フレーム迷ってしまうんです。
室谷代表取締役足し算じゃなくて引き算の作業なんですよね、結局。
Q4. LoRAなどで特定のキャラや画風を固定して動かせますか?
室谷代表取締役静止画で作った画風をそのまま動かしたい、という要望は制作の現場でも多いんですよ。同じ土台のモデルの上で回すので、組み合わせ自体は可能です。
テキトー教師DotAI 認定講師ただし動きの再現性は別問題で、キャラが固定できても服や背景は揺れます。全部を固定しようとしない方がうまくいきます。
室谷代表取締役商用で使うなら、学習に使った素材の権利まで遡って確認しないといけない。ここは技術というより契約の話です。
テキトー教師DotAI 認定講師そこ、制作側が一番見落とすところですね。
Q5. 手元のPC以外に、クラウドで動かす選択肢はありますか?
室谷代表取締役自分のマシンで回し続けるのが辛いなら、クラウドに寄せる判断は普通にあります。電気代と待ち時間を合わせて考えたら、そっちが安くつくケースもある。
テキトー教師DotAI 認定講師外部サービスは、モデルや設定をどこまで触れるかがサービス次第なので、試す前に確認が必要です。中身をいじれないと、商用利用の条件も変わってきます。
室谷代表取締役重い処理を回している間ずっと課金される体系もあるので、料金の形は見ておきたい。ROI で言えば、待ち時間が売上に直結する人ほどクラウドが有利です。
テキトー教師DotAI 認定講師まず小さく試して、ボトルネックが自分の環境なのかを切り分けるのが先ですね。
まとめ
室谷代表取締役大きく分けて、既存の Stable Diffusion の絵を動かす方向と、動画専用のモデルに任せる方向。この2系統を混ぜて語ると話がこんがらがるので、まず自分がどっちをやりたいかを決めるのが最初の一歩なんですよね。
テキトー教師DotAI 認定講師たしかに。目的が絵コンテの確認なのか、人に見せる本番の映像なのかで選ぶ道具は変わります。
最初から全部を揃えようとすると、だいたい途中で止まります。
最初から全部を揃えようとすると、だいたい途中で止まります。
室谷代表取締役だから短いカットを1本、最後まで通してみる。そこで初めて時間もお金も見えてくる。
作りながら判断するのが現実的です。
作りながら判断するのが現実的です。
テキトー教師DotAI 認定講師商用で使う予定があるなら、作り始める前にライセンスと素材の出どころを確認しておいてください。あとから遡るのは本当に大変なので。
室谷代表取締役手を動かすのが一番早いんですよね。