FLUX.2 kleinはどんなモデル?4Bと9B、Base版と蒸留版の違い
FLUX.2ファミリーの中でkleinはどこに立つのか
 室谷代表取締役
FLUX.2ってmax、pro、flex、dev、kleinって並んでるんですけど、kleinはその中で一番速くて軽い枠なんですよね。テキストからの生成と、参照画像を使った編集が1個のモデルに入ってる。
 テキトー教師DotAI 認定講師
初めて触る人が戸惑うのがまさにそこなんですよ。名前が多くて、どれが入口なのか分からない。
kleinは「まず動かす」側に振ったモデルだと考えると腑に落ちます。
kleinは「まず動かす」側に振ったモデルだと考えると腑に落ちます。
室谷代表取締役BFLは9Bについて「5倍大きいモデルに匹敵する品質を半秒未満で」と書いてる。速度を優先した設計なんだと思います。
ただ、ファミリーが細かく分かれると選ぶ側のコストが地味に上がるんですよね。
ただ、ファミリーが細かく分かれると選ぶ側のコストが地味に上がるんですよね。
テキトー教師DotAI 認定講師たしかに。比較表を眺めて満足して、結局一度も動かしてない、というのが一番もったいないです。
4Bと9Bは何が違う?パラメータとテキストエンコーダーの構成
室谷代表取締役9Bは9Bの拡散モデルに8BのQwen3テキストエンコーダー。4Bは4Bの拡散モデルに4BのQwen3。
数字だけ見ると2倍ちょっとですけど、中身はちゃんと別物なんですよね。
数字だけ見ると2倍ちょっとですけど、中身はちゃんと別物なんですよね。
テキトー教師DotAI 認定講師テキストエンコーダーまで一緒に小さくなってるのがポイントで。プロンプトの読み取り方が変わってくるので、同じ文を入れても出てくる絵は違ってきます。
まとめるとこうです。
まとめるとこうです。
| klein 4B | klein 9B | |
|---|---|---|
| 拡散モデル | 4B | 9B |
| テキストエンコーダー | Qwen3 4B | Qwen3 8B |
| 構成 | 蒸留版とBase版の両方 | 蒸留版とBase版の両方 |
| ライセンス | Apache 2.0 | FLUX Non-Commercial License v2.1 |
室谷代表取締役ライセンスの行、ここが一番デリケートなんですよ。4BはApache 2.0で、9Bは非商用。
詳しい整理は次の章でやりますけど、実務で使うなら最初に見るべき行です。
詳しい整理は次の章でやりますけど、実務で使うなら最初に見るべき行です。
テキトー教師DotAI 認定講師はい。作り込んでからライセンスを見て青くなる、という順番だけは避けたいですね。
Base版と蒸留版、結局どっちを落とせばいい?
室谷代表取締役蒸留版は4ステップで回る方で、9Bだと1秒未満の推論ができると。試行回数を稼ぎたい現場だと、そこが素直に効くんですよ。
テキトー教師DotAI 認定講師現場感覚で言うと、最初に入れるなら蒸留版で間違いないです。Baseは非蒸留で出力の多様性が高く、ファインチューニングや研究向けという位置づけなんですよね。
室谷代表取締役じゃあBaseは個人には関係ない話、で終わらせていいんですか。
テキトー教師DotAI 認定講師そんなことないんですよ。同じプロンプトで違う表情を出したい、みたいな使い方だとBaseの方が向きますし、学習させる前提なら最初からBaseです。
kleinにできないこと——プロンプト自動補完がない前提で書く
室谷代表取締役ここ勘違いされやすいんですけど、kleinにはプロンプトの自動補完が無いんですよね。公式ドキュメントにはっきりそう書いてある。
テキトー教師DotAI 認定講師そこ、ハマる人多いんですよ。ふわっとした指示で出して「思った絵にならない」となって、モデルのせいにしてしまう。
室谷代表取締役実際は書き手の側の解像度の問題で。具体的に書けば、返ってくる速度はちゃんとあるので。
テキトー教師DotAI 認定講師被写体、構図、光、質感まで言葉にする。そこを省くと損をするモデルだと思っておくといいです。
klein 9Bのライセンスは商用利用できる?条文のねじれを整理する
Hugging Face版ライセンスの「Outputs」条文と「非商用目的」の定義
室谷代表取締役まず9Bの配布ページなんですけど、ライセンスが FLUX Non-Commercial License v2.1 になってるんですよ。で、条文を読むと「Outputs は商用目的を含めて利用できる」と書いてある。
これだけ読むと「商用OKじゃん」となるわけですけど・・・
これだけ読むと「商用OKじゃん」となるわけですけど・・・
テキトー教師DotAI 認定講師そこが一番ハマるところで。初めて読む人は「生成物は自由に使える」の一文で読むのを止めちゃうんですよね。
室谷代表取締役同じライセンスの「非商用目的」の定義を追うと、収益を生む活動とか、事業や雇用に関わる利用は明確に除外されてる。モデル自体を商用の文脈で動かす行為は許諾されない、と読める条文が並んでるんです。
テキトー教師DotAI 認定講師生成物はOK、でも使う行為はNG、と書いてあるように見える。このねじれは配布ページのディスカッションでも指摘されてるやつですね。
BFL公式FAQが示す商用利用の条件——Builder以上のプランが必要になるケース
klein 9Bと4Bのライセンス比較
klein 9B
- FLUX Non-Commercial License v2.1
- Outputsは商用利用可の条文がある
- 非商用目的の定義では収益・事業・雇用に関わる利用を除外
- 商用で使うにはCommercial Weights Licenseの購入が必要
- Builder/Platform/Professional/Enterpriseの4プラン
- Builderは月10,000枚まで・1ドメインでの商用利用
klein 4B
- Apache 2.0
- 追加の商用ライセンスなしで仕事に回せる
- クライアントワークにそのまま使える
室谷代表取締役で、実際の答えはBFLのライセンスページのFAQに書いてあるんですよ。「商品として課金する画像を生成する」「クライアント向けの制作物を作る」こういう用途は、別途 Commercial Weights License の購入が必要、と明記されてます。
テキトー教師DotAI 認定講師プランは Builder / Platform / Professional / Enterprise の4つが用意されてる、と。Builder だと月10,000枚まで、1ドメインでの商用利用という条件つきですね。
室谷代表取締役ここは経営目線だと「無料で試して、案件が取れてから契約」でいいのかという話になるんですよ。月に何枚作るか読めない段階で先に契約するのは、正直もったいない。
テキトー教師DotAI 認定講師そうですね。ただクライアントに納品する時点で「無料版で作りました」は説明しづらいので、そこは先に押さえておきたいところです。
4BがApache 2.0で商用利用できる理由と、9Bとの実務上の差
室谷代表取締役一方で4Bは Apache 2.0。ここが実務的にはかなり大きいんですよね。
追加の商用ライセンスなしで、そのまま仕事に回せる。
追加の商用ライセンスなしで、そのまま仕事に回せる。
テキトー教師DotAI 認定講師同じkleinでも、軽い方が自由で重い方が制限つき、というのは最初ちょっと不思議に見えるんですよ。
室谷代表取締役品質を取るか自由度を取るか、という分岐になる。9Bは4ステップの蒸留で、5倍大きいモデルに匹敵する品質を半秒未満で出すとBFLは説明してますけど、その代わりライセンスが締まってる。
テキトー教師DotAI 認定講師現場感覚で言うと「まず9Bで試作して、商用が決まったら4Bに落とすか契約する」という流れが多くなりそうです。
クライアントワークで9Bを使いたいとき、最初に確認すべきこと
室谷代表取締役実務だと、案件を受ける前に「これは商用扱いか」を先に決めるのが大事で。社内の検証なら非商用の範囲で、納品物になった瞬間に別ライセンス、という線を引いておく。
テキトー教師DotAI 認定講師制作の途中で切り替えると、どの画像がどっちの条件で作られたか分からなくなるんですよね。最初に決めておくのが結局ラクです。
室谷代表取締役あとは規約に同意してダウンロードする形式なので、チームで使うなら誰が同意したかも残しておきたい。地味ですけど、あとで効いてきます。
テキトー教師DotAI 認定講師ライセンスの話は目立たないんですけど、一番痛い思いをする場所ですからね。
必要なVRAMと推奨GPUは?資料によって数字が違う理由
4BはどのGPUから動く?コンシューマー向けの現実的なライン
室谷代表取締役4Bのほう、Hugging Faceのモデルカードだと必要VRAMが約13GBで、RTX 3090か4070以上で動くという書き方なんですよね。bfl.aiの比較表はRTX5090で約1.2秒・VRAM8.4GB。
同じモデルでこの差ですから、まずここを飲み込む必要がある・・・
同じモデルでこの差ですから、まずここを飲み込む必要がある・・・
テキトー教師DotAI 認定講師初めて触る人は「13GB」を見て、16GB積んでるから大丈夫と判断しがちなんです。でもその数字はモデル単体の話で、実際の環境では他にも載るものがありますから、余裕を見たほうがいい。
境界線ぎりぎりのGPUは、動いても体験が良くないことが多いんですよ。
境界線ぎりぎりのGPUは、動いても体験が良くないことが多いんですよ。
室谷代表取締役ええ。ここは経営目線が出るところで。
GPUを1枚買い足すのか、クラウドを時間借りするのか、APIに逃がすのか。月に何枚作るかで答えが変わる話なので、スペック表だけ見てポチるのは危ないんですよね。
GPUを1枚買い足すのか、クラウドを時間借りするのか、APIに逃がすのか。月に何枚作るかで答えが変わる話なので、スペック表だけ見てポチるのは危ないんですよね。
テキトー教師DotAI 認定講師たしかに。まず手持ちのGPUで一度回して、待ち時間が許容できるかを見る。
そこが出発点だと思います。
そこが出発点だと思います。
9Bは約29GBか19.6GBか——出典ごとの差をどう読むか
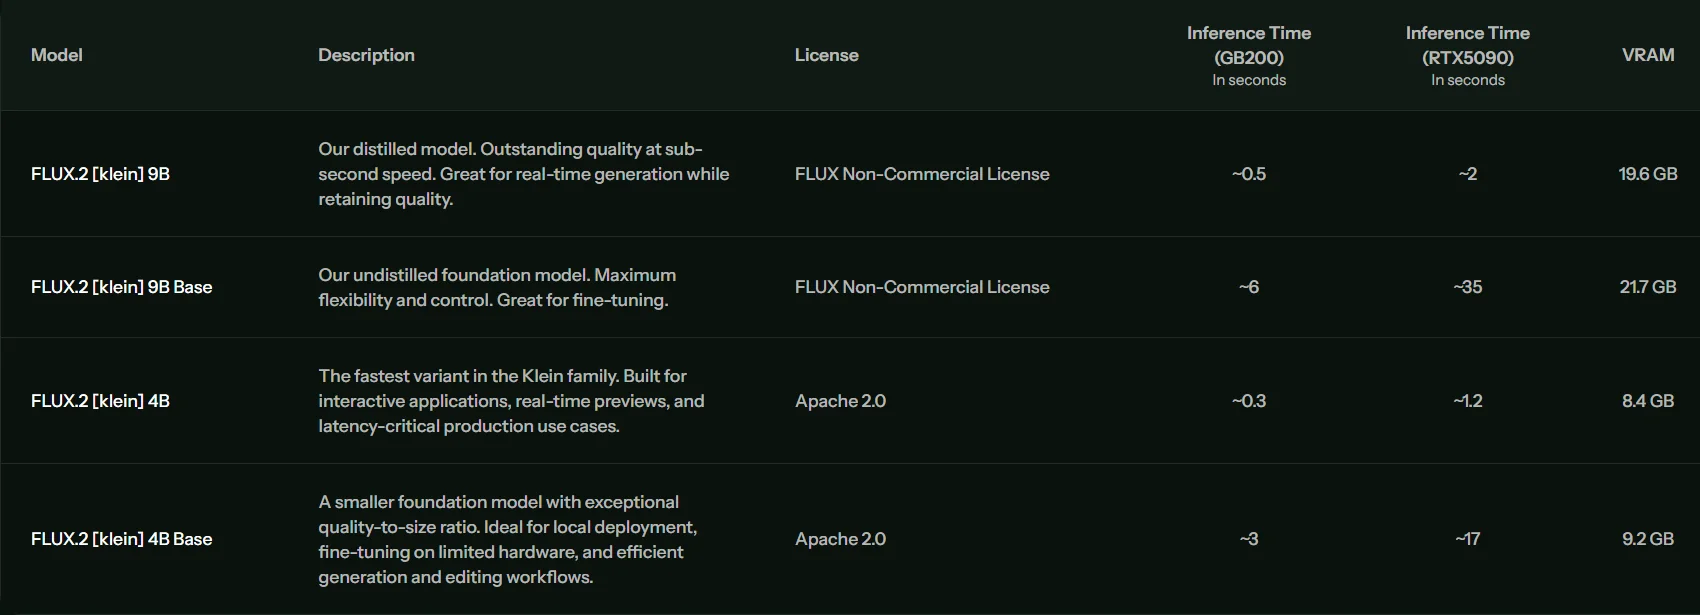
室谷代表取締役9Bはもっと極端で。Hugging Faceのモデルカードは約29GBでRTX 4090以上、bfl.aiの比較表はRTX5090で約2秒・VRAM19.6GB。
19.6と29では、手持ちのGPUで動くかどうかが反転する人が出てくる数字なんですよ。
19.6と29では、手持ちのGPUで動くかどうかが反転する人が出てくる数字なんですよ。
テキトー教師DotAI 認定講師ここで現場からよく聞くのが「どっちを信じればいいんですか」なんです。私の感覚だと、比較表は同じ土俵で並べたときの数字、モデルカードは安全側に寄せた数字、という読み分けをします。
室谷代表取締役なら最初の見積もりは重いほう、つまり29GB側で置く。動かしてみて余裕があったら軽いほうを信じる。
逆にすると、買ってから動かないという一番高い失敗になるんですよね。
逆にすると、買ってから動かないという一番高い失敗になるんですよね。
テキトー教師DotAI 認定講師あとこの差は、量子化や実行環境の違いで説明されうるとされているので、自分の環境で同じ数字が出なくても故障ではないんです。正確な要件は公式サイトで確認するのが安全ですね。
量子化とfp8で数字はどこまで下がる?
室谷代表取締役で、実際に下げにいく手段が量子化です。ComfyUI向けに配布されているファイル名を見ると fp8 のものが並んでいる。
あれを使うと必要VRAMは小さい方向に動く。
あれを使うと必要VRAMは小さい方向に動く。
テキトー教師DotAI 認定講師ただ、どこまで下がるかは環境次第で、公式に「この数値」と一本で書かれているわけではないんです。最初に戸惑うのがまさにここで、第三者が書いた数字をそのまま自分のGPUに当てはめてしまう。
室谷代表取締役あとDiffusersで回すなら enable_model_cpu_offload() を入れておくとVRAM消費を抑えられます。速度は落ちますけど、まず動かすのが優先ならこれでいい。
テキトー教師DotAI 認定講師そうそう。速さを取るか、動く下限を取るか。
fp8とオフロードはその調整弁なんですよね。
fp8とオフロードはその調整弁なんですよね。
手持ちのGPUで足りるかを判断する順番
手持ちのGPUで足りるかを判断する順番
- 01使うモデルを決める4Bか9Bか、蒸留版かBase版か
- 02両方のVRAM表記を見るHugging Faceのモデルカードとbfl.aiの比較表
- 03重いほうの数字で足りるか確認重いほうの数字を前提に自分のGPUで足りるかを置いてみる
- 04足りなければfp8、それでも厳しければCPUオフロードかAPIへfp8のファイル、それでも厳しければCPUオフロードかAPIに切り替える
- 使うモデルを決める(4Bか9Bか、蒸留版かBase版か)
- Hugging Faceのモデルカードとbfl.aiの比較表、両方のVRAM表記を見る
- 重いほうの数字を前提に、自分のGPUで足りるかを置いてみる
- 足りなければfp8のファイル、それでも厳しければCPUオフロードかAPIに切り替える
室谷代表取締役この順番で見ると、迷う時間がかなり減るんですよね。数字が1つに決まらないものを、決まっている前提で計画を立てるのが一番もったいない。
テキトー教師DotAI 認定講師数字が2つあると不安になりますけど、順番さえ決めておけば怖くないです。まず動かして、そのあと速度を詰める。
それでいいと思います。
それでいいと思います。
ComfyUIでFLUX.2 kleinを動かす準備——モデルファイルの置き場所
4Bは3つのフォルダに分けて置く
ComfyUI/models/text_encoders/にqwen_3_4b.safetensorsを置くComfyUI/models/diffusion_models/にflux-2-klein-4b-fp8.safetensors(蒸留)とflux-2-klein-base-4b-fp8.safetensors(Base)を置くComfyUI/models/vae/にflux2-vae.safetensorsを置く
室谷代表取締役置き場所、ここで最初に詰まる人が多いんですよね。モデルは1か所にまとめたくなるんですけど、テキストエンコーダーと拡散モデルとVAEでフォルダが分かれてるので、そこは分けたままにするしかないんですよ。
テキトー教師DotAI 認定講師現場でよく聞くのが「diffusion_modelsに入れたのに読み込まれない」なんですけど、だいたいテキストエンコーダーが text_encoders に入っていないパターンですね。
室谷代表取締役あと4Bは蒸留とBaseの2種類が同じフォルダに並ぶので、ファイル名で見分けることになるんですよね。どっちを選ぶかで挙動が変わるんで、置くときに意識しておいてほしいところです。
テキトー教師DotAI 認定講師ファイル名の前半がほぼ同じなので、慣れるまではエクスプローラーで1つずつ確認しながら進めるのが安全ですね。
9Bはテキストエンコーダーが別ファイルになる
FLUX.2 klein モデルファイルの配置手順
- 014B: text_encodersComfyUI/models/text_encoders/ に qwen_3_4b.safetensors を置く
- 024B: diffusion_modelsComfyUI/models/diffusion_models/ に flux-2-klein-4b-fp8.safetensors(蒸留)と flux-2-klein-base-4b-fp8.safetensors(Base)を置く
- 034B: vaeComfyUI/models/vae/ に flux2-vae.safetensors を置く
- 049B: text_encodersComfyUI/models/text_encoders/ に qwen_3_8b_fp8mixed.safetensors を置く(4Bとは別ファイル)
- 059B: diffusion_modelsComfyUI/models/diffusion_models/ に flux-2-klein-9b-fp8.safetensors(蒸留)と flux-2-klein-base-9b-fp8.safetensors(Base)を置く
- 069B: vaeComfyUI/models/vae/ に flux2-vae.safetensors を置く
- 079B: 規約同意9Bの拡散モデルはBFLのHugging Faceリポジトリで利用規約に同意してからダウンロードする
- 08ワークフローJSON読み込み公式テンプレートの4B・9BそれぞれのJSONを読み込む(テキストから画像へ/画像編集/画像編集Distilled)
ComfyUI/models/text_encoders/にqwen_3_8b_fp8mixed.safetensorsを置くComfyUI/models/diffusion_models/にflux-2-klein-9b-fp8.safetensors(蒸留)とflux-2-klein-base-9b-fp8.safetensors(Base)を置くComfyUI/models/vae/にflux2-vae.safetensorsを置く- 9Bの拡散モデルは、BFLのHugging Faceリポジトリで利用規約に同意してからダウンロードする
テキトー教師DotAI 認定講師9Bはテキストエンコーダーが4Bと別ファイルになるんですよ。4Bの感覚で同じものを置いてしまうと読み込まれないので、ここは最初に確認しておきたいですね。
室谷代表取締役このへん、権利の話と地続きなんですよね。9Bの拡散モデルは規約に同意しないと落とせない仕様になっていて、ダウンロードの手前で一度止まるんですよ。
テキトー教師DotAI 認定講師たしかに。同意の画面が出てきたタイミングで、はじめて商用かどうかを意識する人も多いと思います。
室谷代表取締役チームで同じ環境を組むなら、この同意の手順まで含めて手順書にしておくのが効くんですよね。あとから権利の確認で戻る時間って、地味に高くつくので。
公式テンプレートのワークフローJSONを読み込む
室谷代表取締役ファイルが揃ったら、次はワークフローを読み込む番なんですが、公式テンプレートに4B・9BそれぞれのJSONが用意されてるんですよ。
テキトー教師DotAI 認定講師「テキストから画像へ」「画像編集」「画像編集Distilled」の3種類があるので、やりたいことに合わせて選ぶ形ですね。
室谷代表取締役画像編集のほうは、LoadImageノードに画像をアップロードして使う流れなんですけど、最初はノードの数に面食らうはずで。
テキトー教師DotAI 認定講師初めて触る人は、まずテキストから画像へのテンプレートを一度そのまま回してみるのが早いですね。編集のほうは後からでも十分間に合います。
テンプレート一覧に出てこないときの確認順
テキトー教師DotAI 認定講師テンプレートの一覧に該当の項目が見当たらない、というのもよく聞きます。ComfyUIが古いと出てこないことがあるので、最新版やNightlyに更新すると出てくることがあります。
室谷代表取締役ここは環境依存なので、上げる前に今動いている状態をメモしておくのがおすすめですね。戻せるかどうかで、詰まったときの損失がまるで変わります。
テキトー教師DotAI 認定講師たしかに。更新したらまずテンプレートが出るかを確認して、出なければ公式ドキュメントの手順に戻って見直す、という順番が安全ですね。
テキストから画像を生成する手順と、Diffusersで回す方法
ComfyUIの「テキストから画像へ」で1枚出すまで
- ComfyUIを最新版に更新する(テンプレートが出てこない場合、公式ガイドではNightlyも試すよう案内されている)
- テンプレート一覧から「テキストから画像へ」を選ぶ。4B用と9B用がそれぞれ用意されている
- 前の章で置いたモデルファイルが読み込まれているか確認する
- プロンプトを入れて、ステップ数・解像度・guidance_scaleを決めて実行する
テキトー教師DotAI 認定講師最初に戸惑うのが、テンプレートを開いてもどこを触ればいいか分からない、という点なんですよ。モデルさえ合っていれば、あとはプロンプトと数字3つで回ります。
室谷代表取締役数字3つ、という言い方がちょうどいいですね。逆に言うと、そこを詰めないと出力が安定しない。
この3つは次の小見出しで詳しく見ますか。
この3つは次の小見出しで詳しく見ますか。
テキトー教師DotAI 認定講師そうしましょう。あと画像編集のテンプレートは別に用意されているので、まずは生成のほうで動作確認した方が混乱しません。
プロンプトは具体的に書き切る——自動補完がない前提の組み立て
室谷代表取締役kleinって、プロンプトを勝手に補ってくれる機能がないんですよね。書いた分しか出てこない。
これは楽でもあり、厳しくもあります。
これは楽でもあり、厳しくもあります。
テキトー教師DotAI 認定講師現場でよく聞くのは「短いプロンプトだと雰囲気が出ない」という声です。被写体、構図、光の当たり方、質感。
このあたりを言葉にするだけで別物になります。
このあたりを言葉にするだけで別物になります。
室谷代表取締役手間をかけた分だけ制御できる、と。長文を書くコストを面倒と見るか、ディテール指定のUIと見るかで評価が分かれそうですね。
テキトー教師DotAI 認定講師たしかに。モデル側が指示を足してくれないので「いい感じに」みたいな委任は効きません。
そこだけ飲み込めば早いんですけどね。
そこだけ飲み込めば早いんですけどね。
ステップ数・解像度・guidance_scaleの初期値
テキトー教師DotAI 認定講師蒸留版は4ステップ前提で作られているので、まずはその近辺から始めるのが素直です。Base版は非蒸留で性質が違うので、同じ数字のまま横並びで比べない方がいいですね。
室谷代表取締役解像度とguidance_scaleは、公式のモデルカードやテンプレートに入っている例をそのまま初期値にする。これが一番安全なんですよね。
手元のGPUで変わるので、正解を1つに決められない。
手元のGPUで変わるので、正解を1つに決められない。
テキトー教師DotAI 認定講師そこは間違いないですね。最初から追い込まず、同じプロンプトで数字だけ動かして差分を見る。
これが結果的に一番早いです。
これが結果的に一番早いです。
Pythonから動かすならDiffusers、VRAMが足りないときはCPUオフロード
室谷代表取締役バッチで回したいならPythonからですね。DiffusersをGitから入れて、パイプラインを読み込むだけです。
bash
pip install git+https://github.com/huggingface/diffusers.gitpython
from diffusers import Flux2KleinPipeline

pipe = Flux2KleinPipeline.from_pretrained("black-forest-labs/FLUX.2-klein-4B")
pipe.enable_model_cpu_offload()

image = pipe(
    prompt=prompt,
    height=height,
    width=width,
    guidance_scale=guidance_scale,
    num_inference_steps=num_inference_steps,
).images[0]効くのは enable_model_cpu_offload() の1行で、これを挟むだけでVRAMの消費がかなり変わります。9BはHugging Faceで規約に同意してからダウンロードする必要があるので、そこだけ先に済ませておいてください。
室谷代表取締役ローカルで回し切れると、試行回数のコストがほぼゼロになる。プロンプトを書く手間は増えるけど、その分だけ思い通りに寄せられる。
相性のいい使い方なんだと思います。
相性のいい使い方なんだと思います。
複数の参照画像で編集する手順と、生成・編集にかかる時間の目安
LoadImageに参照画像を入れて編集ワークフローを回す
ComfyUI公式テンプレートを使う場合、手順はこの4つです。
- ComfyUIを最新版(Nightlyを含む場合あり)に更新する
- 公式テンプレートから4Bまたは9Bの「画像編集」ワークフローJSONを読み込む(蒸留版で回すなら「画像編集Distilled」)
- 「LoadImage」ノードに編集したい画像をアップロードする
- プロンプトに変更内容を書いて実行する
室谷代表取締役手順自体はシンプルなんですよね。テンプレートを開いて、LoadImageに画像を入れて、プロンプト書いて回す。
これだけなんですよ。
これだけなんですよ。
テキトー教師DotAI 認定講師そうなんですよ。ただ最初に戸惑うのが、テンプレートが4Bと9Bで別々に用意されている点で。
「どっちのJSONを開けばいいんですか」と聞かれることが多いです。
「どっちのJSONを開けばいいんですか」と聞かれることが多いです。
室谷代表取締役そこは手元のGPUとライセンスで決まりますからね。編集は試行回数が増える作業なので、まず軽い方で回して当たりをつける。
その進め方が現実的かなと。
その進め方が現実的かなと。
テキトー教師DotAI 認定講師生成側のワークフローを先に触っていれば、編集はLoadImageが増えるだけなので、実は敷居は低いんですよ。
kleinが参照できるのは最大4枚——max/pro/flex/devとの差
| モデル | 参照できる画像の枚数 |
|---|---|
| klein | 最大4枚 |
| max / pro / flex | APIで最大8枚、プレイグラウンドで最大10枚 |
| dev | 推奨最大6枚 |
室谷代表取締役ここ、設計思想の差が出てるんですよね。kleinは枚数を絞って速度を取ったモデルなんですよ。
テキトー教師DotAI 認定講師たしかに。4枚で足りる案件と足りない案件は現場でも混ざるので、先に把握しておいた方がいいところです。
室谷代表取締役参照をもっと増やしたいなら、素直に別モデルへ切り替える。1本のワークフローで全部まかなおうとすると、たぶん破綻します。
テキトー教師DotAI 認定講師モデルを変えるとワークフロー側のノード構成も見直しになるので、テンプレートは4B用と9B用で別々に保存しておくのが安全ですね。
公式が示す速度の目安をどう受け取るか
室谷代表取締役速度の数字、資料によって幅があるんですよね。9Bの蒸留でRTX5090なら2秒前後、Baseだと35秒前後という比較表が公式に出てます。
テキトー教師DotAI 認定講師同じ9Bでもそこまで開くのは、実際はステップ数(蒸留のステップ設計)の違いなので。数字だけ見て「9Bは遅い」と覚えるとズレます。
室谷代表取締役VRAMの数字もモデルカードと比較表で違いますし、手元の環境で一度測るのが早いんですよ。制作の見積もりは実測ベースで組みたいところで。
テキトー教師DotAI 認定講師現場感覚で言うと、編集は1枚出して終わりではなく何案か出して選ぶので、1回あたりの秒数より連続で回したときの体感の方が効いてきます。
編集で崩れやすいケースと指示の出し方
室谷代表取締役kleinはプロンプトの自動補完がないので、指示は具体的に書く必要があるんですよね。ここは生成側と同じ前提です。
テキトー教師DotAI 認定講師初めて触る人は「いい感じに」で出そうとして、全然変わらないってなりがちです。何を残して何を変えるかを分けて書くといいんですよ。
室谷代表取締役参照4枚の上限があるので、枚数を足して解決しようとせず、指示の側でカバーする発想が要りますね。
テキトー教師DotAI 認定講師あと一度に複数の変更を盛り込むと、どこが効いたのか分からなくなるので、変更は1つずつ試すのが結局は早いです。
APIで使う場合の料金と、ローカル実行との使い分け
4Bと9Bのメガピクセル単価を並べてみる
室谷代表取締役APIで回すときの単価、先に数字を置いておきますね。100万画素あたりで見るとこうなります。
| モデル | 最初の1メガピクセル | 追加1メガピクセルごと |
|---|---|---|
| klein 4B | $0.014 | $0.001 |
| klein 9B | $0.015 | $0.002 |
テキトー教師DotAI 認定講師並べると、最初の1枚はほぼ同じで、差が出るのは追加のほうなんですね。
室谷代表取締役そうなんですよ。追加が0.001か0.002かって、1枚単位だと誤差に見えるんですけど、バッチで何千枚も回すと効いてくる。
出力サイズを大きくするほど差が開きます。
出力サイズを大きくするほど差が開きます。
max/pro/flex/devとの参照枚数・速度の比較
テキトー教師DotAI 認定講師参照画像の枚数、kleinは最大4枚までなんですね。max/pro/flexはAPIで8枚、プレイグラウンドなら10枚、devは推奨6枚。
ここに設計思想が出てる気がします。
ここに設計思想が出てる気がします。
室谷代表取締役kleinは枚数より速度に振ってるんですよね。4ステップに蒸留されていて1秒未満で返ってくる。
参照を10枚並べる編集は、そもそもkleinの守備範囲じゃないんですよ。
参照を10枚並べる編集は、そもそもkleinの守備範囲じゃないんですよ。
テキトー教師DotAI 認定講師現場でよく聞くのは、参照が多い案件ほど「まずkleinで試して、足りないと気づく」パターンです。参照の多さが要件なら、最初から別モデルを見たほうが早いんですけどね。
APIとローカル、コストが逆転するのはどのあたりか
室谷代表取締役逆転点は、ざっくり「回数」と「GPUをすでに持っているか」の2変数なんですよ。4BはApache 2.0でローカルに置けるので、固定費を払い済みなら比較の土俵が変わります。
テキトー教師DotAI 認定講師たしかに。初めて触る人は「ローカルのほうが安い」で止まりがちなんですけど、セットアップやモデル更新の手間は誰かが払ってるコストで。
室谷代表取締役そこは時給で換算すると見えやすくて。構築に半日かかるなら、その半日ぶんのAPI課金と並べる。
数十枚の試作ならAPIが勝ち、毎日回す量産ならローカルが効いてきます。
数十枚の試作ならAPIが勝ち、毎日回す量産ならローカルが効いてきます。
テキトー教師DotAI 認定講師逆転点は環境で変わるので、公式の最新単価と自分のGPUで一度計算してみるのが結局は早いですね。
本番運用でAPIを選ぶべきケース、ローカルを選ぶべきケース
室谷代表取締役本番でAPIを選ぶのは、枚数が読めないときと、参照が4枚を超えるとき。あと9Bを試したいけど商用ライセンスの整理が要る案件は、従量課金のほうが社内で稟議を通しやすいんですよね。
テキトー教師DotAI 認定講師ローカルが向くのは、4Bで十分な画質が出ていて、毎日決まった量を回す場合。社外に画像を出せない案件は、そもそも選択肢がローカルだけになります。
室谷代表取締役経営目線で言うと、「安いほうを選ぶ」じゃなくて「どの工程を自社で持つか」の話なんですよ。推論を内製するのか、従量で買うのかで、人の配置も変わりますから。
テキトー教師DotAI 認定講師そう考えると、試作はAPI・量産はローカル、みたいな二分法では収まらない感じがしますね。
結局どれを選べばいい?個人・開発・商用の分岐
用途別モデル選択フロー
手元のPCで試すだけ?(個人利用)
YES / はい
- klein 4B 蒸留版を選ぶ
- 必要VRAM約13GB/RTX 3090・4070以上が目安
- まず動かして感触を確認
NO / いいえ
- 商用案件に回す?
- はい→ライセンスを先に確認(9B系は非商用、商用はCommercial Weights LicenseやBuilderプラン、4B系はApache 2.0)
- いいえ→ファインチューニング・研究ならBase版(出力の多様性が高い)
個人が手元で試すなら4Bの蒸留版
室谷代表取締役まず分岐を先に決めるのが近道なんですよ。手元のPCで試したいだけなら、klein 4Bの蒸留版。
これが一番現実的な入口なんですよね。
これが一番現実的な入口なんですよね。
テキトー教師DotAI 認定講師たしかに。初めて触る人は9Bから入ろうとしてVRAMで止まります。
4Bは必要VRAMがおよそ13GBという案内で、コンシューマー向けGPUとしてはRTX 3090/4070以上が目安とされています。
4Bは必要VRAMがおよそ13GBという案内で、コンシューマー向けGPUとしてはRTX 3090/4070以上が目安とされています。
室谷代表取締役bfl.ai の比較表だとRTX5090で8.4GB、約1.2秒という数字も出てる。資料によって幅があるので、そこは公式で確認する前提ですけど、4Bが入口なのは揺るがないんですよ。
テキトー教師DotAI 認定講師4Bの中でもBaseと蒸留の2種類が配布されているので、最初に戸惑うのがそこです。まず動かして感触を見たいなら蒸留版、あとでいじる前提ならBase、と切り分けておくと迷いません。
商用案件に回すならライセンスを先に決める
室谷代表取締役ここが一番トラブるポイントなんですよ。9B系は非商用ライセンスで、生成物は自由に使えるという条文がある一方、非商用の定義では収益を生む活動が除外されている。
条文がねじれてるんですよね。
条文がねじれてるんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのは「生成物はOKって書いてあったのに」で止まるケースです。BFLのライセンスFAQだと、商品で課金する画像を生成する、クライアント向けの制作物を作る、といった用途には別途Commercial Weights Licenseが必要と明記されています。
室谷代表取締役経営目線で言うと、案件を受けてからライセンスを調べるのが一番高くつく。Builderプランなら月10,000枚まで・1ドメインでの商用利用といった条件が案内されているので、単価と枚数を先に置いて判断する話なんですよ。
テキトー教師DotAI 認定講師逆に4B系はApache 2.0なので、そこは悩まなくていい。速さと軽さを取って4Bで商用、品質を優先するなら9Bでライセンス契約、という分かれ方になりますね。
ファインチューニングや研究ならBase版
室谷代表取締役蒸留版は4ステップで速い代わりに、出力の幅は狭くなる。学習や検証で使うならBase版なんですよね。
テキトー教師DotAI 認定講師実はそうなんですよ。Base版は出力の多様性が高く、ファインチューニングや研究向けと位置づけられています。
比較表では9B BaseがRTX5090で約35秒・VRAM21.7GB、4B Baseが約17秒・VRAM9.2GBという数字が出ています。
比較表では9B BaseがRTX5090で約35秒・VRAM21.7GB、4B Baseが約17秒・VRAM9.2GBという数字が出ています。
室谷代表取締役秒数の差、単発だと気にならないんですけど、量を回すと効いてくる。試行回数がそのまま研究の速度になるので、そこは投資対効果の話ですね。
テキトー教師DotAI 認定講師あとBaseは蒸留と違ってステップ数を自分で決めるので、最初はテンプレートの推奨値をそのまま使って、慣れてから詰めていく順番が安全です。
導入前に確認しておきたい公式情報の見方
室谷代表取締役最後に、数字の出どころを揃えておきたいんですよ。VRAMと秒数はHugging Faceのモデルカード、bfl.aiの比較表、ComfyUIのガイドで値が違う。
どれか1つを正と決めると事故ります。
どれか1つを正と決めると事故ります。
テキトー教師DotAI 認定講師初めて触る人は、ネットで見かけた数字をそのまま信じがちです。9Bは約29GBという案内と19.6GBという表の値で開きがあるので、自分の環境で一度動かして確かめるのが早いんですよね。
室谷代表取締役それとこのモデル、プロンプトの自動補完がないので、具体的に書く前提で設計したほうがいい。ここを踏まえずに「思った絵が出ない」となるのが一番もったいない。
テキトー教師DotAI 認定講師新しい世代のモデルも続々出ているので、選定は一度で終わらせず見直す前提がよさそうです。詳しくはFLUX 3 Image Kleinとは?NVIDIAのGB200で学習、8GB VRAMのRTXで動く画像生成モデルで解説しています。
手を動かす前に、用途とライセンスの分岐だけ先に確定させておくのが一番の近道ですね。
手を動かす前に、用途とライセンスの分岐だけ先に確定させておくのが一番の近道ですね。
よくある質問
Q1. klein以外のFLUX系モデルとはどう使い分ける?
室谷代表取締役配布元のモデル一覧を眺めると、パラメータ数と必要環境が並んでるんですよね。FLUX.2 klein 9Bをいきなり落とす前に、自分のマシンで現実的に回るサイズを先に決めたほうが早いです。
テキトー教師DotAI 認定講師現場でよく聞くのは「とりあえず一番大きいのを落としてきました」なんですよ。で、動かなくて止まる。
順番が逆なんですよね。
順番が逆なんですよね。
室谷代表取締役小さいので下書き、大きいので本番、みたいに役割を分けると判断がラクです。全部を1つで済ませようとすると、だいたい中途半端になるんですよ。
Q2. 日本語のプロンプトでも指示は通る?
テキトー教師DotAI 認定講師初めて触る人がまず試すのがこれですね。通じるかどうかは正直ムラがあって、構図まで細かく指定したいときは英語に寄せたほうが安定しやすい、というのが現場の感触です。
室谷代表取締役翻訳を挟むの、地味に効きますよ。日本語で考えてから英語に落とすと、自分でも指示の抜けに気づけるんですよね。
テキトー教師DotAI 認定講師あと長い文章をだらだら書くより、被写体・構図・光・質感を単語で並べたほうが伝わる。これ、文章力じゃなくて整理の話なんですよ。
Q3. 生成が崩れるとき、どこから疑えばいい?
室谷代表取締役切り分けの順番があるんですよね。まずプロンプト、次にステップ数やガイダンス、最後に解像度。
上から順に潰すとだいたい当たります。
上から順に潰すとだいたい当たります。
テキトー教師DotAI 認定講師最初に戸惑うのが、条件を一度に3つ4つ変えてしまうことなんですよ。それだと何が効いたのか分からなくなる。
1個ずつ動かすのが結局一番速いです。
1個ずつ動かすのが結局一番速いです。
室谷代表取締役あと、公開されてるワークフローをそのまま使って再現できてから、少しずつ崩していくのも手ですね。
Q4. LoRAなどで追加学習はできる?
テキトー教師DotAI 認定講師ここは配布元のモデルカードに何が書いてあるかで結論が変わる領域なんですよ。学習を許す範囲と、配布物の扱い。
両方に目を通す必要があります。
両方に目を通す必要があります。
室谷代表取締役商用で使う前提なら、なおさら先に確認ですね。あとから「この用途は想定外でした」で作り直しになると、その分の工数がまるごと消えるので。
テキトー教師DotAI 認定講師たしかに。動かす前に一度立ち止まるの、地味に大事なんですよ。
Q5. 更新や仕様変更はどう追えばいい?
室谷代表取締役配布ページを見に行く習慣をつけるのが結局一番ですね。数字もライセンスも、そこでしか正確なことは分からない。
テキトー教師DotAI 認定講師現場感覚で言うと、まとめ記事だけで判断しちゃう人が多いんですよ。書かれた時点の情報なので、その後の変更を拾えてないことがある。
室谷代表取締役昨日まで動いてたのに、というのは配布物が変わった可能性を疑うといいです。まずここを見る、と決めておくと迷わないですよ。
まとめ
室谷代表取締役klein、結論としては「小さく試して、効いたら広げる」が一番外さない使い方なんですよね。4Bと9Bのどっちを選ぶかで悩むより、まず1枚出して自分の目で差を見たほうが早いです。
テキトー教師DotAI 認定講師たしかに。最初から本番フローに組み込もうとして止まるより、手元で1週間触ったほうが判断材料が揃いますからね。
室谷代表取締役MYUUUでも、新しいモデルはまず小さい案件で回して、時給換算でペイするか見てから本番に入れてます。順番を逆にすると、けっこう痛い目に遭うんですよ。
テキトー教師DotAI 認定講師ライセンスと必要環境だけは動かす前に確認を。そこは後から取り返しがつかないので。
最初の1枚が出たら、参照画像での編集まで試すと使いどころが一気に見えてきますよ。
最初の1枚が出たら、参照画像での編集まで試すと使いどころが一気に見えてきますよ。