Qwen-Image-Edit-2511とは?公開された時期とファミリーの系譜
Qwen-Image-Edit-2511はいつ、誰が公開したどんなモデル?
 室谷代表取締役
まず最初に押さえておきたいのが、このモデルが何者かというところで。AlibabaのQwenチームが2025年12月23日に公開した、20Bパラメータの画像編集に振り切ったモデルなんですよね。
 テキトー教師DotAI 認定講師
たしかに。名前だけ見ると「2509の次の版ね」で済むんですが、初めて触る人はまず数字の羅列の前で止まります。
ここで一度立ち止まれるかどうかが、後の事故を防ぐ分かれ目なんですよ。
ここで一度立ち止まれるかどうかが、後の事故を防ぐ分かれ目なんですよ。
室谷代表取締役モデルの識別子が数字の並びになってるので、確認せずに進むと別のものを落としてる事故が起きる・・・地味ですけど、そこが一番もったいないんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのも「ダウンロードしたファイルが違ってた」パターンです。中身の前に、まず名前の地図を持つ。
これが最初の一歩ですね。
これが最初の一歩ですね。
Qwen-Image/Edit/2509/2511/2512は何が違う?系譜を年表で整理
室谷代表取締役名前が似たものが多いので、並べた方が早いですね。公式の発表ベースで整理するとこうなります。
| 公開日 | モデル | 位置づけ |
|---|---|---|
| 2025年8月4日 | Qwen-Image | 20BパラメータのMMDiT基盤モデル。文字描画と画像編集に強い |
| 2025年8月18日 | Qwen-Image-Edit | 画像編集に特化した初版 |
| 2025年9月22日 | Qwen-Image-Edit-2509 | 複数画像入力と一貫性を強化した版 |
| 2025年12月23日 | Qwen-Image-Edit-2511 | 本記事の対象。編集系の最新版 |
| 2025年12月31日 | Qwen-Image-2512 | テキストから画像を生成する寄りの別モデル |
テキトー教師DotAI 認定講師ここが一番ハマる人多いんですよ。2512の方が数字が大きくて新しく見えるので、そっちを編集用だと勘違いしてしまう。
でも2512は生成寄りの別物で、編集の系譜は2511で止まってるんです。
でも2512は生成寄りの別物で、編集の系譜は2511で止まってるんです。
室谷代表取締役バージョン番号じゃなくてリリース年月を名前にする流儀、追う側からすると素直につらいんですよね。業界的にもう少し区別しやすい名前になってほしいところですが、公式のREADMEの日付表記を見るのが一番確実です。
テキトー教師DotAI 認定講師逆に言うと、日付で並べれば迷わない。8月に基盤、8月に編集の初版、9月に2509、12月に2511。
この順番だけ頭に入れておけば十分です。
この順番だけ頭に入れておけば十分です。
20Bパラメータのモデルが得意とする編集とは
室谷代表取締役で、この20Bというサイズが何を意味するかというと。公式のショーケースを見る限り、人物の同一性を保ったままスタイルやポーズを変える、別々に撮った2枚の人物写真を1枚の集合写真に合成する、といった「同じ人・同じ製品を崩さない」系の編集が主戦場なんですよね。
テキトー教師DotAI 認定講師あとは工業デザイン寄りも面白くて。同じ製品を違う仕様や質感のバリエーションとして量産したり、製図や注釈用の補助線をそのまま出したり。
写真の加工というより、デザインの下書きに近い使い方ができるのが特徴ですね。
写真の加工というより、デザインの下書きに近い使い方ができるのが特徴ですね。
室谷代表取締役ただ、20BをBF16で自前で持つとなると、それなりのGPUが要る。これ、時給換算みたいな話じゃなくて設備投資の判断になるんですよ。
クラウドに置くか手元に置くかで、使い方の設計が変わってきます。
クラウドに置くか手元に置くかで、使い方の設計が変わってきます。
テキトー教師DotAI 認定講師そこは次の章以降で詳しく見ていく話ですね。まずは「編集特化の20Bで、人物と製品の一貫性が得意」という看板だけ持って帰ってもらえれば、今日のところは十分です。
2509から何が変わった?2511で強化されたポイント
2509の土台に何を積んだのか
室谷代表取締役2509が「複数画像を入力できる」という土台を作ったバージョンだとしたら、2511はその上に乗せた改善が中心なんですよね。派手な新機能というより、前から言われていた弱点を潰しにきた感じで。
テキトー教師DotAI 認定講師現場感覚で言うと、まさにそこが評価されてるんですよ。派手さはないけど、実際に手を動かす人ほど「そこ直してくれたか」ってなる部分です。
室谷代表取締役構造的に見ると、基盤モデル→編集特化→複数画像対応→今回の安定性と一貫性、という流れで、開発のフェーズが「できるか」から「実務で使えるか」に移ったんですよね。
テキトー教師DotAI 認定講師たしかに。触った人の反応も、機能の多さより「連続で編集しても最後まで持つ」みたいな話に寄ってます。
編集を繰り返すうちに崩れる「image drift」が軽減
室谷代表取締役これ、地味に一番効くやつなんですよ。1回編集して終わりならいいけど、実務だと何度も回すじゃないですか。
テキトー教師DotAI 認定講師最初に戸惑うのがそこなんですよね。1回目はきれいなのに、3回4回と重ねるうちに画質も構図もじわじわ崩れていく。
2511はこの編集を繰り返すうちに崩れる現象が軽減されている、という整理です。
2511はこの編集を繰り返すうちに崩れる現象が軽減されている、という整理です。
室谷代表取締役MYUUUの現場で言えば、素材を作り直す手間が減るのと同じで、往復の回数が減ると工数に直で効くんですよ。クリエイティブの試行回数って、そのままコストなので。
人物の同一性と、複数人の集合写真合成の精度
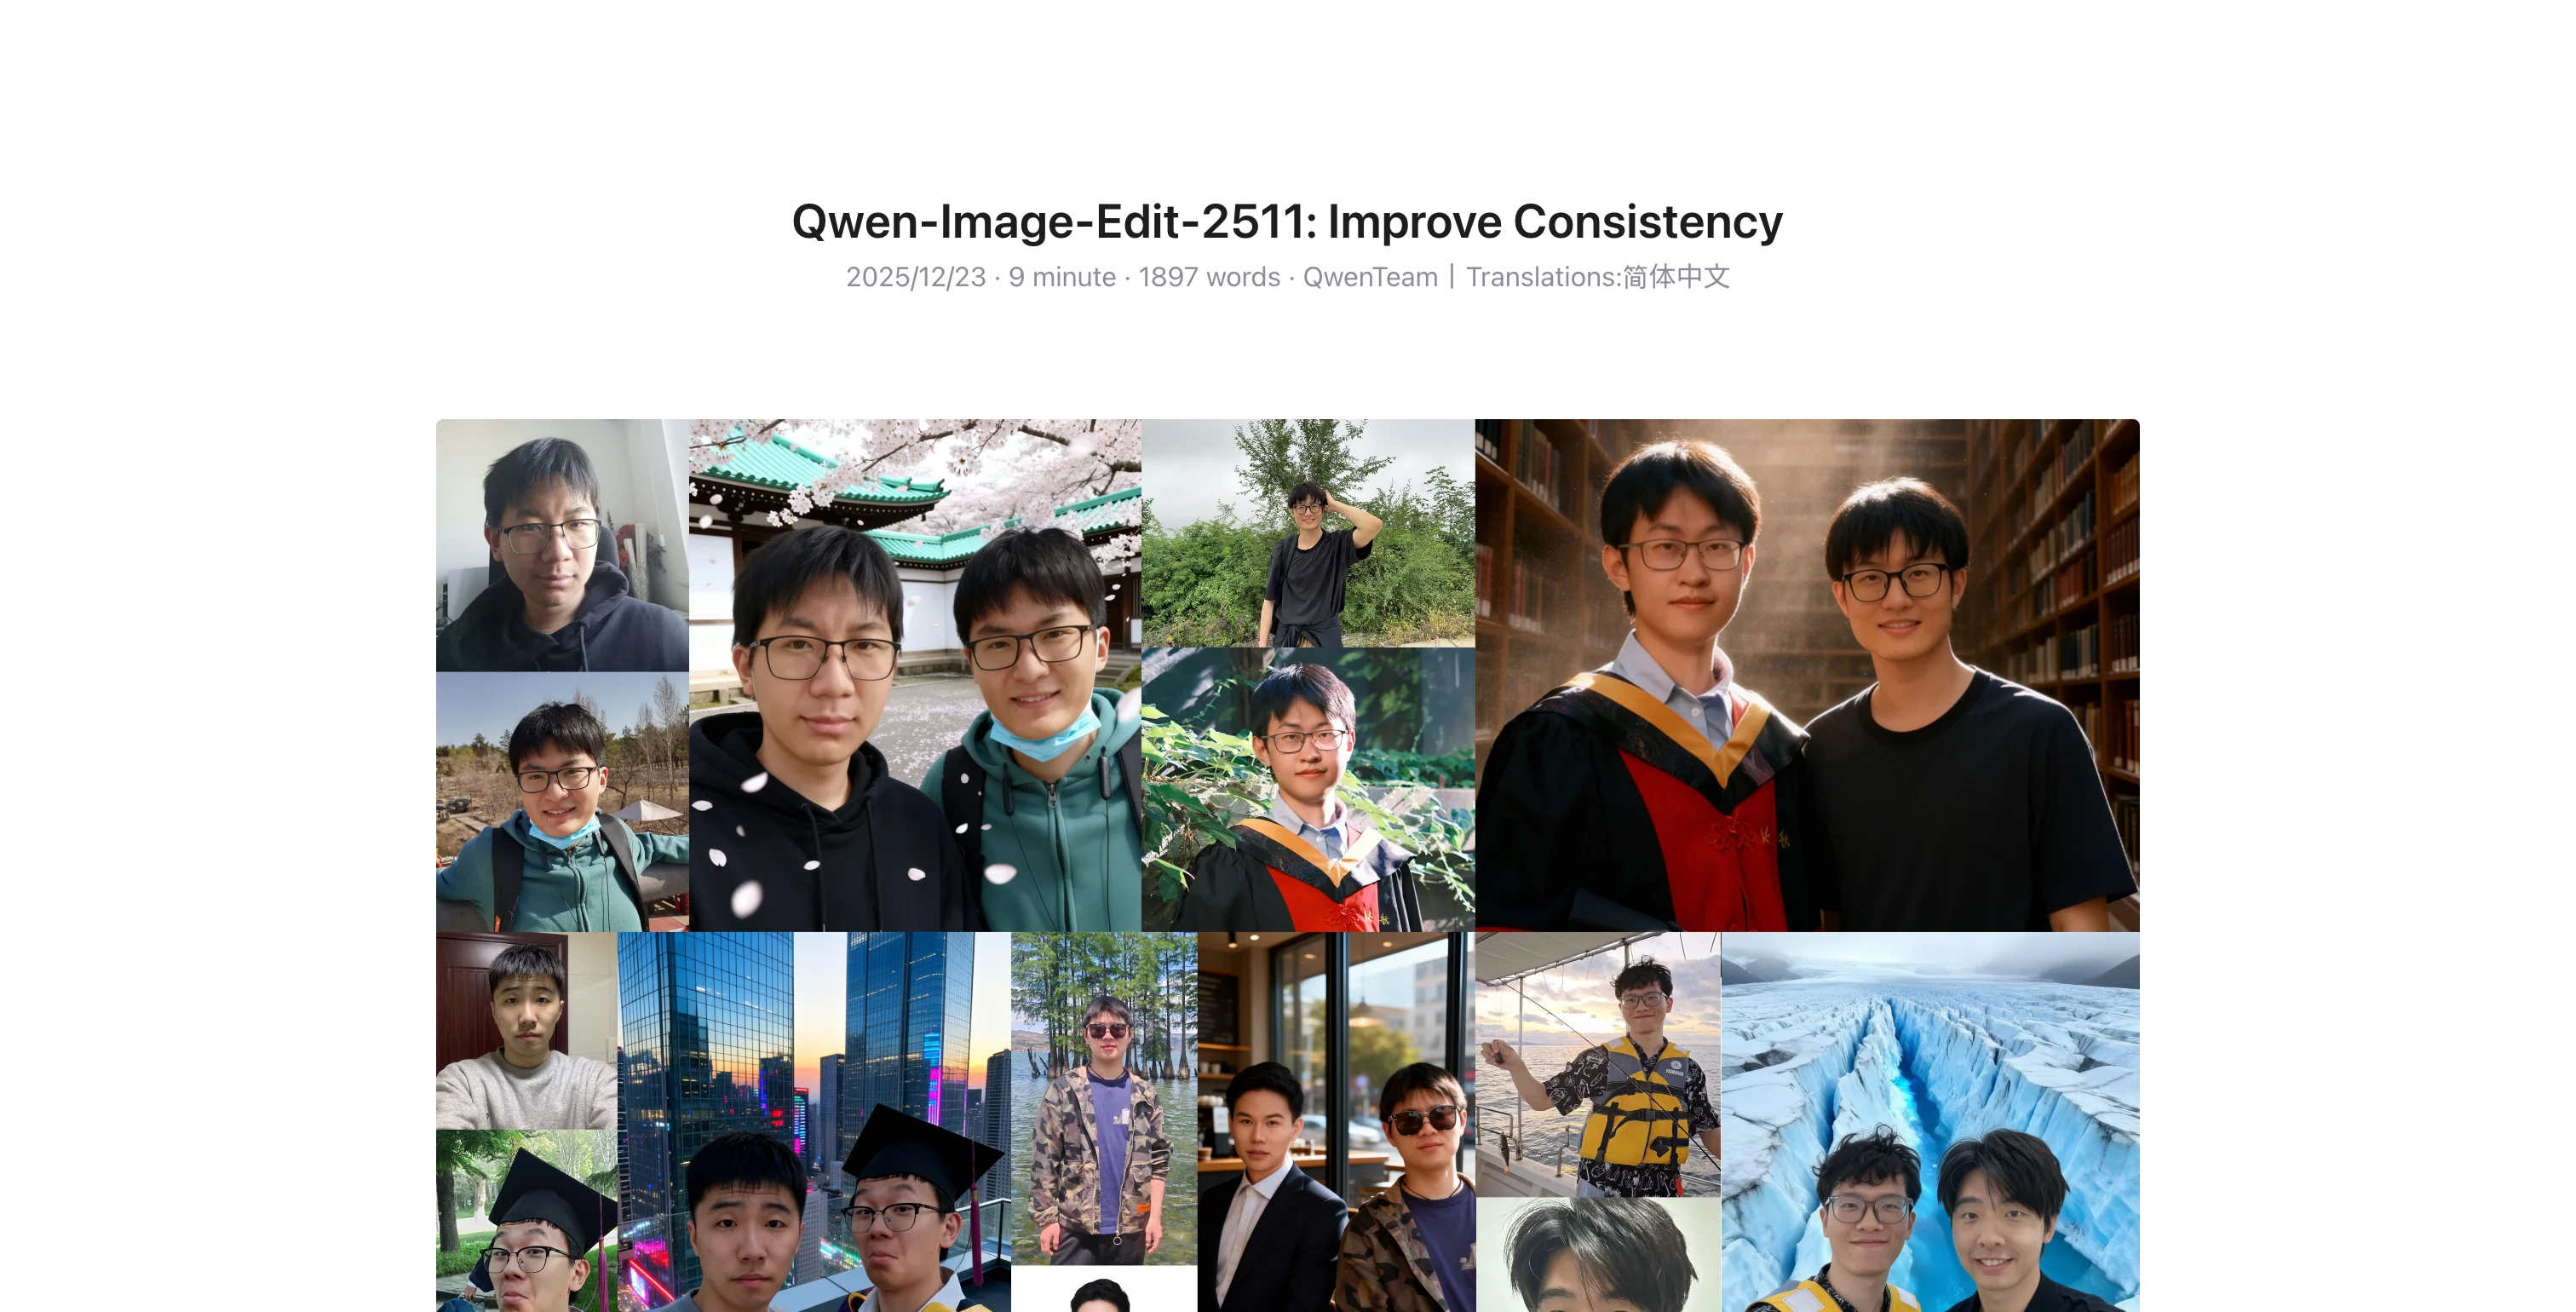
室谷代表取締役人物の同一性(キャラクターコンシステンシー)が大きく改善、という点は分かりやすいですよね。
テキトー教師DotAI 認定講師別々に撮った2枚の人物写真を、1枚の自然な集合写真に合成する精度が上がったんですよ。顔が似てる別人になる、みたいな失敗が減るイメージです。
室谷代表取締役これ、撮影の段取りを組む側からすると影響が大きいんですよね。全員の予定を合わせる必要がなくなるわけで。
テキトー教師DotAI 認定講師人物+人物、人物+製品、人物+シーンみたいな組み合わせは2509からの流れなんですけど、仕上がりの自然さが一段違う、という声が多いです。
コミュニティ製LoRAの効果をベースモデルに統合
室谷代表取締役これ、業界的には面白い動きなんですよ。ユーザー側が作ったLoRAの効果を本体に取り込む、と。
テキトー教師DotAI 認定講師ライティングを強化するもの、新しい視点を出すもの、みたいな定番のLoRAがあるんですけど、2511だとそれを追加で入れなくても近い効果が乗っている、という整理になります。
室谷代表取締役外側のエコシステムの成果を本体が吸い上げる形なので、外付け前提だったワークフローが短くなる。組み立ての手数が減るのは現場で効きますよね。
工業デザインと幾何学的推論の強化
室谷代表取締役ここは用途がはっきり分かれるところで、バッチで製品デザインを生成したり、部品の質感を置き換えたり。
テキトー教師DotAI 認定講師幾何学的推論も強化されていて、デザインや注釈用の補助線をそのまま生成できるんですよ。図面っぽいやり取りができるのは、初めて触る人が驚くポイントかも。
室谷代表取締役デザインのバリエーション出しって、外注だと1案いくら、の世界じゃないですか。それが回数を気にせず回せるなら、発注の組み方自体が変わる。
まあ、出力をそのまま製品に使えるかは別問題なので、そこは用途ごとに判断なんですけど。
まあ、出力をそのまま製品に使えるかは別問題なので、そこは用途ごとに判断なんですけど。
まずは無料で試したい:Qwen Chatならインストール不要
Qwen Chatで画像編集を開くまでの流れ
- ブラウザで chat.qwen.ai を開く(インストール作業はなし)
- チャット画面の機能から「Image Editing」を選ぶ
- 編集したい画像を読み込ませて、やってほしい編集を文章で書いて送る
室谷代表取締役一番ハードルが低い入口はここなんですよね。環境構築ゼロで、ブラウザだけで動く。
まず触ってみるっていう目的なら、これ以上の近道はない・・・
まず触ってみるっていう目的なら、これ以上の近道はない・・・
テキトー教師DotAI 認定講師初めて触る人は「ローカルに環境を作らないと試せないんですか」って身構えるんですよ。でも画面から「Image Editing」を選ぶだけで動くので、そこは拍子抜けするくらいです。
室谷代表取締役公式が「最高品質を求めるならローカルで」と言う理由
テキトー教師DotAI 認定講師ただ、公式ブログに気になる注記があるんですよ。オンライン版は速度優先の最適化が入っているので、最高の品質を求めるならModelScope経由でローカルにデプロイすることを推奨する、と。
室谷代表取締役それは商売的にも筋が通ってる話で。無料で触れる場所は「まず使ってもらう」ための投資で、品質の天井は自前で用意してくださいという線引きなんですよ。
MYUUUでも、無料枠で当たりを取ってから、効く業務だけローカルに落とす順番にしてます。
MYUUUでも、無料枠で当たりを取ってから、効く業務だけローカルに落とす順番にしてます。
テキトー教師DotAI 認定講師現場感覚で言うと、その二段構えが一番失敗しにくいんですよね。最初からローカル前提で組むと、環境づくりでつまずいて「合わなかった」で終わっちゃう人が出ますから。
室谷代表取締役順番が大事ってことですね。
どんな写真だと違いが分かりやすい?
テキトー教師DotAI 認定講師違いが分かりやすいのは、人物がはっきり写っている写真ですかね。同じ人を別のポーズやスタイルに変えたときに、顔立ちや雰囲気が保たれているかどうかが分かれ目になります。
室谷代表取締役あと、別々に撮った2枚の人物写真を1枚の自然な集合写真に合成するやつ。あれは出来不出来がはっきり出るので、比較用のサンプルとしては分かりやすいです。
テキトー教師DotAI 認定講師工業デザイン寄りだと、同じ製品の質感を置き換えるような使い方も公式のショーケースで挙がってます。ただ、最初の一枚は身近な人物写真のほうが体感しやすいと思います。
ComfyUIでローカル実行する手順とモデルの置き場所
必須は3種類、LoRAは「あれば速い」の任意枠
ComfyUIでローカル実行する手順
- 01モデル本体を配置qwen_image_edit_2511_bf16.safetensors などを models/diffusion_models/ に置く(FP8量子化版でも可)
- 02テキストエンコーダを配置qwen_2.5_vl_7b_fp8_scaled.safetensors を models/text_encoders/ に置く
- 03VAEを配置qwen_image_vae.safetensors を models/vae/ に置く
- 04LoRAを配置(任意)速くしたい場合だけ Lightning 4steps LoRA を models/loras/ に置く
- 05ComfyUIを再起動置いただけでは反映されないため再起動する
- 06ワークフローJSONを読み込むテンプレートライブラリで「Qwen-Image-Edit-2511」を検索して読み込む
室谷代表取締役ComfyUIで動かす話、最初に引っかかるのが「何をどこに置くか」なんですよね。公式チュートリアルを見ると、まず押さえるべきファイルは3種類です。
テキトー教師DotAI 認定講師そうなんですよ。初めて触る人が最初に戸惑うのがまさにそこで、ダウンロードはできたのに、どこに置けばアプリが拾ってくれるのか分からない、と手が止まるんです。
室谷代表取締役で、ネットだと「4種類そろえろ」って書かれてたりするんですけど、4つ目は高速化用のLoRAなので、無くても動きます。ここ混同すると、揃えるまで動かせないと思い込んじゃうんですよね。
テキトー教師DotAI 認定講師現場感覚で言うと、必須はモデル本体・テキストエンコーダ・VAEの3つ。LoRAは入れなくても動くけど、入れると生成ステップを減らせる、という別枠の扱いです。
| 種類 | ファイル例 | 置き場所 | 必須か |
|---|---|---|---|
| Diffusion Model | qwen_image_edit_2511_bf16.safetensors など | models/diffusion_models/ | 必須 |
| Text Encoder | qwen_2.5_vl_7b_fp8_scaled.safetensors(8.73GB) | models/text_encoders/ | 必須 |
| VAE | qwen_image_vae.safetensors | models/vae/ | 必須 |
| 高速化LoRA | Qwen-Image-Edit-2511-Lightning-4steps-V1.0-bf16.safetensors | models/loras/ | 任意 |
置いてからワークフローを読み込むまでの手順
- モデル本体をダウンロードし、
models/diffusion_models/に置く(例:qwen_image_edit_2511_bf16.safetensors、FP8量子化版でも可) - テキストエンコーダ
qwen_2.5_vl_7b_fp8_scaled.safetensorsをmodels/text_encoders/に置く - VAE
qwen_image_vae.safetensorsをmodels/vae/に置く - 速くしたい場合だけ、Lightning 4steps LoRA を
models/loras/に置く - ComfyUI を再起動する
- テンプレートライブラリで「Qwen-Image-Edit-2511」を検索し、ワークフローJSONを読み込む
テキトー教師DotAI 認定講師手順だけ見るとシンプルなんですけど、フォルダ名を1文字間違えるだけで認識されないんですよ。ファイル名はコピペで合わせるのが安全です。
室谷代表取締役あと再起動、これ忘れがちなんですよね。置いたのに出てこない、って相談の半分はたぶんこれです。
テキトー教師DotAI 認定講師たしかに。読み込み後にノードへファイルを割り当てるので、最初はワークフローJSONから入るのが一番ラクです。
diffusers(Pythonコード)から呼び出す書き方
室谷代表取締役バッチで回したいとか、社内ツールに組み込みたいなら、コードから叩けたほうが都合がいいんですよね。
テキトー教師DotAI 認定講師その場合は diffusers 経由ですね。まずライブラリを入れて、パイプラインを読み込む流れになります。
python
pip install git+https://github.com/huggingface/diffusers

from diffusers import QwenImageEditPlusPipeline

pipeline = QwenImageEditPlusPipeline.from_pretrained(
    "Qwen/Qwen-Image-Edit-2511"
)

result = pipeline(
    image=[img1, img2],
    prompt="two people standing together in a park",
    true_cfg_scale=4.0,
    negative_prompt=" ",
    num_inference_steps=40,
    guidance_scale=1.0,
)image に配列で複数枚渡せるのがポイントで、複数人物の合成なんかもこの形で投げられます。モデルは20Bパラメータ、BF16です。室谷代表取締役初めて触る人が戸惑いがちなポイント
テキトー教師DotAI 認定講師一番多いのが「ダウンロードしたファイルの種類が分からない」なんですよね。safetensors が3つ並んでると、どれがどれか見分けがつかないと。
室谷代表取締役ファイル名に何が入っているか書いてあるので、そこを見るのが早いですね。vae なら VAE、vl が付いていればテキストエンコーダ、という具合です。
テキトー教師DotAI 認定講師あとは量子化版を選んだ場合に、拡張ノード側の準備が別で要るパターンですね。GGUFを選ぶとそこで詰まる人が多いので、最初は公式テンプレートと同じ構成で動かすのがおすすめです。
室谷代表取締役ワークフローをチームに配る前提なら、フォルダ構成を最初に揃えておくのが後々効きます。人によって置き場所が違うと、共有したJSONが片方でしか動かない、なんてことが起きるので。
FP8とGGUFはどっちを選ぶ?VRAM別の目安と高速化
FP8版(モデル本体約19GB)の必要VRAMと生成時間の目安
室谷代表取締役FP8のモデル本体、約19GBなんですよね。で、実際に回すと22GB前後のVRAMを持っていかれる、と。
検証者の環境での数字ですけど、16GBのカードだとそのままじゃ載らない計算になります。
検証者の環境での数字ですけど、16GBのカードだとそのままじゃ載らない計算になります。
テキトー教師DotAI 認定講師現場でよく聞くのがまさにそこなんですよ。「16GBあるからFP8でいけるでしょ」で落ちるパターン。
1枚28秒、3枚で52秒という速度は魅力的なんですが、先に載るかどうかですよね。
1枚28秒、3枚で52秒という速度は魅力的なんですが、先に載るかどうかですよね。
室谷代表取締役速さの前に「載る/載らない」で切る。ここはベンチマーク表を眺めるより、自分のVRAMで判断した方が早いんですよ。
テキトー教師DotAI 認定講師たしかに。表の数字と実際の消費は別物なので、余裕を見て選ぶのが安全ですね。
GGUF量子化版はどこまで軽くなる?Q4_K_MとQ3の違い
室谷代表取締役で、載らないならGGUFに落とす。Q4_K_Mでファイルサイズ約13.9GB、Q3だと約10GBまで下がるんですよね。
ここまで来ると現実味が出てくる。
ここまで来ると現実味が出てくる。
テキトー教師DotAI 認定講師初めて触る人が戸惑うのが、GGUFは本体だけじゃ動かないところなんですよ。ComfyUI-GGUFの拡張ノードと、mmprojというテキストエンコーダ用の補助ファイルが別途必要で、そちらが約1.26GB。
室谷代表取締役ファイルが増える分、置き場所を間違えると「動かない」で30分消えるやつですね。
テキトー教師DotAI 認定講師あとメインRAMも見ておきたいところで。モデルのオフロードが入るので、32GB以上あると気持ちがかなり楽になります。
12GB/16GB/22GB別・選び方の早見表
VRAM別・FP8とGGUFの選び方早見表
| VRAM | GGUF Q3 | GGUF Q4_K_M | FP8 |
|---|---|---|---|
| 12GB | ○ | × | × |
| 16GB | ○ | ○ | × |
| 22GB〜 | ○ | ○ | ○ |
| ファイルサイズ | 約10GB | 約13.9GB | 約19GB |
| 生成時間の目安 | 30秒/1枚・55秒/3枚 | VRAM16GBに収まる | 28秒/1枚・52秒/3枚 |
室谷代表取締役まとめるとこうです。VRAM別の判断を一枚にすると分かりやすい。
| VRAM | 現実的な選択肢 | 生成時間の目安 |
|---|---|---|
| 12GB | GGUF Q3(約10GB) | 30秒/1枚・55秒/3枚 |
| 16GB | GGUF Q4_K_M(約13.9GB) | VRAM16GBに収まる |
| 22GB〜 | FP8(本体約19GB) | 28秒/1枚・52秒/3枚 |
※時間は検証者個人の環境(RTX 5060Ti 16GB/RTX 3060 12GB)での結果で、環境により変わります。
テキトー教師DotAI 認定講師Q3で12GBでも動く見込みというのは大きいですね。しかも30秒/1枚、3枚で55秒。
FP8と比べて極端に遅くなるわけじゃないのが救いです。
FP8と比べて極端に遅くなるわけじゃないのが救いです。
室谷代表取締役逆に22GB積めるならFP8で迷わない、と。GPUを買い増すか、量子化で我慢するかは普通にコスト判断なので、そこで悩むのは健全だと思います。
Lightning LoRAで40ステップを4ステップにする
室谷代表取締役で、速度はモデル選びよりLoRAで縮むんですよ。Lightningの4ステップ版を入れると、40ステップが4ステップになる。
テキトー教師DotAI 認定講師ええ、ComfyUIの公式ワークフローだとデフォルトが20ステップなので、そこから4ステップへの短縮は体感で分かりますね。LoRAは models/loras/ に置くだけです。
室谷代表取締役LightX2Vも2511向けにDay 0で対応を出していて、NFEを25倍削減、全体で42.55倍という主張をしてる。主張ベースの数字なので鵜呑みにはしないですけど、方向性としては素直に効く領域なんですよね。
テキトー教師DotAI 認定講師最初は4ステップで回して、仕上がりに不満が出たところだけステップを増やす。その順番が現実的だと思います。
写真の向きを変えたい:Multiple Angles LoRAと3Dカメラノード
3Dカメラノードで角度やショットサイズを指定する仕組み
室谷代表取締役1枚の写真から同じ被写体を別アングルで作り直す。これ、ComfyUIの公式テンプレートでできるんですよね。
「Generate Multiple Angles with 3D Camera Node」というやつで。
「Generate Multiple Angles with 3D Camera Node」というやつで。
テキトー教師DotAI 認定講師現場でよく聞くのが「プロンプトに『横顔』って書いても全然変わらないんですけど」という相談なんですよ。言葉だけで角度を伝えるのは、もともとかなり苦手な領域で。
室谷代表取締役そこで3Dビューポート上でカメラをぐっと動かすと、「front view eye-level shot medium shot」みたいなプロンプトが自動で組み上がる。人が文章を考えるんじゃなくて、操作がプロンプトに翻訳される仕組みなんですよ。
テキトー教師DotAI 認定講師仰角もショットサイズも、ワイドからクローズアップまで操作で決まります。最初に戸惑うのが「カメラを動かすのか、被写体を動かすのか分からない」ところで、そこは公式テンプレートの画面を開けば一発で分かります。
Turbo modeと高品質パスの切り替え
室谷代表取締役このテンプレート、Turbo modeがデフォルトで有効になってるんですよね。4ステップ・CFG1で、中身はLightning LoRAです。
テキトー教師DotAI 認定講師角度を何パターンも試すなら、まずこれで正解だと思います。オフにすると40ステップ・CFG4の高品質パスに切り替わる。
Turboで当たりを探して、決まった構図だけ高品質で回す流れが現場感覚だと一番多いです。
Turboで当たりを探して、決まった構図だけ高品質で回す流れが現場感覚だと一番多いです。
室谷代表取締役制作の現場でも同じで、探索は安く速く、本番だけ重く。全部同じ単価で回すのは経営的にもったいないんですよ。
テキトー教師DotAI 認定講師たしかに。4ステップで出た絵をそのまま確定させる前に、1回だけ高品質パスで見ておくと安心できますね。
ブラウザのHugging Face Spaceで試す手順
- ブラウザでHugging FaceのSpace「multimodalart/qwen-image-multiple-angles-3d-camera」を開く
- 人物または物体の写真を1枚アップロードする
- 3Dビューポート上でカメラを操作し、向き・仰角・ショットサイズを決める
- 生成を実行する(ボタン名や入力欄の位置は公式ページの表示に従う)
テキトー教師DotAI 認定講師ローカル環境を組む前に、まずブラウザで触ってみるのがおすすめです。Spaceならインストールもモデルのダウンロードも要らないので、3Dカメラノードの操作感だけ先に掴めます。
室谷代表取締役環境構築に何時間もかける前に、UIの感触を確かめるのは順番として正しいんですよね。そこで判断できてからローカルに投資すればいい。
テキトー教師DotAI 認定講師生成すると被写体がズレる「ピクセルシフト」の原因と対処
なぜ位置がズレるのか:1024付近への丸め込みという指摘
ピクセルシフトの原因と対処
原因
- 編集前後で被写体の位置がわずかにずれる現象
- Xのコミュニティで「ピクセルシフト」と呼ばれる
- 内部で生成解像度を1024付近かつ8の倍数に丸め込んでいるという指摘
- 指定サイズを使わず都合のいいサイズへ寄せるため構図がずれる
- 投稿者ベースの情報で技術的原因の正確さは要検証
予防策
- 編集に入れる前にずれないサイズへクロップ
- 最初から丸め込みが起きない寸法に整える
- 後工程で直すより入口で潰すほうが工数は安い
- 何十枚もまとめて処理する場合は特に有効
- どの倍数に合わせれば確実かは公式明記なし・手元で試す
室谷代表取締役前の章でアングルを変える話をしましたけど、2511で地味に困るのが、編集の前後で被写体の位置がわずかにずれる現象なんですよね。X のコミュニティで「ピクセルシフト」と呼ばれて報告されているやつです。
テキトー教師DotAI 認定講師たしかに、現場でも「合成したら顔の位置がちょっとだけ動いた」という声は聞きます。原因として指摘されているのが、内部で生成解像度を1024付近かつ8の倍数に丸め込んでいる、という話なんですよ。
室谷代表取締役こちらの指定サイズをそのまま使わずに、都合のいいサイズへ寄せにいくと。それで元画像と出力で構図がずれる、という構造ですね。
テキトー教師DotAI 認定講師そういうことですね。ただこれ、投稿者さんの指摘ベースの情報なので、技術的な原因の正確さは要検証なんです。
現象としては起きている、くらいの温度で見ておくのがいいと思います。
現象としては起きている、くらいの温度で見ておくのがいいと思います。
予防策:事前にクロップしてサイズを合わせておく
テキトー教師DotAI 認定講師で、対策は2つあるんですよ。ひとつが「予防」で、編集に入れる前にずれないサイズへ画像をクロップしておく方法です。
最初から丸め込みが起きない寸法に整えておけば、位置は動きにくくなります。
最初から丸め込みが起きない寸法に整えておけば、位置は動きにくくなります。
室谷代表取締役先にそっちをやるべきなんですね。後工程で直すより、入口で潰したほうがトータルの工数は安い。
手作業で位置を合わせ直す時間を人件費に換算すると、正直ばかにならないので。
手作業で位置を合わせ直す時間を人件費に換算すると、正直ばかにならないので。
テキトー教師DotAI 認定講師そうなんですよ。特に何十枚もまとめて処理する場合は、1枚ずつ直す運用だとキツくなりますから。
クロップ前提でフローを組んでおくのが現実的ですね。
クロップ前提でフローを組んでおくのが現実的ですね。
室谷代表取締役了解です。ただ、どの倍数に合わせれば確実に消えるのか、みたいな細かい仕様が公式に明記されているわけではないので、そこは手元で試して確認するしかない、と。
補正策:AKAZE特徴点とRANSACで位置合わせするノード
テキトー教師DotAI 認定講師もうひとつが「補正」で、生成が終わってから位置を合わせ直すアプローチです。AKAZE の特徴点を取って、RANSAC でずれを推定して揃える、という ComfyUI 用のカスタムノードとワークフローが GitHub で公開されています。
室谷代表取締役画像処理の定番の組み合わせですね。編集後の見た目は保ったまま、位置だけ元に戻せるので、構図を固定したい案件では効きそうです。
テキトー教師DotAI 認定講師初めて触る人はノードの追加で戸惑うかもしれませんが、ワークフローごと配布されているので、読み込んでしまえば流れは追えます。似た指摘や改造ノードを出している人もいて、知見が溜まってきている印象です。
室谷代表取締役予防と補正、両方用意しておくのが堅いですね。こういう修正がすぐ出てくるあたり、このモデルの使われ方の熱量が伺えます。
商用利用はできる?Apache 2.0とQwen Chat利用規約の違い
ローカル・セルフホストで生成した画像は商用利用できる
室谷代表取締役ここ、制作物を外に出す立場だと一番気になるところなんですよ。モデル本体のライセンスはApache 2.0で、Hugging FaceのモデルカードにもGitHubのREADMEにもそう明記されてる。
つまり自分の環境やAPIでセルフホストして生成した画像は、Apache 2.0の範囲で商用利用が制限されない、という整理になるんですよね。
つまり自分の環境やAPIでセルフホストして生成した画像は、Apache 2.0の範囲で商用利用が制限されない、という整理になるんですよね。
テキトー教師DotAI 認定講師たしかに。そこを「AIで作った画像は商用NGでしょ」と混同してる人が多くて、現場でよく聞くのは「これ納品物に使って大丈夫ですか」という質問なんですよ。
ローカルで回してる分にはライセンス上は問題ない、というのがまず押さえる線ですね。
ローカルで回してる分にはライセンス上は問題ない、というのがまず押さえる線ですね。
室谷代表取締役そうなんですよ。納品前提の仕事だと、この一文があるかないかで提案の幅が変わる。
逆に言うと、ローカル前提で組める案件かどうかを最初に見極めるのが、コスト的にも一番効くんですよ。
逆に言うと、ローカル前提で組める案件かどうかを最初に見極めるのが、コスト的にも一番効くんですよ。
Qwen Chat経由は個人の学習・研究目的が原則
室谷代表取締役ただ、同じモデルでも公式チャットのQwen Chat上で作った場合は話が別で。利用規約の「II.2.3 Non-commercial Use」に、個人の学習・研究・実験目的のみ、商用は事前の書面同意が必要、と書かれてるんですよね。
テキトー教師DotAI 認定講師ここが一番ハマりやすいところで。ブラウザで無料で試せてしまうので、「ローカルと同じモデルなんだから同じ扱いだろう」と思い込んでしまう。
入り口が違えば適用される規約も変わる、というのが実感として伝わりにくいんですよ。
入り口が違えば適用される規約も変わる、というのが実感として伝わりにくいんですよ。
室谷代表取締役GitHubのissueでも同じ疑問が上がってて、#98のスレッドが2025年8月に投稿されて、12月時点でもOpenのまま。Qwen側から公式な明確化はまだ出ていない、という状態なんですよね。
テキトー教師DotAI 認定講師グレーというより、書いてある通りに読めば非商用なんですよね。曖昧なのは解釈の余地ではなくて、質問に対する回答が出ていないという意味で。
「同じモデルだから大丈夫」は通らない
室谷代表取締役入口ごとに条件が分かれるので、一度ここで整理しておきましょうか。
| 利用経路 | 適用される条件 | 商用利用 |
|---|---|---|
| ローカル・セルフホスト | Apache 2.0 | 制限されない |
| Qwen Chat | Qwen Chat利用規約 II.2.3 | 個人の学習・研究・実験目的のみ。商用は事前の書面同意が必要 |
テキトー教師DotAI 認定講師こうして並べると分かりやすいですね。同じ重みを使っていても、入り口が違うだけで条件がここまで変わる。
室谷代表取締役で、「たぶん大丈夫だろう」で本番に進めるのは、正直おすすめしないんですよ。判断を戻せない種類の話なので。
Qwen Chat・ローカル・APIの使い分け自体はQwen-Image-Editの使い方で整理してるので、入口を選ぶ段階で確認しておくのが安全ですね。
Qwen Chat・ローカル・APIの使い分け自体はQwen-Image-Editの使い方で整理してるので、入口を選ぶ段階で確認しておくのが安全ですね。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこなんですよ。「どれで作ったか」を後から説明できる状態にしておく、という発想を持つだけでだいぶ変わります。
商用利用の前に確認しておきたいポイント
利用経路ごとの商用利用条件
| 利用経路 | 適用される条件 | 商用利用 |
|---|---|---|
| ローカル・セルフホスト | Apache 2.0 | 制限されない |
| Qwen Chat | Qwen Chat利用規約 II.2.3 | 個人の学習・研究・実験目的のみ。商用は事前の書面同意が必要 |
室谷代表取締役前提として、規約は更新されうるので、商用で使う前にQwen Chatの最新の利用規約を公式サイトで確認してほしいんですよね。ここは一次情報を見るしかない。
テキトー教師DotAI 認定講師そうですね。あわせて、どの経路でいつ生成したかの記録を残しておくと、後から社内や取引先に説明しやすいんですよ。
生成物そのものより、経路のログが効いてきます。
生成物そのものより、経路のログが効いてきます。
室谷代表取締役経営目線で言うと、権利まわりは事故ったときのコストが一番大きい。10分の確認と一次情報のメモでそのリスクを消せるなら、やらない理由がないんですよね。
よくある質問
Q1. 2511の一次情報はどこで追えばいい?
室谷代表取締役配布元のモデルカードとQwenの発表ページを見るのが早いんですよね。使い方も制限もそこにまとまってるので。
テキトー教師DotAI 認定講師現場でよく聞くのは「ブログの手順が古くて動かない」なんですよ。公式のサンプルワークフローを基準にすると迷子になりにくいですね。
室谷代表取締役更新情報はリリースノート単位で追う。これが結局一番コスパいいです。
Q2. Qwen Chatとローカルで仕上がりが違うのはなぜ?
室谷代表取締役同じモデル名でも、ローカルは量子化や設定で挙動が変わるんですよ。比較するならサンプラーやステップを揃える。
テキトー教師DotAI 認定講師たしかに。最初に戸惑うのが「Chatで良かったのにローカルだと雰囲気が違う」で、設定差なんですよ。
室谷代表取締役あと入力画像の解像度も効く。同じ画像でも縮小されてたら別物になるので、そこは揃えてから比べたいところです。
Q3. プロンプトはどう書くと編集が安定する?
室谷代表取締役変更したい対象を具体的に、保持したい要素を先に書く。曖昧な指示はモデルが勝手に解釈するんですよね。
テキトー教師DotAI 認定講師現場感覚で言うと、「背景はそのまま、服の色だけ」みたいに範囲を絞ると安定しやすいですね。
室谷代表取締役一度で決めずに、変更箇所を分けて複数回に分けるのも手。編集系は小分けの方が破綻しにくいです。
Q4. 2509向けのLoRAは2511でも使える?
室谷代表取締役互換は保証されないケースが多い。配布元が対応モデルを明記してるか確認するのが先です。
テキトー教師DotAI 認定講師最初に戸惑うのが、読み込めても結果が崩れるパターン。動いたからOKとは限らないんですよ。
室谷代表取締役検証は少ない枚数で。本番前に比較画像を出しておくと後で楽なんですよね。
Q5. 2509と2511を両方残す意味はある?
室谷代表取締役再現性が必要な案件は旧バージョンを残す。ワークフローが依存してる場合もあるので。
テキトー教師DotAI 認定講師現場でよく聞くのは「前の出力と同じにして」の要望。ディスクと相談ですが、残す価値はありますね。
室谷代表取締役ただ運用が複雑になるなら、どちらかに寄せた方が強い。判断は案件次第です。
まとめ
室谷代表取締役2511は2509の延長線上で、強くなった部分を自分の用途で確認するのが大事なんですよね。ローカルは設定差が大きいので、Chatと比べるなら条件を揃える。
テキトー教師DotAI 認定講師そうですね。最初から全部を完璧にしようとせず、まずは公式のサンプルで一回通す。
そこで詰まったら、モデルの置き場所と設定を見直すのが早いです。
そこで詰まったら、モデルの置き場所と設定を見直すのが早いです。
室谷代表取締役商用で使うなら、モデルのライセンスとQwen Chatの規約は別物として確認する。ここは後から慌てないように先に押さえておきたいところです。
テキトー教師DotAI 認定講師まずは無料で触って、自分の用途で「どこまで保持できるか」を試すのがおすすめですね。
室谷代表取締役うん、小さく試して、効くなら広げる。その順番が結局一番安く済みます。