Claudeが使えないとき、まず何を見て切り分ければいい?
まず開くのはstatus.claude.com——コンポーネント別の表示と稼働率の読み方
 室谷代表取締役
「Claudeが変だな」と感じたとき、最初に開くのは status.claude.com なんですよね。原因をあれこれ推測する前に、ここを見るのが順番なんですよ。
 テキトー教師DotAI 認定講師
たしかに。ただ、初めて開くと「どこを見ればいいの?」ってなるんですよ。
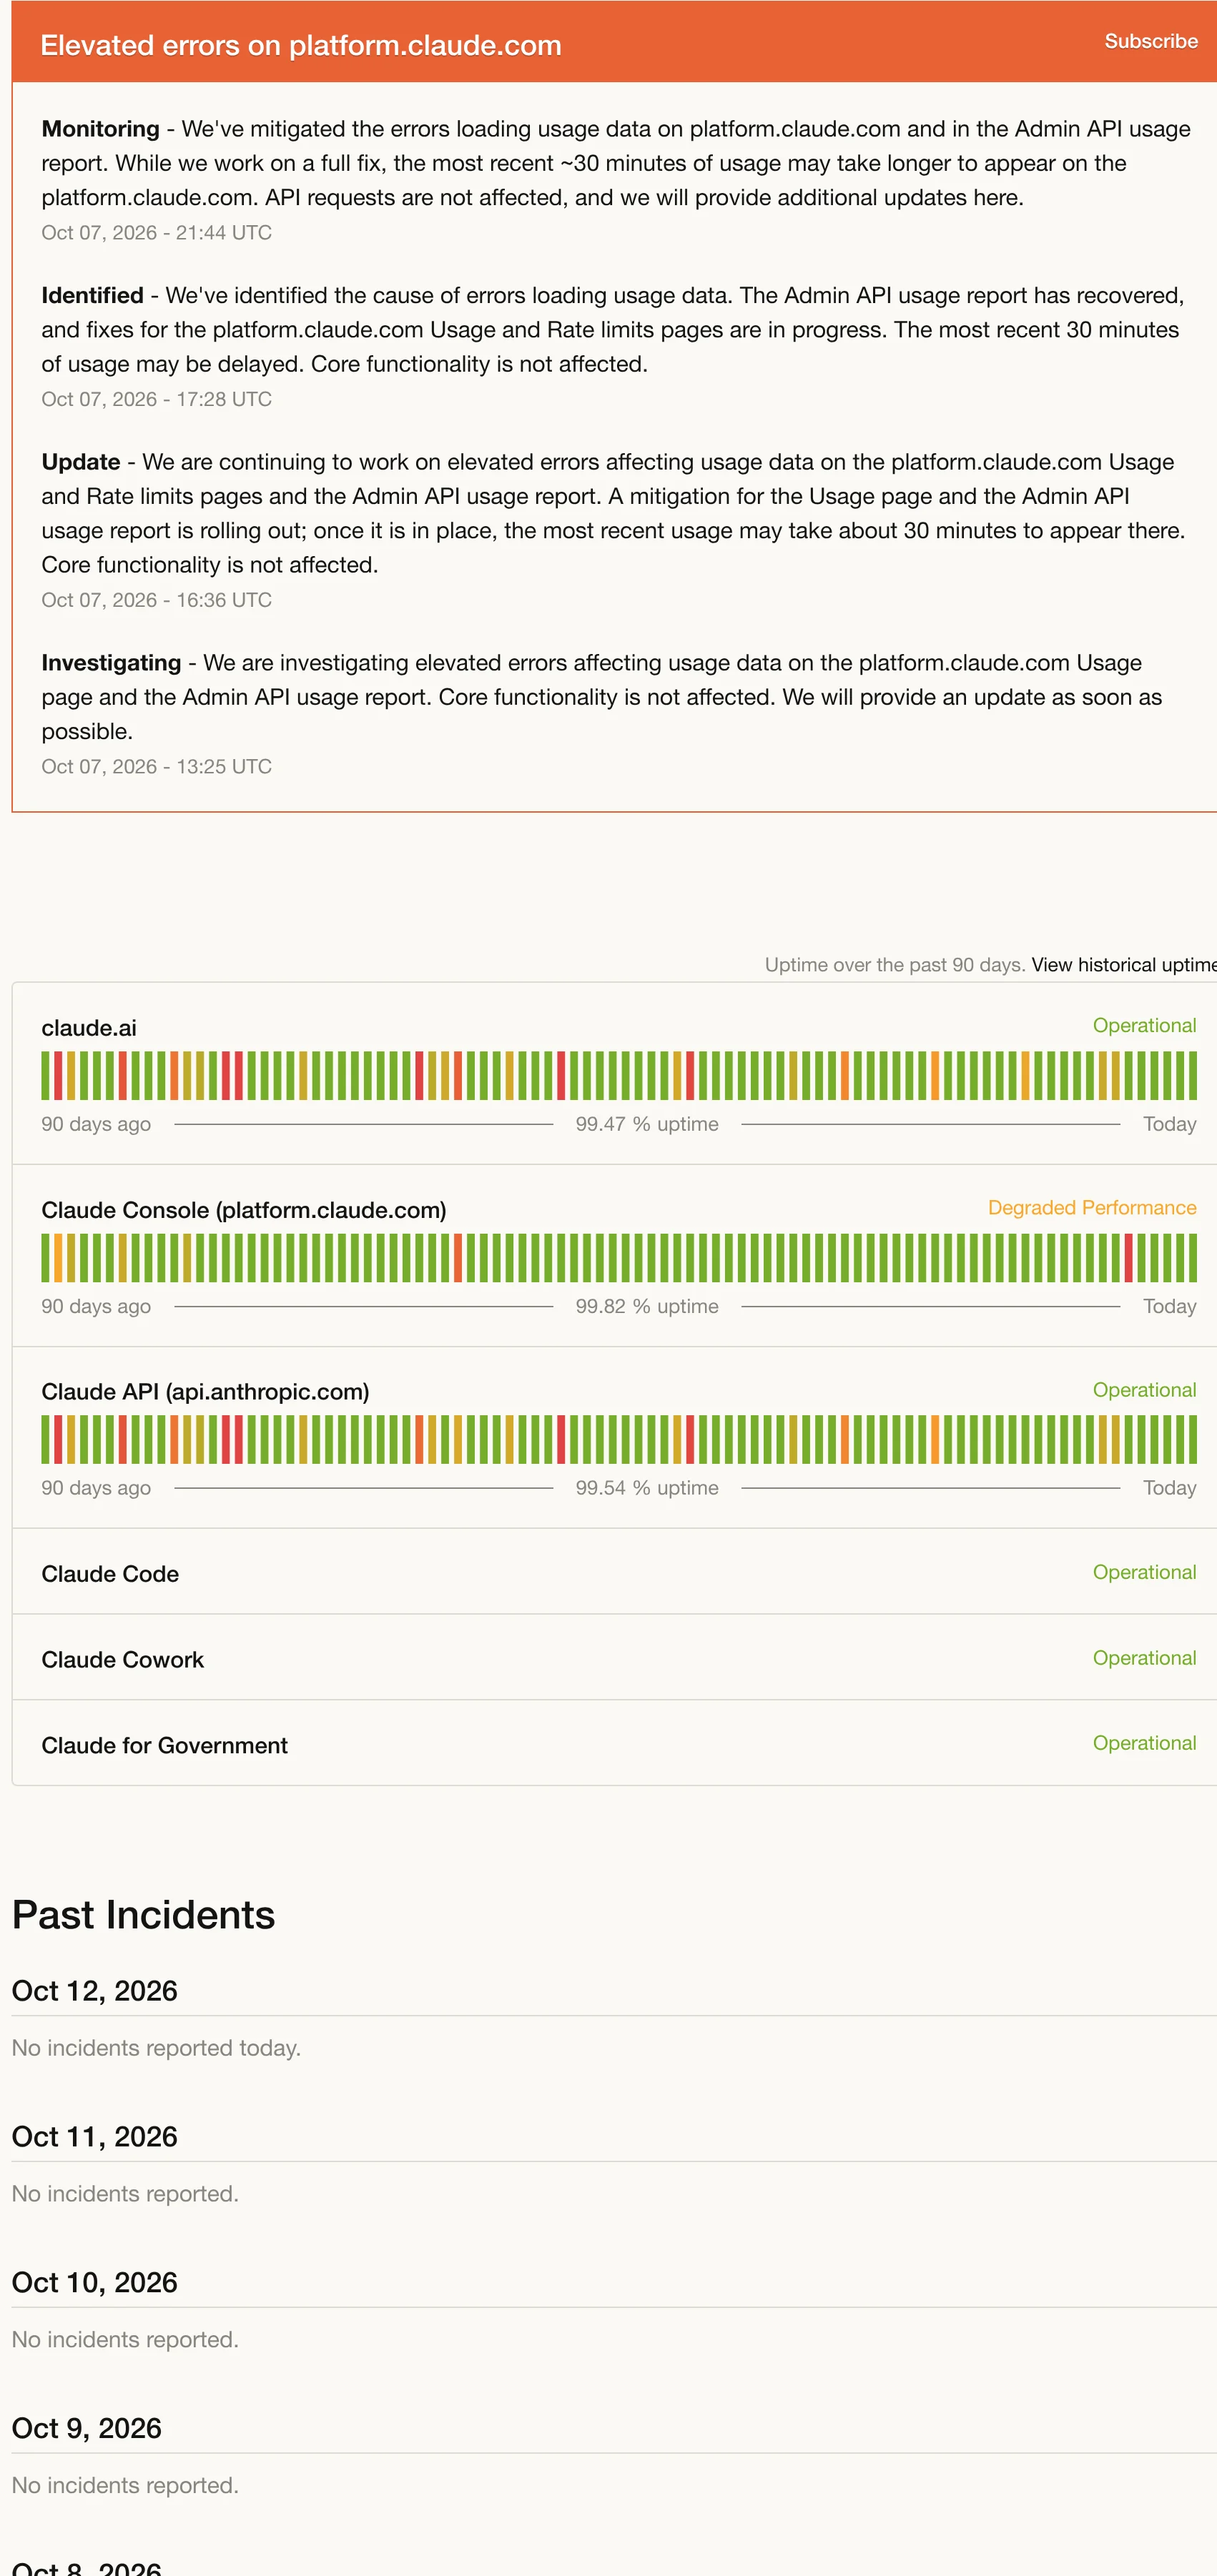
コンポーネントが6つ並んでいて、claude.ai、Claude Console、Claude API、Claude Code、Claude Cowork、Claude for Government がそれぞれ個別に状態表示されます。
コンポーネントが6つ並んでいて、claude.ai、Claude Console、Claude API、Claude Code、Claude Cowork、Claude for Government がそれぞれ個別に状態表示されます。
室谷代表取締役そう、全部まとめて「障害中」にはならないんですよ。Claude Code の行だけ Degraded Performance で、API は Operational、みたいなことが普通にある。
自分が使っている行を見ないと判断を誤るんですよね。
自分が使っている行を見ないと判断を誤るんですよね。
テキトー教師DotAI 認定講師各コンポーネントには直近90日間の稼働率も出ていて、平常時は99%台で並びます。そこが急に落ちていないかを見ると、「今だけ荒れている」のかどうかが掴めます。
旧status.anthropic.comを使っていた人へ——今の正式な窓口
テキトー教師DotAI 認定講師ちなみに、ブックマークに旧URLの status.anthropic.com を残している人、けっこういるんですよ。今は自動で新しいページに転送されるので、開けはします。
室谷代表取締役ただ、社内で共有するリンクに古いドメインが混ざっていると、後から説明するのが地味に面倒なんですよね。正式な窓口は status.claude.com なので、共有するときはこっちに揃えておく。
こういうのは最初に統一しておく方が、結局事故が減ります。
こういうのは最初に統一しておく方が、結局事故が減ります。
障害か自分の環境かを見分けるチェック手順
Claudeが使えないときの切り分けフロー
status.claude.comで自分が使っているコンポーネントに異常が出ているか?
YES / はい(異常あり)
- Degraded Performance / Partial Outage / Major Outage などを確認
- まず復旧を待つ
- インシデントの更新(Investigating → Identified → Monitoring → Resolved)を追う
NO / いいえ(全コンポーネントがOperational)
- 原因は自分の環境側の可能性が高い
- 環境側の確認へ進む
- ログインできない場合は VPN無効 → 拡張機能無効 → キャッシュとCookieをクリア の順で試す
- status.claude.com を開き、自分が使っているコンポーネントの行を確認する
- 全コンポーネントが Operational なら、原因は自分の環境側の可能性が高い
- Degraded Performance / Partial Outage / Major Outage などが出ていれば、まず復旧を待つ
- インシデントの更新(Investigating → Identified → Monitoring → Resolved)を追う
室谷代表取締役切り分けはシンプルで、「ステータスに自分の使っているものが載っているか」だけなんですよね。載っていて復旧中なら待つ、載っていないなら自分の側を疑う。
テキトー教師DotAI 認定講師現場でよく聞くのは「重いだけなのか障害なのか分からない」なんですよ。全コンポーネントが Operational なのに自分だけ調子が悪い、という場合は、次に環境側の確認へ進むことになります。
室谷代表取締役経営の目線で言うと、この切り分けができるだけで初動が全然違うんですよ。問い合わせ対応の現場だと「障害かもしれない」の一次判断に何十分もかけるのが一番もったいないので。
ログインできないときの確認順(VPN・拡張機能・キャッシュ)
ログイン時にエラーが出るときは、公式が案内している順番で試すのが早いです。
- VPNを無効にする
- ブラウザ拡張機能を無効にする
- キャッシュとCookieをクリアする
- それでも直らなければ status.claude.com で障害が出ていないか確認する
テキトー教師DotAI 認定講師ログインできないときって、いきなりパスワードを疑う人が多いんですけど、公式が示しているのはこの順番なんですよ。VPNと拡張機能のところでだいたい片付きます。
室谷代表取締役影響の小さいところから潰す、という並びに意味があるんですよね。いきなりCookieを全部消すと他のサイトのログインまで飛ぶので、まずVPNと拡張機能から。
地味ですけど、これが一番速いんですよ。
地味ですけど、これが一番速いんですよ。
ステータスページは正常なのに使えない——その定番原因
ステータスページが緑でも起きる4つの定番不調
Due to unexpected capacity constraints
障害ではなく、全利用者からの高需要を調整している一時的な状態。ステータスページには表示されない。数分置いて送り直すのが基本。
5-hour limit reached / weekly limit
障害でも容量制約でもなくプラン側の設計。5時間ごとのセッション上限と週次の上限がある。接近時は「Approaching session limit」と使用割合つきで表示。到達時は「5-hour limit reached - resets [time]」「You've reached your weekly limit. It resets [day] at [time]」。一部プランにはモデル専用の追加週次上限もある。
usage credits有効時の表示変化
有料プランで使用設定から有効にすると、上限に当たっても止まらず従量課金へ切り替わり「...continuing with usage credits」と表示。ただし月間の支出上限かクレジット残高まで。自動補充オフなら残高が天井。
メッセージが長すぎるときのエラー
「Your message will exceed the length limit for this chat」は障害ではない。内容を分割、要約してから送る、要点を抽出させて新しいチャットを始める。コード実行が有効な有料プランでは長い会話は自動要約され、要約後も履歴は保持される。
「Due to unexpected capacity constraints」は障害なのか
室谷代表取締役これ、一番相談が来るやつなんですよね。ステータスページは緑なのに返信が来なくて、「Due to unexpected capacity constraints」って出る。
あれを見て障害だと思う人は多いですけど・・・
あれを見て障害だと思う人は多いですけど・・・
テキトー教師DotAI 認定講師現場でも「壊れてるんですか」って聞かれる定番なんですよ。でも公式ヘルプは、これは障害ではないと明記してます。
システムは正常に動いていて、全利用者からの高需要を調整している一時的な状態だと。
システムは正常に動いていて、全利用者からの高需要を調整している一時的な状態だと。
室谷代表取締役つまり自分だけ弾かれてるわけでも、ましてや障害でもなくて、需要の山に当たっただけなんですよね。しかもこれ、ステータスページには表示されない。
技術的な問題ではなく通常の負荷管理だから、という理由まで書かれてます。
技術的な問題ではなく通常の負荷管理だから、という理由まで書かれてます。
テキトー教師DotAI 認定講師そうなんです。だから緑を見て「異常なし」と判断するのは半分正解で、そもそも載らない種類の不調があると知っておくのが大事なんですよね。
数分置いて送り直すのが基本です。
数分置いて送り直すのが基本です。
5-hour limit reached・weekly limitが出るときの仕組み
室谷代表取締役もう一つの定番が利用上限です。これは障害でも容量制約でもなくて、プラン側の設計なんですよ。
5時間ごとのセッション上限と、週次の上限がある。
5時間ごとのセッション上限と、週次の上限がある。
テキトー教師DotAI 認定講師最初に戸惑うのが、上限に近づくと「Approaching session limit」って使用割合つきで出るんですよね。数字が見えると安心する人が多いんです。
到達したときの文言は「5-hour limit reached - resets [time]」、週次のほうは「You've reached your weekly limit. It resets [day] at [time]」になります。
到達したときの文言は「5-hour limit reached - resets [time]」、週次のほうは「You've reached your weekly limit. It resets [day] at [time]」になります。
室谷代表取締役経営目線で言うと、これって止まる時間を見積もれるかどうかが全てなんですよ。リセット時刻が明示されるなら、その間にレビューや設計へ切り替えれば損失はほぼゼロ。
逆にここを理解していないと、チーム全員が画面の前で待つという一番高い時間の使い方になる。
逆にここを理解していないと、チーム全員が画面の前で待つという一番高い時間の使い方になる。
テキトー教師DotAI 認定講師たしかに。あと一部のプランだとモデル専用の追加週次上限もあって、同じ週次でも種類が違うんですよね。
表示された文言をそのまま読むのが確実です。
表示された文言をそのまま読むのが確実です。
usage creditsを有効にしている場合の表示の変化
室谷代表取締役有料プランだと、使用設定からusage creditsを有効にできるんですよね。それをオンにしてると、上限に当たっても止まらずに従量課金へ切り替わって続けられる。
テキトー教師DotAI 認定講師そうすると表示も変わるんですよ。上限到達の文言ではなく、「...continuing with usage credits」のような形になる。
止まっていないので見た目は地味なんですけど、意味は大きいです。
止まっていないので見た目は地味なんですけど、意味は大きいです。
室谷代表取締役ただ無制限ではなくて、月間の支出上限か、クレジット残高までです。自動補充をオフにしていると残高がそのまま天井になる。
設定したつもりが逆に使いすぎていた、という事故が起きるのはここなので、金額の設計は先に決めておいたほうがいいです。
設定したつもりが逆に使いすぎていた、という事故が起きるのはここなので、金額の設計は先に決めておいたほうがいいです。
テキトー教師DotAI 認定講師現場感覚だと、オンにする前に「いくらまでなら許容か」を決めておくのが結局一番効くんですよね。あとから数字を見て驚くパターンが本当に多いので。
メッセージが長すぎるときのエラーと対処
室谷代表取締役あとは長いチャットですね。「Your message will exceed the length limit for this chat」って出るやつ。
これも障害ではないです。
これも障害ではないです。
テキトー教師DotAI 認定講師対処はシンプルで、内容を分割するか、要約してから送るか、要点を抽出させてから新しいチャットを始める。そもそもコード実行が有効な有料プランだと長い会話は自動で要約されるので通常は起きにくいんですよね。
要約後も履歴は保持されます。
要約後も履歴は保持されます。
室谷代表取締役ログイン周りも忘れられがちで。「There was an error logging you in」が出たら、VPNを切って、ブラウザ拡張を無効化して、キャッシュとCookieを消す。
それでも直らなければステータスページを見る、という順番です。
それでも直らなければステータスページを見る、という順番です。
テキトー教師DotAI 認定講師この順番、地味に大事なんですよ。いきなり障害を疑って待つより、手元で直せるものを先に潰したほうが早いことが多いので。
過去にどんな障害が起きて、復旧までどれくらいかかったのか
インシデントはInvestigatingからResolvedへどう進むのか
室谷代表取締役ステータスページの更新、フェーズの順番が決まってるんですよね。まずInvestigatingで調査中、次にIdentifiedで原因を特定、Monitoringで復旧作業を見守って、最後がResolved。
稀にPostmortemが付くこともあります。
稀にPostmortemが付くこともあります。
テキトー教師DotAI 認定講師初めて触る人はこの並びを見て「まだ直ってないの」って焦るんですよね。ただIdentifiedまで来ていれば原因は掴めている段階なので、そこで慌てて環境を作り替える必要はないんです。
室谷代表取締役経営の立場で言うと、このフェーズ名は判断材料としてかなり使えるんですよ。Investigatingのままなら代替手段を先に用意する、Monitoringまで来ていれば数十分で戻ると見て他のタスクを回す、みたいな判断ができます。
テキトー教師DotAI 認定講師フェーズを読めるだけで、その間の動き方って変わるんですよね。
2026年秋に起きた主な障害と復旧までの時間
2026年秋に起きた主な障害と復旧までの時間
- 9月29日 14:21〜16:27大規模障害(約2時間6分)claude.ai・Claude Code・Cowork・APIが巻き込まれる。SSOやSign in with Appleのログイン不可、新規チャット・音声会話・Code/Coworkのセッション開始・購入・ファイルアップロードが失敗
- 10月5日 12:40〜13:10ごろ障害(30分程度)影響時間は30分程度
- 10月6日 12:24〜12:43一部リクエストでエラー増加(19分)19分ほどで復旧
室谷代表取締役実際の記録を見ると、10月6日の午後に一部リクエストでエラーが増えた件は、12:24から12:43までで19分ほど。前日の10月5日も、影響は12:40から13:10ごろで30分程度なんですよね。
テキトー教師DotAI 認定講師短いですよね。1時間を超えるケースの方が珍しい部類なんです。
現場でよく聞くのは「丸一日止まった」みたいな体感なんですけど、記録に残っているのは分単位から数時間単位なんですよ。
現場でよく聞くのは「丸一日止まった」みたいな体感なんですけど、記録に残っているのは分単位から数時間単位なんですよ。
室谷代表取締役一番大きかったのは9月29日で、14:21から16:27、およそ2時間6分。claude.aiもClaude CodeもCoworkもAPIも巻き込まれています。
それでも半日は止まっていない。
それでも半日は止まっていない。
テキトー教師DotAI 認定講師体感とログはけっこうズレるんですよね。ここを取り違えると、復旧後に意味のない環境変更をしてしまうんですよ。
大規模障害では具体的に何ができなくなるのか
室谷代表取締役9月29日のケースだと、途中でSSOやSign in with Appleでのログインが通らなくなって、新規チャットも音声会話も始められない。CodeやCoworkのセッション開始も、購入やファイルアップロードも失敗しています。
テキトー教師DotAI 認定講師ログインが死ぬともう何も始められないので、そこが一番痛いんですよね。エラー画面を見て自分の設定を疑い始める人が出るのも、だいたいこのパターンです。
室谷代表取締役別の日に出た支出上限の誤判定も同じで、組織が上限を超えたと誤って判定されて、APIやclaude.ai、Claude Codeまでリクエストが拒否された。原因がステータス側にあるのに、こちらの請求設定を疑って触りたくなるやつです。
テキトー教師DotAI 認定講師そういうときほど設定は触らない方がいいんですよ。まずステータスを見る。
これに尽きます。
これに尽きます。
障害と復旧の通知はどう受け取ればいい?
ページの「Subscribe to Updates」から通知を受け取る
- https://status.claude.com/ を開く
- ページ内の「Subscribe to Updates」を押す
- 通知先(メールアドレスなど)を入力して登録する
- 届いた確認メールのリンクを開いて有効化する
ボタンの位置や文言は変わることがあるので、実際の表示に従ってください。
室谷代表取締役障害に気づくのが一番遅れるパターンって、ユーザーからの問い合わせなんですよね。こっちが把握する前に社内のチャットが荒れてる状態で・・・
テキトー教師DotAI 認定講師たしかに。人手でページを見に行く運用だと、見に行ったタイミングでしか気づけないんですよ。
最初に戸惑うのが、通知の登録場所そのものですけどね。
最初に戸惑うのが、通知の登録場所そのものですけどね。
室谷代表取締役ここは一度登録すれば終わりなので、かかる手間はほぼゼロなんですよ。運用に組み込まない理由がないんですよね。
テキトー教師DotAI 認定講師そうですね。登録さえ済ませておけば、あとは受け身で拾えますから。
ステータスはAPIからも取れる
テキトー教師DotAI 認定講師実は、このページ自体にプログラムからアクセスする入り口があるんですよ。ページ内の status.claude.com/api です。
初めて触る人はまずここで止まります。
初めて触る人はまずここで止まります。
室谷代表取締役それ、気づいてない人かなり多いですよね。Atlassian Statuspage の基盤なので状態が JSON で返ってくる。
監視側にそのまま食わせられるんですよ。
監視側にそのまま食わせられるんですよ。
テキトー教師DotAI 認定講師現場感覚で言うと、「ページを開いて目視」から「スクリプトが拾ってチャットに投げる」に変わるだけで、当番の負担がまるで違います。たとえば /api/v2/status.json なら indicator が none / minor / major / critical で返るので、そのまま条件分岐に使えます。
室谷代表取締役MYUUU でも一次受けは自動に寄せていて、判断は人がやる。気づくところだけ機械に任せる、という切り分けなんですよね。
どのエンドポイントを何に使うか
テキトー教師DotAI 認定講師使うなら、ざっくりこういう住み分けになります。
| エンドポイント | 何が分かるか | 向いている用途 |
|---|---|---|
| /api/v2/status.json | 全体の indicator(none / minor / major / critical) | ざっくりした死活監視 |
| /api/v2/summary.json | 全体の要約 | ダッシュボード表示 |
| /api/v2/components.json | コンポーネントごとの状態 | 「Claude Code だけ落ちている」の判定 |
| /api/v2/incidents/unresolved.json | 未解決のインシデント | アラート通知の起点 |
| /api/v2/incidents.json | 直近50件のインシデント | 振り返り・レポート |
| /api/v2/scheduled-maintenances/upcoming.json | 予定されているメンテナンス | 事前の周知 |
室谷代表取締役未解決の一覧をアラートの起点にするのは筋がいいですね。解決した瞬間に通知を引っ込める、みたいな制御もできる。
テキトー教師DotAI 認定講師その通りで、全部を一つのエンドポイントで見ようとするとノイズが増えるんですよ。用途ごとに分けた方が運用はラクです。
室谷代表取締役あと、通知は飛ばすだけだと誰も見なくなるんですよね。当番とセットで決めておかないと、仕組みを作ったところで終わってしまう。
Claude APIの429や529は何を意味する?
400・401・402・403・404・409・413が示すもの
室谷代表取締役400番台のうち、まず400はリクエストの形式そのものが合っていないときですね。あと組織やワークスペースの支出上限を超えたときも400が返るんですよ。
ただClaude Codeのワークスペース上限だけは429になる、この非対称が地味に厄介で・・・
ただClaude Codeのワークスペース上限だけは429になる、この非対称が地味に厄介で・・・
テキトー教師DotAI 認定講師そこ、最初に戸惑うのがエラー番号だけを見て判断しちゃうところなんですよね。401はキーが無効か失効、402は請求まわり、403は権限、404は対象が見つからない、409は競合、413はサイズ超過です。
413はMessages APIやToken Counting API、Batch API、Files APIで上限がそれぞれ違いますから、まず何を送ったかを見たほうが早いです。
413はMessages APIやToken Counting API、Batch API、Files APIで上限がそれぞれ違いますから、まず何を送ったかを見たほうが早いです。
室谷代表取締役401はAWS経由で使っているとAWS側の認証情報が原因のこともあるので、APIキーだけ疑うとハマるんですよね。
テキトー教師DotAI 認定講師そうなんです。番号は「どこを直すか」の当たり付けであって、原因の断定はログを見てからでいいと思います。
429 rate_limit_errorが示す2つの状況とretry-afterの有無
室谷代表取締役429は2パターンあって、短時間のレート制限なら待てば戻るんですけど、利用ティアの月間支出上限に当たった場合はretry-afterが付かないんですよ。ヘッダー無しの429が返ってきたら、待つのではなく上限側を見に行くべきで・・・
テキトー教師DotAI 認定講師ここを混同すると「何回リトライしても直らない」で詰まるんですよね。retry-afterがあるかどうかが、待つべきか設定を変えるべきかの分岐点になります。
室谷代表取締役Claude Codeのワークスペース上限も429で来るので、番号だけでは原因を切り分けられないんですよ。どのキーで、どのワークスペースか、まで見る必要がある。
テキトー教師DotAI 認定講師たしかに。429=混雑、と覚えちゃうと支出上限を見落とすんですよ。
500・504・529——5xx系の正しい対応
室谷代表取締役500はAnthropic内部の予期しないエラーで、指数バックオフで再試行。それでも続くならrequest_idを添えてサポートに投げる流れですね。
504はタイムアウトなので、長い処理ならストリーミングに切り替える検討をします。
504はタイムアウトなので、長い処理ならストリーミングに切り替える検討をします。
テキトー教師DotAI 認定講師529は全利用者的な高負荷のときに返るやつで、500や504と並べると性質がだいぶ違うんですよね。あと503は公式の一覧に載っていないので、503を見たからといって独自に解釈しないほうがいいです。
5xx系は500・504・529の3つで読む、と。
5xx系は500・504・529の3つで読む、と。
室谷代表取締役ここ、経営目線だと「再試行で吸収できるエラー」と「人が動かないと直らないエラー」を分けておくのが効くんですよ。前者は仕組みで握りつぶして、後者だけ通知する。
テキトー教師DotAI 認定講師現場でも、全部アラートに上げていると誰も見なくなりますからね。分け方は重要です。
request_idの控え方とSDKの自動リトライ
室谷代表取締役エラー応答はJSONで、typeとmessageを持つerrorオブジェクトとrequest_idが返るんですよ。全レスポンスにrequest-idヘッダーが付くので、問い合わせのときはこれを控えておけば話が早い。
テキトー教師DotAI 認定講師AWS経由だとAWS側のIDとAnthropic側のIDの2種類が返るので、両方控えておくと安心なんですよね。
室谷代表取締役あとSDKは接続エラーとレート制限、5xxを既定で2回まで指数バックオフで再試行するんですよ。retry-afterを尊重して動くので、自前でリトライを重ねると二重にかかる。
max_retriesで調整はできますけど、そこは把握しておいたほうがいい。
max_retriesで調整はできますけど、そこは把握しておいたほうがいい。
テキトー教師DotAI 認定講師最初に知っておくと、ログの見え方が変わりますね。
Claude Codeだけが不調なときは何を疑う?
Claude Codeの不調は/doctorで切り分ける
室谷代表取締役Claude Codeだけ動かない、っていう相談が一番多いんですよね。でもこれ、アカウント全体の障害なのか、自分の環境なのかで、やることが真逆になるんですよ。
テキトー教師DotAI 認定講師たしかに。現場でよく聞くのは、切り分けをしないままアプリを入れ直しちゃうパターンですね。
まずはClaude Codeの中で /doctor を打って、環境まわりを確認するのが入口です。
まずはClaude Codeの中で /doctor を打って、環境まわりを確認するのが入口です。
室谷代表取締役ステータスページでClaude CodeがOperational、もしくは何も出ていないなら、自分の側を疑う。ここを分けずにサポートに投げると、往復で半日溶けるんですよね。
チームで使ってる場合は、その半日が人数分効いてきますし。
チームで使ってる場合は、その半日が人数分効いてきますし。
テキトー教師DotAI 認定講師ターミナルの表示まわりまで詰めたい人は、Claude Code StatuslineとStatus Barの完全ガイドが参考になります。表示を整えておくと、どこで止まっているかも見えやすくなるんですよ。
Claude Codeワークスペースの支出上限で止まるとき
室谷代表取締役これ、地味に一番ハマるやつなんですよ。Claude Codeのワークスペース側に支出上限が設定されていて、それが効くとClaude Codeだけ止まる。
アカウント全体は無事なんです。
アカウント全体は無事なんです。
テキトー教師DotAI 認定講師一番混乱するのが「有料プランを使っているのに急に止まった」というケースですね。公式のエラー一覧だと、Claude Codeのワークスペース上限に達したときは429で返る、と説明されています。
室谷代表取締役組織やワークスペースの支出上限超過は基本400で返るのに、Claude Codeのワークスペースだけ429になる。ここが切り分けの目印なんですよね。
しかもティアの支出上限による429はretry-afterが付かないので、待っても復旧しない。
しかもティアの支出上限による429はretry-afterが付かないので、待っても復旧しない。
テキトー教師DotAI 認定講師ステータスページに何も出ていないのに組織単位で止まる、という障害も過去にありました。そういうときはConsole側の上限設定とクレジット残高を先に見るのが早いですね。
セッションが始まらない・ファイルが上がらないとき
- 表示されたメッセージを確認する(セッション上限か、長さの上限か、それ以外か)
- セッション上限ならリセット時刻を待つ。使用クレジットを有効にしている有料プランなら、従量課金でそのまま続けられる
- ファイルが原因なら、ファイルを減らす・小さくする、要点を抽出してから送る、新しいチャットを始める
- どれも当てはまらないなら、ステータスページでClaude Codeの状態を確認する
テキトー教師DotAI 認定講師セッションが始まらない、という相談はだいたいこの2つに割れます。プランの上限か、入力の問題か。
室谷代表取締役上限のほうは、5時間ごとのセッション上限と週次上限があって、到達するとリセット時刻つきのメッセージが出る。これは障害じゃないので、ステータスページを見ても何も出ていないんですよね。
テキトー教師DotAI 認定講師ファイルが上がらないときは、サイズや会話の長さが原因のことが多いです。長さの上限メッセージが出たら、分割するか新しいチャットに移る。
履歴は要約後も残るので、そこは心配しなくて大丈夫です。
履歴は要約後も残るので、そこは心配しなくて大丈夫です。
室谷代表取締役自分の側かサービスの側かで、待つのか直すのかが真逆になる。ここを見分けられるかどうかが、止まっている時間の差になるんですよ。
障害中でも仕事を止めないために、何を決めておく?
個人が障害中に使える代替の動かし方
室谷代表取締役障害が起きたとき一番もったいないのは、みんなが画面の前で待つことなんですよね。組織で見ると、待ち時間がそのまま人件費になってる。
テキトー教師DotAI 認定講師たしかに。最初に触る人は「再読み込みすれば直るかも」で延々リロードしがちです。
現場でよく聞くのは「気づいたら30分経ってた」パターンですね。
現場でよく聞くのは「気づいたら30分経ってた」パターンですね。
室谷代表取締役なので、判断を自分の目に頼らないのが先なんですよ。公式のステータス API を叩けば、全体の要約や各コンポーネントの状態をプログラムで取れる。
監視に入れておけば、人が見に行かなくても切り替えの合図になります。
監視に入れておけば、人が見に行かなくても切り替えの合図になります。
テキトー教師DotAI 認定講師あと地味に効くのが、Claude が止まっても進む作業を先に消化することですね。テストの書き直しとか設計の見直しとか。
ターミナル側の表示を普段から整えておくと異変にも早く気づけるので、StatuslineとStatus Barの完全ガイドあたりを一度眺めておくと備えになります。
ターミナル側の表示を普段から整えておくと異変にも早く気づけるので、StatuslineとStatus Barの完全ガイドあたりを一度眺めておくと備えになります。
チームで決めておきたい障害時のルール
テキトー教師DotAI 認定講師チームだと、個人の判断に任せないほうがいいんですよね。「誰がステータスを見るか」を決めておくだけで、報告の重複が減ります。
室谷代表取締役これ、意外と経営の話で。障害対応って属人化すると、その人が休みの日に一気に崩れるんですよ。
当番と一次連絡先を決めて、切り替えの閾値も文章にしておく。で、顧客に出す説明を書く担当まで決めておくと初動が全然違います。
当番と一次連絡先を決めて、切り替えの閾値も文章にしておく。で、顧客に出す説明を書く担当まで決めておくと初動が全然違います。
テキトー教師DotAI 認定講師閾値のところ、現場では「使えない状態が続いたら切り替える」みたいに時間で決めちゃうのが楽ですね。あと API を業務で使っているなら、失敗したリクエストの ID を集める係を先に決めておくと、後で問い合わせるときに詰まりません。
室谷代表取締役それ大事なんですよね。後から ID を探す作業って、時給で換算するとかなり高い。
止まってから慌てないための運用を先に決めておくのは、コスト削減というより保険です。
止まってから慌てないための運用を先に決めておくのは、コスト削減というより保険です。
公式サポートへの問い合わせ方とrequest_idの残し方
エラーが出たら、まずこれを順番に残します。
- エラー応答の JSON に入っている
request_idをコピーする(req_から始まる文字列) - レスポンスヘッダーの
request-idも控える - AWS 経由で使っている場合は、AWS 側の
x-amzn-requestidと Anthropic 側のrequest-idの2つを残す - エラーが出た時刻と、画面に出ていた文言をそのまま記録する
- status.claude.com で障害が告知されていれば、そのインシデント名も添える
室谷代表取締役問い合わせの窓口、電話もライブチャットも無いんですよね。サポートメッセンジャーとメールだけで、最初は AI の Fin が受けて、必要なら人が引き継ぐ流れです。
テキトー教師DotAI 認定講師なので、最初から要点をまとめて渡すのが効率的です。「いつ・何をして・どんなエラーが出て・request_id はこれ」の4点セット。
これが無いと往復が増えるだけなんですよ。
これが無いと往復が増えるだけなんですよ。
室谷代表取締役Pro・Max・Team のオーナーや Console の管理者は人による対応まで届くし、Enterprise には優先パスもある。契約形態で到達点が変わるので、そこは組織として把握しておきたいところです。
テキトー教師DotAI 認定講師ただ、どのプランでも「まずステータスページを見て」が公式の案内なんですよね。障害として出ていればそれを超える情報は無いので、待つと決めるラインも一緒に決めておくといいです。
よくある質問
Q1. 複数のAIサービスが同時に使えないときは、何を疑えばいい?
テキトー教師DotAI 認定講師現場でよく聞くのがこのパターンなんですよ。1つだけなら、そのサービスの障害を疑えばいいんですが、同時に複数がダメなら手元を先に見た方が早いです。
室谷代表取締役そうなんですよね。社内で一斉に「AIが使えない」って声が出たとき、まず疑うのは回線とかプロキシとか、その辺なんですよ。
ツールの障害だと思い込んで調べる時間が一番もったいない。
ツールの障害だと思い込んで調べる時間が一番もったいない。
テキトー教師DotAI 認定講師切り分けは、スマホの回線で開いてみるだけで一気に進みます。そこで見えたら自分の環境、見えなかったらサービス側。
順番としてはこれが一番速いです。
順番としてはこれが一番速いです。
Q2. ログインできないのは障害ですか?アカウントの問題ですか?
テキトー教師DotAI 認定講師最初に戸惑うのがここなんですよね。パスワードで弾かれるのか、認証は通ったのに画面が先へ進まないのかで、見る場所が変わります。
室谷代表取締役認証が通ってるならサービス側、通らないなら手元かアカウント側。あと、支払い方法の期限が切れていて止まっていた、みたいな地味な理由も普通にあります。
テキトー教師DotAI 認定講師何度も連続で試すより、一度離れてステータスを見に行く方が結果的に早いです。ログイン画面とにらめっこしても情報は増えないので。
Q3. ステータスページが重くて開けないときは、どうすればいい?
室谷代表取締役あれ、本体が不調のときは一緒に重くなるんですよね。みんなが一斉にアクセスしますから。
テキトー教師DotAI 認定講師たしかに。そういうときは数分置いて再読み込みするくらいで、連打しない方がいいです。
開けないこと自体は、異常の判断材料にはならないので。
開けないこと自体は、異常の判断材料にはならないので。
室谷代表取締役むしろ「開けない=何か起きてる」くらいの温度感で受け取って、別の作業に切り替えるのが現実的です。そこで待っても状況は変わらないので。
Q4. アプリでは使えないのにブラウザでは動きます。これも障害ですか?
テキトー教師DotAI 認定講師それはだいたい手元側ですね。アプリの更新が止まっていたり、端末側で通信が制限されていたり。
理由は環境によって変わるので、まず再起動と更新を試すのが定番です。
理由は環境によって変わるので、まず再起動と更新を試すのが定番です。
室谷代表取締役あと、ブラウザで動いてるならサービス自体は生きてるわけですから、そこで障害を疑っても話が進まないんですよ。見る場所が違うんですよね。
テキトー教師DotAI 認定講師逆にアプリもブラウザも両方ダメなら、素直にステータスを見る。この分け方だけ覚えておけば迷いません。
Q5. 有料プランで使えない時間があった場合、補償はありますか?
テキトー教師DotAI 認定講師これは現場でもよく出る質問です。ただ、条件は状況によって変わるので、判断はサポートに確認するのが確実です。
室谷代表取締役経営の立場で言うと、数時間止まった分を補償で取り返すより、止まったときに別の手段へ切り替えられる状態を作る方がリターンが大きいんですよね。損失は時間の方に寄るので。
テキトー教師DotAI 認定講師たしかに。補償の有無を調べる時間より、切り替え先を1つ決めておく方が、次の障害で効いてきます。
まとめ
室谷代表取締役結局、Claudeが使えないときに差が出るのは疑う順番なんですよ。手元の環境、ステータスページ、APIのエラーコード。
この順で見れば、たいてい数分で当たりがつきます。
この順で見れば、たいてい数分で当たりがつきます。
テキトー教師DotAI 認定講師切り分けが早い人は、たぶんこの順番が体に入ってるだけなんですよね。特別な知識じゃなくて、見る場所の順番なんです。
室谷代表取締役あと、障害そのものより痛いのは、止まったときに何で代わりを打つかを決めてないことなんですよ。うちはそこを先に決めてます。
テキトー教師DotAI 認定講師最初のうちは、ステータスページをブックマークしておくだけでも十分だと思います。慌てて検索する時間が減るだけで、体感はだいぶ変わりますから。
室谷代表取締役落ちてから調べるんじゃなくて、落ちる前提で1つ決めておく。それが一番安い保険なんですよね。