DeepSeek-OCRとは何ができるモデル?何を読み取れるのか
文書・図表・画像をテキストに変換するOCRモデル
 室谷代表取締役
DeepSeek-OCR、ひと言でいうと画像の中の文字や図表をテキストに落とすモデルなんですよね。出力がMarkdownで返ってくるので、社内に溜まったPDF資産をそのまま機械可読な形に持っていける。
 テキトー教師DotAI 認定講師
現場でよく聞くのが「スキャンしたPDFの山をどうにかしたい」という相談です。手で写し直すしかないと思われてるものが、実はかなり多いんですよ。
室谷代表取締役しかも図表も対象なんですよ。表の構造を保ったままテキスト化できるなら、RAGの前処理の設計が根本から変わりますから。
テキトー教師DotAI 認定講師たしかに。文字だけ抜けても表が崩れたら使い物にならないので、そこを見てくれるのは大きいですね。
3BパラメータのMoE構成と公開されている場所
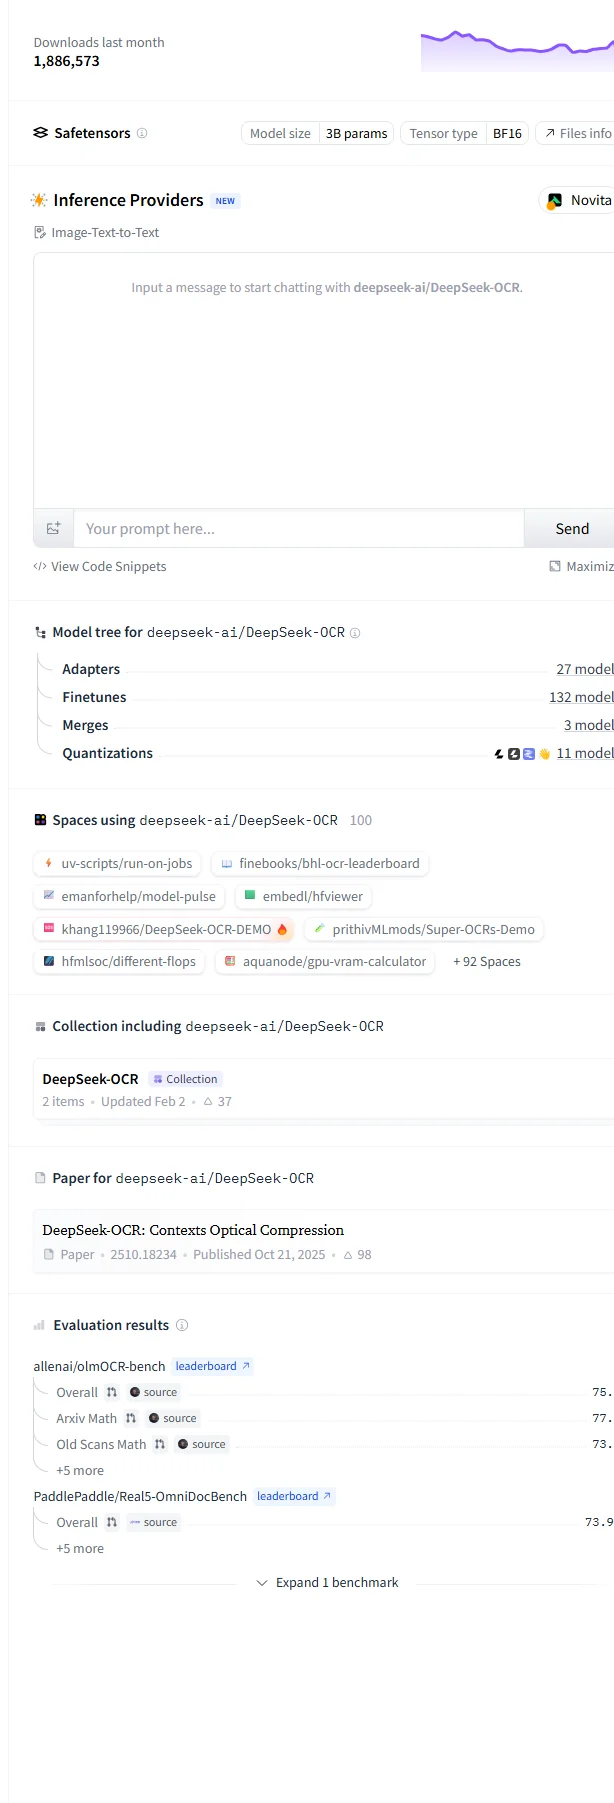
室谷代表取締役中身は3Bパラメータで、デコーダがDeepSeek3B-MoE-A570M。実際に動くのは約570Mの活性パラメータという構成なんですよね。
テキトー教師DotAI 認定講師3Bと聞くと身構えますけど、MoEで使う部分が絞られてるなら試すハードルは下がりますね。
室谷代表取締役重みはHugging Face、コードはGitHub、論文はarXivで公開されてます。ライセンスはMITなので商用利用も改変も再配布も可能。
導入判断のコストって、ここで全然変わってくるんですよ。検証の初速が出るかどうかが一番効きますから。
導入判断のコストって、ここで全然変わってくるんですよ。検証の初速が出るかどうかが一番効きますから。
テキトー教師DotAI 認定講師黒箱でAPIだけ触らされるのとは違いますね。中で何をやってるか追える状態なのは、教育の場でも安心材料になります。
普通のOCRと何が違うのか
室谷代表取締役普通のOCRとの違い、ここが一番聞かれるところで。従来は文字の位置を検出して1文字ずつ読む。
こちらは画像全体をエンコーダに通して、文章として復元する作りになってる。
こちらは画像全体をエンコーダに通して、文章として復元する作りになってる。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこです。「OCRは文字を読むものでしょ」という前提だと、表の構造まで返ってくる挙動が不思議に見えるみたいで。
室谷代表取締役エンコーダはSAMとCLIPを組み合わせて、間に16倍の畳み込み圧縮層を挟む構成なんですよ。局所を細かく見る役と、全体を俯瞰する役を分けてるわけですね。
テキトー教師DotAI 認定講師なるほど。だから崩れたレイアウトでも文脈で補えるんですね。
どこまで信用して人の目を入れるかは、現場ごとの線引きになりそうです。
どこまで信用して人の目を入れるかは、現場ごとの線引きになりそうです。
光学的コンテキスト圧縮とは?トークン削減のカラクリ
長い文脈を画像として畳んでから戻す発想
圧縮率と復号精度のトレードオフ
10倍以内
- 復号精度は約97%
- 安心して投げられる書式
- 実務の判断材料になる境目
20倍
- 復号精度は約60%まで低下
- 「読めたら儲けもの」の領域
室谷代表取締役このモデルの核って、論文のタイトルにもなってる「Contexts Optical Compression」なんですよね。長いテキストの文脈を文字のまま読むんじゃなくて、画像として二次元に畳んで、少ないビジョントークンで運んでから戻す、という発想で。
テキトー教師DotAI 認定講師そこが最初に戸惑うところで。「OCRなのに圧縮とは?」となりやすいんですよ。
1ページを1文字ずつ数えるのではなく、紙面ごと写真として受け取って、要る情報だけ取り出すイメージですね。
1ページを1文字ずつ数えるのではなく、紙面ごと写真として受け取って、要る情報だけ取り出すイメージですね。
室谷代表取締役そうなんですよ。論文では圧縮率と精度のトレードオフが数字で出ていて、テキストのトークン数がビジョントークンの10倍以内なら復号精度は約97%、20倍まで攻めると約60%まで落ちる、と。
| 圧縮率 | 復号精度の目安 |
|---|---|
| 10倍以内 | 約97% |
| 20倍 | 約60% |
テキトー教師DotAI 認定講師この境目が実務の判断材料になりますね。10倍以内に収まる書式なら安心して投げられる、20倍は「読めたら儲けもの」の領域だと。
DeepEncoderはSAMとCLIPを組み合わせた二段構え
室谷代表取締役畳む役目を担うのがDeepEncoderです。ここが地味に面白くて、SAMとCLIPの組み合わせなんですよね。
SAM側がウィンドウアテンションで局所を見て、CLIP側が密なアテンションで全体を掴む。役割がはっきり分かれてる。
SAM側がウィンドウアテンションで局所を見て、CLIP側が密なアテンションで全体を掴む。役割がはっきり分かれてる。
テキトー教師DotAI 認定講師現場感覚で言うと、人間の読み方に近いんですよ。行の中の細かい字を追う目と、ページ全体のレイアウトを把握する目を同時に使ってる。
片方だけだと、表組みのある帳票で崩れやすいんですよね。
片方だけだと、表組みのある帳票で崩れやすいんですよね。
室谷代表取締役さらに間に16倍の畳み込み圧縮層を挟んで、ビジョントークン数を落とす構造になってる、と。ここで削ってるから後段のコストが効いてくるわけです。
テキトー教師DotAI 認定講師削る場所をエンコーダ側に置いてるのが、設計の意思を感じますね。
デコーダ側のMoEと活性パラメータの考え方
室谷代表取締役デコーダはDeepSeek3B-MoE-A570Mで、活性パラメータは約570M。全体は3Bだけど、推論時に実際に動くのは一部、という作りなんですよね。
テキトー教師DotAI 認定講師そこ、初めて触る人がよく混同するんですよ。3Bという数字だけ見て「重いな」と判断しちゃう。
動くのが570M相当なら、必要になる計算資源の見積もりは変わってきますから。
動くのが570M相当なら、必要になる計算資源の見積もりは変わってきますから。
室谷代表取締役経営目線で言うと、まさにそこが導入判断の分かれ目で。同じ精度なら動かすパラメータが少ない方がGPU時間は短くて済む。
A100-40G一台で1日20万ページ超の学習データ生成ができる、という数字も、その延長で読むと重みが変わってきます。
A100-40G一台で1日20万ページ超の学習データ生成ができる、という数字も、その延長で読むと重みが変わってきます。
テキトー教師DotAI 認定講師ページ単価で捉えると分かりやすいですね。1枚あたりが下がるなら、社内文書をまとめて流し込むような使い方が現実味を帯びてくる。
インストール手順は?Python・CUDA・vLLMの環境構築
前提になるCUDAとPythonのバージョン
室谷代表取締役環境構築の話は、公式が動作確認した組み合わせを先に押さえるのが一番速いんですよね。CUDA 11.8 + torch 2.6.0、Python は 3.12.9。
ここから外れると、だいたいどこかで詰まります。
ここから外れると、だいたいどこかで詰まります。
テキトー教師DotAI 認定講師現場でよく聞くのは「手元のCUDAが12系なんですけど、そのままでいいですか」という相談です。公式が確認しているのが11.8なので、まずそこを基準に組んで、違う場合は自己責任でずらす感覚が安全ですね。
室谷代表取締役あとこのモデル、bfloat16前提でNVIDIA GPUが要る構成なんですよ。GPU1枚を何で埋めるかって話になるので、環境を組み始める前にそこは決めておきたいところです。
vLLMを使うルートとTransformersを使うルート
Python・CUDA・vLLM 環境構築の共通手順
- 01リポジトリをclonegit clone https://github.com/deepseek-ai/DeepSeek-OCR.git
- 02conda環境を作成Python 3.12.9
- 03PyTorchをインストールtorch==2.6.0 / torchvision==0.21.0 / torchaudio==2.6.0 をcu118向けに
- 04vLLMをインストールvLLM 0.8.5のwhl、または2025年10月23日以降はアップストリームvLLMのnightly build(v0.11.1リリースまではnightlyが必要)
- 05requirements.txtをインストール
- 06flash-attnをインストールflash-attn==2.7.3
室谷代表取締役共通部分の手順はこんな流れです。
git clone https://github.com/deepseek-ai/DeepSeek-OCR.git- Python 3.12.9 の conda 環境を作成
- torch==2.6.0 / torchvision==0.21.0 / torchaudio==2.6.0 を cu118 向けにインストール
- vLLM 0.8.5 の whl、または 2025年10月23日以降はアップストリーム vLLM の nightly build(v0.11.1 リリースまでは nightly が必要)
- requirements.txt をインストール
- flash-attn==2.7.3 をインストール
テキトー教師DotAI 認定講師ここで分岐があって、vLLMはサーバとして立ててAPIで叩く、TransformersはPythonスクリプトから直接呼ぶ。初めて触る人はこの住み分けが分からず止まりがちなんですよ。
室谷代表取締役ページ数を大量に流す前提なら、vLLMでサーバを立てておく方が後で楽なんですよね。A100-40Gでのバッチ推論だとPDF処理で約2500トークン/秒という数字が公式に出てます。
単発のお試しならTransformersで十分ですけど。
単発のお試しならTransformersで十分ですけど。
テキトー教師DotAI 認定講師Transformers側はパッケージが別で、transformers==4.46.3、tokenizers==0.20.3、einops、addict、easydict、それと flash-attn==2.7.3 です。こっちの方が依存が少なくて見通しはいいですね。
つまずきやすいポイントと確認方法
テキトー教師DotAI 認定講師最初に戸惑うのが flash-attn のところで、ビルドに時間がかかって「止まったのかな」と思う人が多いんですよ。バージョンは2.7.3と決まっているので、そこは動かさない方が無難です。
室谷代表取締役vLLMも0.8.5のwhlかnightlyかで迷うところですけど、これは時期によって案内が変わってる部分なので、リポジトリのREADMEの最新を見るのが確実なんですよね。
テキトー教師DotAI 認定講師確認方法としては、torchがCUDAを掴めているかを先に見て、そのうえでREADMEの手順と突き合わせる順番がおすすめです。bfloat16前提なのでGPU側の対応も忘れずに、というところですね。
室谷代表取締役環境で詰まったら、コードを疑う前に構成を疑う。地味ですけどこれに尽きます。
実際の使い方は?推論コードとプロンプトの使い分け
モデルを読み込んで推論するまでの流れ
室谷代表取締役で、実際に動かすところなんですけど、Transformers なら AutoModel.from_pretrained で 'deepseek-ai/DeepSeek-OCR' を指定して、trust_remote_code を True、attention は flash_attention_2、bfloat16 で cuda に載せる、という流れなんですよね。
テキトー教師DotAI 認定講師はい。ここで最初に戸惑うのが trust_remote_code だと思うんですよ。
「自分の環境でコード走らせるの?」と身構える人が多くて。公式実装をそのまま使う前提の指定だと伝えると納得してもらえます。
「自分の環境でコード走らせるの?」と身構える人が多くて。公式実装をそのまま使う前提の指定だと伝えると納得してもらえます。
室谷代表取締役読み込んだあとは model.infer() を呼ぶだけで、tokenizer、prompt、image_file、output_path あたりを渡せば結果が出てくる。base_size や image_size、crop_mode もここで渡す形です。
save_results を True にしておけば出力が残ります。
save_results を True にしておけば出力が残ります。
テキトー教師DotAI 認定講師現場感覚で言うと、引数が多いので「どれが必須なのか」で止まりがちですね。prompt と image_file さえ決まれば動くので、そこから始めるのがハードル低いです。
まとめると、呼び出しはこの形です。
python
model = AutoModel.from_pretrained(
    'deepseek-ai/DeepSeek-OCR',
    trust_remote_code=True,
    _attn_implementation='flash_attention_2',
    use_safetensors=True
).eval().cuda().to(torch.bfloat16)

model.infer(
    tokenizer,
    prompt=prompt,
    image_file=image_file,
    output_path=out_dir,
    base_size=1024,
    image_size=640,
    crop_mode=True,
    save_results=True
)
Markdown化・純粋抽出・図表解析でプロンプトを変える
室谷代表取締役ここの設計がよくできてて。用途ごとにプロンプト文字列が公式で用意されてるので、差し替えるだけで出力の性格が変わるんですよ。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこなんですよね。「OCRなのに、なんでプロンプトを選ぶの?」と。
同じ画像でも、Markdownで構造ごと取りたいのか、文字だけ素直に抜きたいのかで頼み方が変わる、と説明すると腑に落ちてもらえます。
同じ画像でも、Markdownで構造ごと取りたいのか、文字だけ素直に抜きたいのかで頼み方が変わる、と説明すると腑に落ちてもらえます。
室谷代表取締役公式に載ってるのはこの並びです。
| 用途 | プロンプト |
|---|---|
| 文書をMarkdown化 | ` |
| 一般画像のOCR | ` |
| レイアウトなしの純粋抽出 | <image>\nFree OCR. |
| 図表解析 | <image>\nParse the figure. |
| 画像の説明 | <image>\nDescribe this image in detail. |
| 指定テキストの位置検索 | ` |
テキトー教師DotAI 認定講師位置検索だけ書き方が独特なので、そこは慣れるまで少し時間がかかりますね。逆に上の4つは文字列を差し替えるだけで済むので、まずは Markdown化から試すのが分かりやすいです。
OpenAI互換APIで呼び出す使い方
室谷代表取締役本番で効いてくるのがこっちで。vLLM を入れて
vllm serve "deepseek-ai/DeepSeek-OCR" でサーバを立てれば、OpenAI互換APIとして叩けるんですよね。テキトー教師DotAI 認定講師これは現場で喜ばれるやつです。新しいSDKを覚えなくても、普段使ってるクライアントの向き先を変えるだけで呼べるので、検証の初速が全然違います。
室谷代表取締役経営目線で言うと、既存の社内ツールからそのまま呼べるかどうかで導入コストが桁で変わるんですよ。専用の連携を書き起こす工数が丸ごと消えるので、そこは大きい。
SGLang や Docker Model Runner でも動かせる形が用意されてます。
SGLang や Docker Model Runner でも動かせる形が用意されてます。
テキトー教師DotAI 認定講師ちなみに軽く試したいだけなら、transformers の pipeline("image-text-to-text") でモデル名を指定する手もあるので、サーバを立てる前にそちらで感触を見るのがおすすめです。
解像度モードはどう選ぶ?TinyからGundamまでの判断基準
Tiny・Small・Base・Largeのトークン数の違い
解像度モード別 入力サイズとビジョントークン数
| モード | 入力サイズ | ビジョントークン |
|---|---|---|
| Tiny | 512×512 | 64 |
| Small | 640×640 | 100 |
| Base | 1024×1024 | 256 |
| Large | 1280×1280 | 400 |
| Gundam | n×640×640+1×1024×1024 | 動的解像度 |
室谷代表取締役解像度の話、まず数字を揃えましょうか。DeepSeek-OCRのモードは、Tinyが512×512で64ビジョントークン、Smallが640×640で100、Baseが1024×1024で256、Largeが1280×1280で400。
上げるほど素直にトークンを食うんですよね。
上げるほど素直にトークンを食うんですよね。
テキトー教師DotAI 認定講師ここ、初めて触る人がいちばん戸惑うところで。「大きい解像度の方が親切でしょ」と思うじゃないですか。
でも実際は読むトークンが増えるぶん遅くなるし、細かい字を無理に読ませても精度が伸びない書類もあるんですよ。
でも実際は読むトークンが増えるぶん遅くなるし、細かい字を無理に読ませても精度が伸びない書類もあるんですよ。
室谷代表取締役一覧にするとこうです。
| モード | 入力サイズ | ビジョントークン |
|---|---|---|
| Tiny | 512×512 | 64 |
| Small | 640×640 | 100 |
| Base | 1024×1024 | 256 |
| Large | 1280×1280 | 400 |
テキトー教師DotAI 認定講師見るべきは右の列なんですよね。同じ1ページでもTinyとLargeで桁が変わるので、ページ数が多い処理だと待ち時間の体感がはっきり分かれます。
Gundamはどんなときに効くのか
室谷代表取締役Gundamは毛色が違って、n×640×640+1×1024×1024という動的解像度なんですよ。ページを640のタイルに刻んで、最後に全体を1024で1枚見る、という組み立てになってます。
テキトー教師DotAI 認定講師「細かい字だけ読みたい」ではなくて、「細かい字と全体のレイアウトを同時に欲しい」ときに効く、という理解でいいですか。
室谷代表取締役そういうことなんですよね。表と本文が混ざってて、局所と全体を両方見ないと崩れる資料。
逆にきれいな横書きの短文なら、Gundamは明らかに過剰で終わります。推論コードではbase_size=1024、image_size=640、crop_mode=Trueを渡す形です。
逆にきれいな横書きの短文なら、Gundamは明らかに過剰で終わります。推論コードではbase_size=1024、image_size=640、crop_mode=Trueを渡す形です。
テキトー教師DotAI 認定講師現場感覚で言うと、最初からGundamで回す人はだいたい遅さに驚きます。まずBaseで出して、崩れたページだけ上げる方が結果的に早いんですよ。
迷ったときの初期設定の決め方
室谷代表取締役実務の判断は「文字がどこまで小さいか」で決めるのがいちばん外れないんですよね。コスト目線で言うと、ビジョントークンはそのままGPU時間なので、読みすぎはそのまま原価になります。
テキトー教師DotAI 認定講師目安を並べるなら、こんな感じでしょうか。
- きれいな活字の短い文書 → Tiny か Small
- 本文と表が混ざる一般的な書類 → Base
- 図表の中の小さい注記まで拾いたい → Large
- レイアウトが入り組んで全体像も要る → Gundam
室谷代表取締役で、最初はBaseで1回流して、崩れたページだけ上げる。MYUUUでも新しい処理を入れるときは、一番軽い設定で通してから上げる順番にしてます。
テキトー教師DotAI 認定講師その順番が効くんですよね。最初からLargeで回して「遅い」で止まるより、Baseで全体を見てから刺さる所に寄せる方が、たぶん1時間の使い方が変わります。
精度はどのくらい?ベンチマークと日本語文書での実力
圧縮率10倍で約97%、20倍で約60%という現実
室谷代表取締役まず数字の話をしておくと、論文のabstractに「テキストトークンがビジョントークンの10倍以内なら復号精度は約97%」と書かれているんですよね。ここが実用判断の分かれ目だと思ってて。
テキトー教師DotAI 認定講師そうなんですよ。で、20倍まで圧縮すると精度は約60%まで落ちる、と。
ここを飛ばして「精度97%」だけが独り歩きしてる感じがします。
ここを飛ばして「精度97%」だけが独り歩きしてる感じがします。
室谷代表取締役60%って、業種によっては使えない数字なんですよ。請求書の金額が4割崩れる前提で業務を回す人はいないわけで・・・。
逆に大量の文書からざっと当たりを付ける用途なら、20倍でも十分ペイする。
逆に大量の文書からざっと当たりを付ける用途なら、20倍でも十分ペイする。
テキトー教師DotAI 認定講師現場感覚で言うと、最初に触る人はこのトレードオフを体で分かってないんですよね。「重い画像を入れた方が精度が上がる」と思い込んで、圧縮率の話とつながってない。
OmniDocBenchで他モデルとどう比べられたか
室谷代表取締役比較の土俵も見ておきたいんですけど、OmniDocBenchでGOT-OCR2.0を100ビジョントークンだけで上回ってる、と。向こうは256トークン使ってるわけですよね。
テキトー教師DotAI 認定講師たしかに。MinerU2.0も平均6000トークン超かかるのに対して、800トークン未満で上回ったというのが論文の主張ですね。
室谷代表取締役トークン数ってそのままGPU時間なんですよ。MYUUUの現場でも処理コストはトークン量でほぼ決まるので、同じ精度を4分の1以下のトークンで出せるなら、それは精度の話じゃなくて原価の話になってくる。
テキトー教師DotAI 認定講師あ、そこは切り分けた方がよくて。ベンチマークは公開データでの話なので、自分の書類で同じ差が出るとは限らないんですよね。
日本語やランダム文字列での検証報告
室谷代表取締役で、肝心の日本語なんですけど。コミュニティで任天堂の有報PDFをMarkdown化して、誤字が見つからなかったという報告がありましたよね。
テキトー教師DotAI 認定講師ありますね。ただ、同じ人がランダムな文字列だと認識率も速度も落ちる、とも書いていて。
日本語の自然文と、ID・型番・記号の羅列では挙動が違うんですよ。
日本語の自然文と、ID・型番・記号の羅列では挙動が違うんですよ。
室谷代表取締役そこは運用で分けるしかないですね。日本語の本文は任せて、英数字のコード列は目視前提にする、みたいな。
テキトー教師DotAI 認定講師そうそう。あとこの手のXの報告は有志の検証なので、公式が保証した数値ではない点は頭に置いておいてほしいです。
実務では自分の書類で一度試すのが早いと思います。
実務では自分の書類で一度試すのが早いと思います。
NVIDIA GPUが無いPCでも動かせるのか
公式が前提にしているのはNVIDIA GPUとbfloat16
NVIDIA GPUが無い環境での実行可否と推論時間
公式の前提
- NVIDIA GPU・bfloat16前提
- flash-attnが必要
- CUDA 11.8 / torch 2.6.0の環境構築が必要
- Windows GUIサンプルはNVIDIA GPU(CUDA)無しでエラー
有志の動作報告
- Mac(M2 Ultra、mps/mlx)で動作報告
- ROCm環境のミニPCで動作報告
- 公式サポート構成ではない(自己責任)
室谷代表取締役まず前提を揃えておくと、公式が想定してるのはNVIDIA GPUなんですよ。Hugging Face版の必要パッケージにflash-attnが入っていて、NVIDIA GPU・bfloat16前提って明記されてます。
テキトー教師DotAI 認定講師そこが最初の壁ですね。初めて触る人は「ライブラリ入れて実行するだけ」という印象で来るので、CUDA 11.8とtorch 2.6.0の環境構築から始まることにまず驚きます。
室谷代表取締役Windows向けのGUIサンプルを公開してる例でも、NVIDIA GPU(CUDA)が無い場合はエラーを出す実装になってる。つまり「GPUが無くても動く」とは公式は一言も言ってないんですよね。
テキトー教師DotAI 認定講師たしかに。そこを曖昧にしたまま進むと、環境構築だけで一日終わるんですよ。
MacやROCm環境での有志の動作報告
室谷代表取締役じゃあMacでは完全に無理かというと、そうでもないのが面白いところで。NVIDIA GPUが無いMac(M2 Ultra、mps/mlx)や、ROCm環境のミニPCでも動かせたという報告が出ています。
テキトー教師DotAI 認定講師現場でよく聞くのはまさにそこなんですよ。「GPUを積んでないノートしか無いんですけど」という相談。
動く、ただし遅い、という前提つきなら選択肢になります。
動く、ただし遅い、という前提つきなら選択肢になります。
室谷代表取締役推論時間の計測も出ていて、ROCm環境のミニPCで約40秒、Mac(mps)で約1分20秒、Mac(cpu)で約2分20秒。1枚あたりこの差なので、何百枚もまとめて裁く用途だと厳しい数字ですよね。
テキトー教師DotAI 認定講師しかもこれは有志の報告なので、公式にサポートされた構成ではないです。自己責任の範囲だという点だけは押さえておきたいですね。
手元で試すときの現実的な選択肢
室谷代表取締役経営目線で言うと、PoCで数十枚試すだけなら手元のMacで足りるし、本番で大量に流すならGPUを時間借りした方が安いんですよね。ここを逆にすると、検証に時間もお金も溶かすことになる。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこです。「動いた」と「仕事で回る」は別物なので。
まず手元で挙動を見て、そのあとGPU環境に移す順番がハマりやすいです。
まず手元で挙動を見て、そのあとGPU環境に移す順番がハマりやすいです。
室谷代表取締役手元で試すときは、動くかどうかの確認だけで一度止めるのがいいんですよ。精度の議論まで同じ日にやろうとすると、だいたい詰まる。
テキトー教師DotAI 認定講師切り分けの話ですね。動かない原因が環境なのかコードなのか分からないまま両方をいじって、余計に分からなくなるパターンが一番多いので。
DeepSeek-OCR2との違いと、商用利用できるのか
解像度モードが一本化されたOCR2の変更点
室谷代表取締役OCR2の話、まず前提としてGitHubのREADMEに2026年1月27日付で「DeepSeek-OCR2」の追記が入ってるんですよね。Hugging Faceにも新しいモデルが公開されていて、名前は「DeepSeek-OCR 2: Visual Causal Flow」、パラメータは3B・BF16のまま。
論文も別に出ていて、arXivの2601.20552ですね。
論文も別に出ていて、arXivの2601.20552ですね。
テキトー教師DotAI 認定講師で、最初に戸惑うのが解像度のところで。v1はTinyからGundamまで5段階から選ぶ形だったのが、v2は動的解像度の一本化になったんですよ。
室谷代表取締役そうなんですよ。(0-6)×768×768+1×1024×1024で、ビジョントークンが(0-6)×144+256。
推論コードはv1とほぼ同じ形で、base_size=1024、image_size=768を使う。呼び出しの型が同じなのは、移行する側からするとかなり助かります。
推論コードはv1とほぼ同じ形で、base_size=1024、image_size=768を使う。呼び出しの型が同じなのは、移行する側からするとかなり助かります。
テキトー教師DotAI 認定講師現場感覚で言うと、モード選択の判断をしなくて済むのは大きいですね。初めて触る人はまずそこで手が止まるので。
v1とv2はどちらを選べばいいのか
v1とv2の選び方とライセンス整理
新規で試す場合
- v2を選ぶ
- 引き継ぐ前提パイプラインが無い
- 最初から新しい方に寄せた方が得
既にv1を組み込んでいる場合
- v1を維持する判断もアリ
- プロンプトもパラメータも同じ形
- 急いで移す必要はない
室谷代表取締役で、どっちを使うかって話になるじゃないですか。新規で試すならv2でいいと思ってて。
理由はシンプルで、これから作るパイプラインに引き継ぐ前提が無いから、最初から新しい方に寄せた方が得なんですよね。
理由はシンプルで、これから作るパイプラインに引き継ぐ前提が無いから、最初から新しい方に寄せた方が得なんですよね。
テキトー教師DotAI 認定講師逆に既にv1を組み込んでる場合は、そのままv1を維持する判断も普通にアリですね。プロンプトもパラメータも同じ形なので、急いで移す必要はないかなと。
室谷代表取締役そうそう。既存資産があるならv1、新規ならv2。
ただ精度の話は留保つきで、DeepSeek側の発表として「Gemini 3 Proを上回る」「v1比で4%以上向上」という説明が紹介されてはいるんですけど、一次ページを直接確認できた数値ではないので、そこは過信しない方がいい。
ただ精度の話は留保つきで、DeepSeek側の発表として「Gemini 3 Proを上回る」「v1比で4%以上向上」という説明が紹介されてはいるんですけど、一次ページを直接確認できた数値ではないので、そこは過信しない方がいい。
テキトー教師DotAI 認定講師そこは大事ですね。手元の書類で一度回してから決める、が結局一番早いです。
MITライセンスなので商用利用できる範囲
室谷代表取締役ライセンス、実務だとここが一番効くところで。GitHubのリポジトリにMITライセンスの表記があって、LICENSEファイルもREADMEのバッジもある。
つまり著作権表示を残せば、商用利用も改変も再配布も可能という整理になります。
つまり著作権表示を残せば、商用利用も改変も再配布も可能という整理になります。
テキトー教師DotAI 認定講師現場でよく聞くのが「社内の業務システムに組み込んでいいのか」という不安なんですよ。MITなら条件を満たせば組み込めるので、そこは変に濁さず案内していい範囲ですね。
室谷代表取締役経営目線で言うと、これはかなりデカいんですよ。ライセンス交渉もロイヤリティも無しでプロダクトに載せられるなら、OCRベンダーの従量課金と比べたときのコスト構造が根本から変わる。
MYUUUでも書類処理の内製は真っ先に検討します。
MYUUUでも書類処理の内製は真っ先に検討します。
テキトー教師DotAI 認定講師ただ、モデルの重みのライセンスと、自分が読ませる文書側の権利は別の話なので、そこは分けて考える必要がありますね。
よくある質問
Q1. 無料で使える?どこにお金がかかる?
室谷代表取締役モデルが公開されている前提だと、モデル自体に利用料はかからないんですよね。ただ動かすにはGPUが要るので、それを借りるのか自前で持つのかでコストの形が変わってきます。
テキトー教師DotAI 認定講師現場でよく聞くのがまさにそこなんですよ。道具は無料だから試せるのに、土台のコストを忘れていて「あれ?」となる。
まずは画像1枚から動かして、費用の輪郭を見るのが安全ですね。
まずは画像1枚から動かして、費用の輪郭を見るのが安全ですね。
室谷代表取締役そうそう。いきなり全社の文書を流す前に、1業務ぶんの処理量でどれくらいかかるか測る。
ROI を見るならそこからです。
ROI を見るならそこからです。
Q2. PDFやスキャンした紙をそのまま入れればいい?
テキトー教師DotAI 認定講師初めて触る人がだいたい戸惑うのがここで。PDFをそのまま渡せばいいと思われがちなんですけど、実際はページを画像として扱う前提なので、画像にしておく必要があります。
室谷代表取締役スキャンものは傾きとか薄い印字で崩れることがあるんで、前処理で解像度を上げておく方が安定するんですよ。手間をどこまでかけるかの勝負ですね。
テキトー教師DotAI 認定講師たしかに。まず1ページを目視で確認して、崩れているなら前処理、崩れていないならそのまま流す。
この順番が一番早いです。
この順番が一番早いです。
Q3. 既存のクラウドOCRから乗り換えるべき?
室谷代表取締役これは用途で分かれるんですよね。定型の帳票から1項目だけ抜くなら、既存のクラウドOCRの方が手軽です。
逆に、レイアウトごと構造として取りたいならこちらが向いてます。
逆に、レイアウトごと構造として取りたいならこちらが向いてます。
テキトー教師DotAI 認定講師現場感覚で言うと、読む対象が「文字」なのか「文書の構造」なのかで道具が変わるんですよ。そこを混ぜたまま比べると判断を間違えます。
室谷代表取締役一部だけ置き換えて比べるのが現実的です。全部入れ替えると切り戻しが効かなくなりますから。
Q4. 大量の文書をまとめて処理すると、どれくらい時間がかかる?
テキトー教師DotAI 認定講師これは環境次第としか言えなくて。GPUの余力と画像の大きさでまるで変わるので、他人の数字を当てにすると外します。
室谷代表取締役なので、まず100枚くらい流して1枚あたりの時間を出して、そこから逆算する。その数字でバッチを組むか夜間に回すかを決めるのが堅いやり方ですね。
テキトー教師DotAI 認定講師あと、途中で落ちたときにどこまで進んだか分かるようにしておくと、実運用でかなり救われます。
Q5. 図や表が混ざったページでも崩れない?
テキトー教師DotAI 認定講師表が入ると急に難易度が上がるんですよ。罫線が薄かったりセルが結合されていたりすると、崩れ方が人によって違って見える。
これ、ハマる人多いんですよね。
これ、ハマる人多いんですよね。
室谷代表取締役構造として抜くのが売りのモデルなので期待したいところですけど、業務で使うなら結合セルのある表をテストに1枚入れておくべきですね。
テキトー教師DotAI 認定講師たしかに。きれいなサンプルだけで試すと、本番でいちばん痛い目を見ます。
まとめ
室谷代表取締役通して見ると、DeepSeek-OCRは「文字を読む道具」というより「文書を構造のまま持ち出す道具」なんですよね。そこに期待値を置けるかで評価が変わってきます。
テキトー教師DotAI 認定講師そうですね。最初の一歩は、自分の業務から1ページ選んで、解像度モードを変えながら出し比べてみる。
それだけで自分たちの用途に合うかは見えます。
それだけで自分たちの用途に合うかは見えます。
室谷代表取締役費用の話も、いきなり大きく構えず、1業務ぶんの処理量で測る。数字が見えてから広げればいいんですよ。
テキトー教師DotAI 認定講師あと、公式の情報は更新が早いので、導入前に一度自分の目で確認しておくのがおすすめです。手元の環境で1枚通す、そこから始めましょう。