GLM-5.2とはどんなモデル?開発元と規模をまず整理
Z.aiが出した「長時間タスク向け」の旗艦モデル
GLM-5.2の基本情報
開発元
中国のZ.ai(旧Zhipu AI/智譜)
発表日
2026年6月16日
位置づけ
長時間タスク向けの旗艦モデル。前世代GLM-5.1より長時間タスク遂行力が大幅向上
モデル規模
744BのMoE構成。実際に動くのはアクティブ40B
ライセンス
MITライセンス・地域制限なし。重みはHuggingFaceとModelScopeで公開
コンテキスト
1Mトークン(初の安定運用)。最大出力は128K
IndexShare
疎注意のインデクサーを4層ごとに共有し、1M長での計算量を2.9倍削減
思考努力レベル
コーディング時にHighとMaxから選択可能
 室谷代表取締役
GLM-5.2は、中国のZ.ai(旧Zhipu AI/智譜)が2026年6月16日に発表した長時間タスク向けの旗艦モデルなんですよね。GLMシリーズ全体の流れが分からないと位置づけが掴みにくいので、そこはGLMとは何か、最新GLM-5.3の進化と料金・ライセンスを実務目線で整理で解説しています。
 テキトー教師DotAI 認定講師
最初に戸惑うのが「長時間タスク向け」って何が違うのか、というところで。数秒で終わる質問に答えるモデルではなくて、何時間もかけて手を動かし続ける前提の設計なんですね。
だから比較の軸も、賢さというより粘り強さになる。
だから比較の軸も、賢さというより粘り強さになる。
室谷代表取締役そう。前のGLM-5.1と比べて長時間タスクの遂行力が大きく上がってて、そこが今回の売りなんですよ。
短い質問の精度競争じゃなくて、放っておいても走り切るかどうか。オープンウェイト勢がこの土俵に上がってきたのは構造として大きいなと見てます。
短い質問の精度競争じゃなくて、放っておいても走り切るかどうか。オープンウェイト勢がこの土俵に上がってきたのは構造として大きいなと見てます。
テキトー教師DotAI 認定講師たしかに。1回の返答の質より、任せた作業を最後まで落とさないかどうか。
現場で見る目線もここ最近で変わったなと感じます。
現場で見る目線もここ最近で変わったなと感じます。
744B・アクティブ40BのMoE構成と、MITライセンスの効き方
室谷代表取締役規模の話を先に置くと、744BのMoEで、実際に動くのはアクティブ40B。全部を毎回動かさない設計なんですよね。
これが後で出てくるローカル実行の話に直結します。
これが後で出てくるローカル実行の話に直結します。
テキトー教師DotAI 認定講師初めて触る人は「744B」って数字だけ見て身構えるんですよ。でもMoEは毎回すべてのパラメータを使うわけじゃないので、体感的にはもっと軽い。
数字の見た目と実際の重さがズレるんですよね。
数字の見た目と実際の重さがズレるんですよね。
室谷代表取締役ライセンスがMITで、地域制限なしというのも経営目線だと効くところで。重みがHuggingFaceとModelScopeで公開されてるので、社内環境に閉じて運用する選択肢が現実的に取れる。
調達の交渉材料になるんですよ、これは。
調達の交渉材料になるんですよ、これは。
テキトー教師DotAI 認定講師使えるかどうかをベンダー側の判断に預けなくていい、という安心感は大きいですね。ここが「無料で試せる」以上の意味を持ちます。
1Mトークンのコンテキストと最大出力128Kで何が変わるのか
室谷代表取締役スペック面だと1Mトークンのコンテキストを初めて安定運用できるようにした、と。最大出力は128Kです。
入れる量と出す量の両方が大きい前提で組めるようになる、ということなんですよね。
入れる量と出す量の両方が大きい前提で組めるようになる、ということなんですよね。
テキトー教師DotAI 認定講師ここでよく誤解されるのが、コンテキストが大きい=長い出力もできる、ではないところで。読ませる枠と書き出させる枠は別物なので、128K出力が効くのは設計書を丸ごと書かせるみたいな場面です。
室谷代表取締役裏側ではIndexShareという仕組みで疎注意のインデクサーを4層ごとに共有して、1M長での計算量を2.9倍削減してる。仕組みの名前はともかく、長い文脈を入れるとコストが跳ねる問題に手を入れてる、という理解でいいと思います。
テキトー教師DotAI 認定講師あとコーディング時に思考努力レベルをHighとMaxから選べるのも地味に効きますね。難所だけMaxに寄せる、みたいな配分ができるのが現場だとありがたいんですよ。
コーディング性能はClaude Opus 4.8やGPT-5.5とどう違う?
Terminal-Bench 2.1とSWE-bench Proで見る素点の差
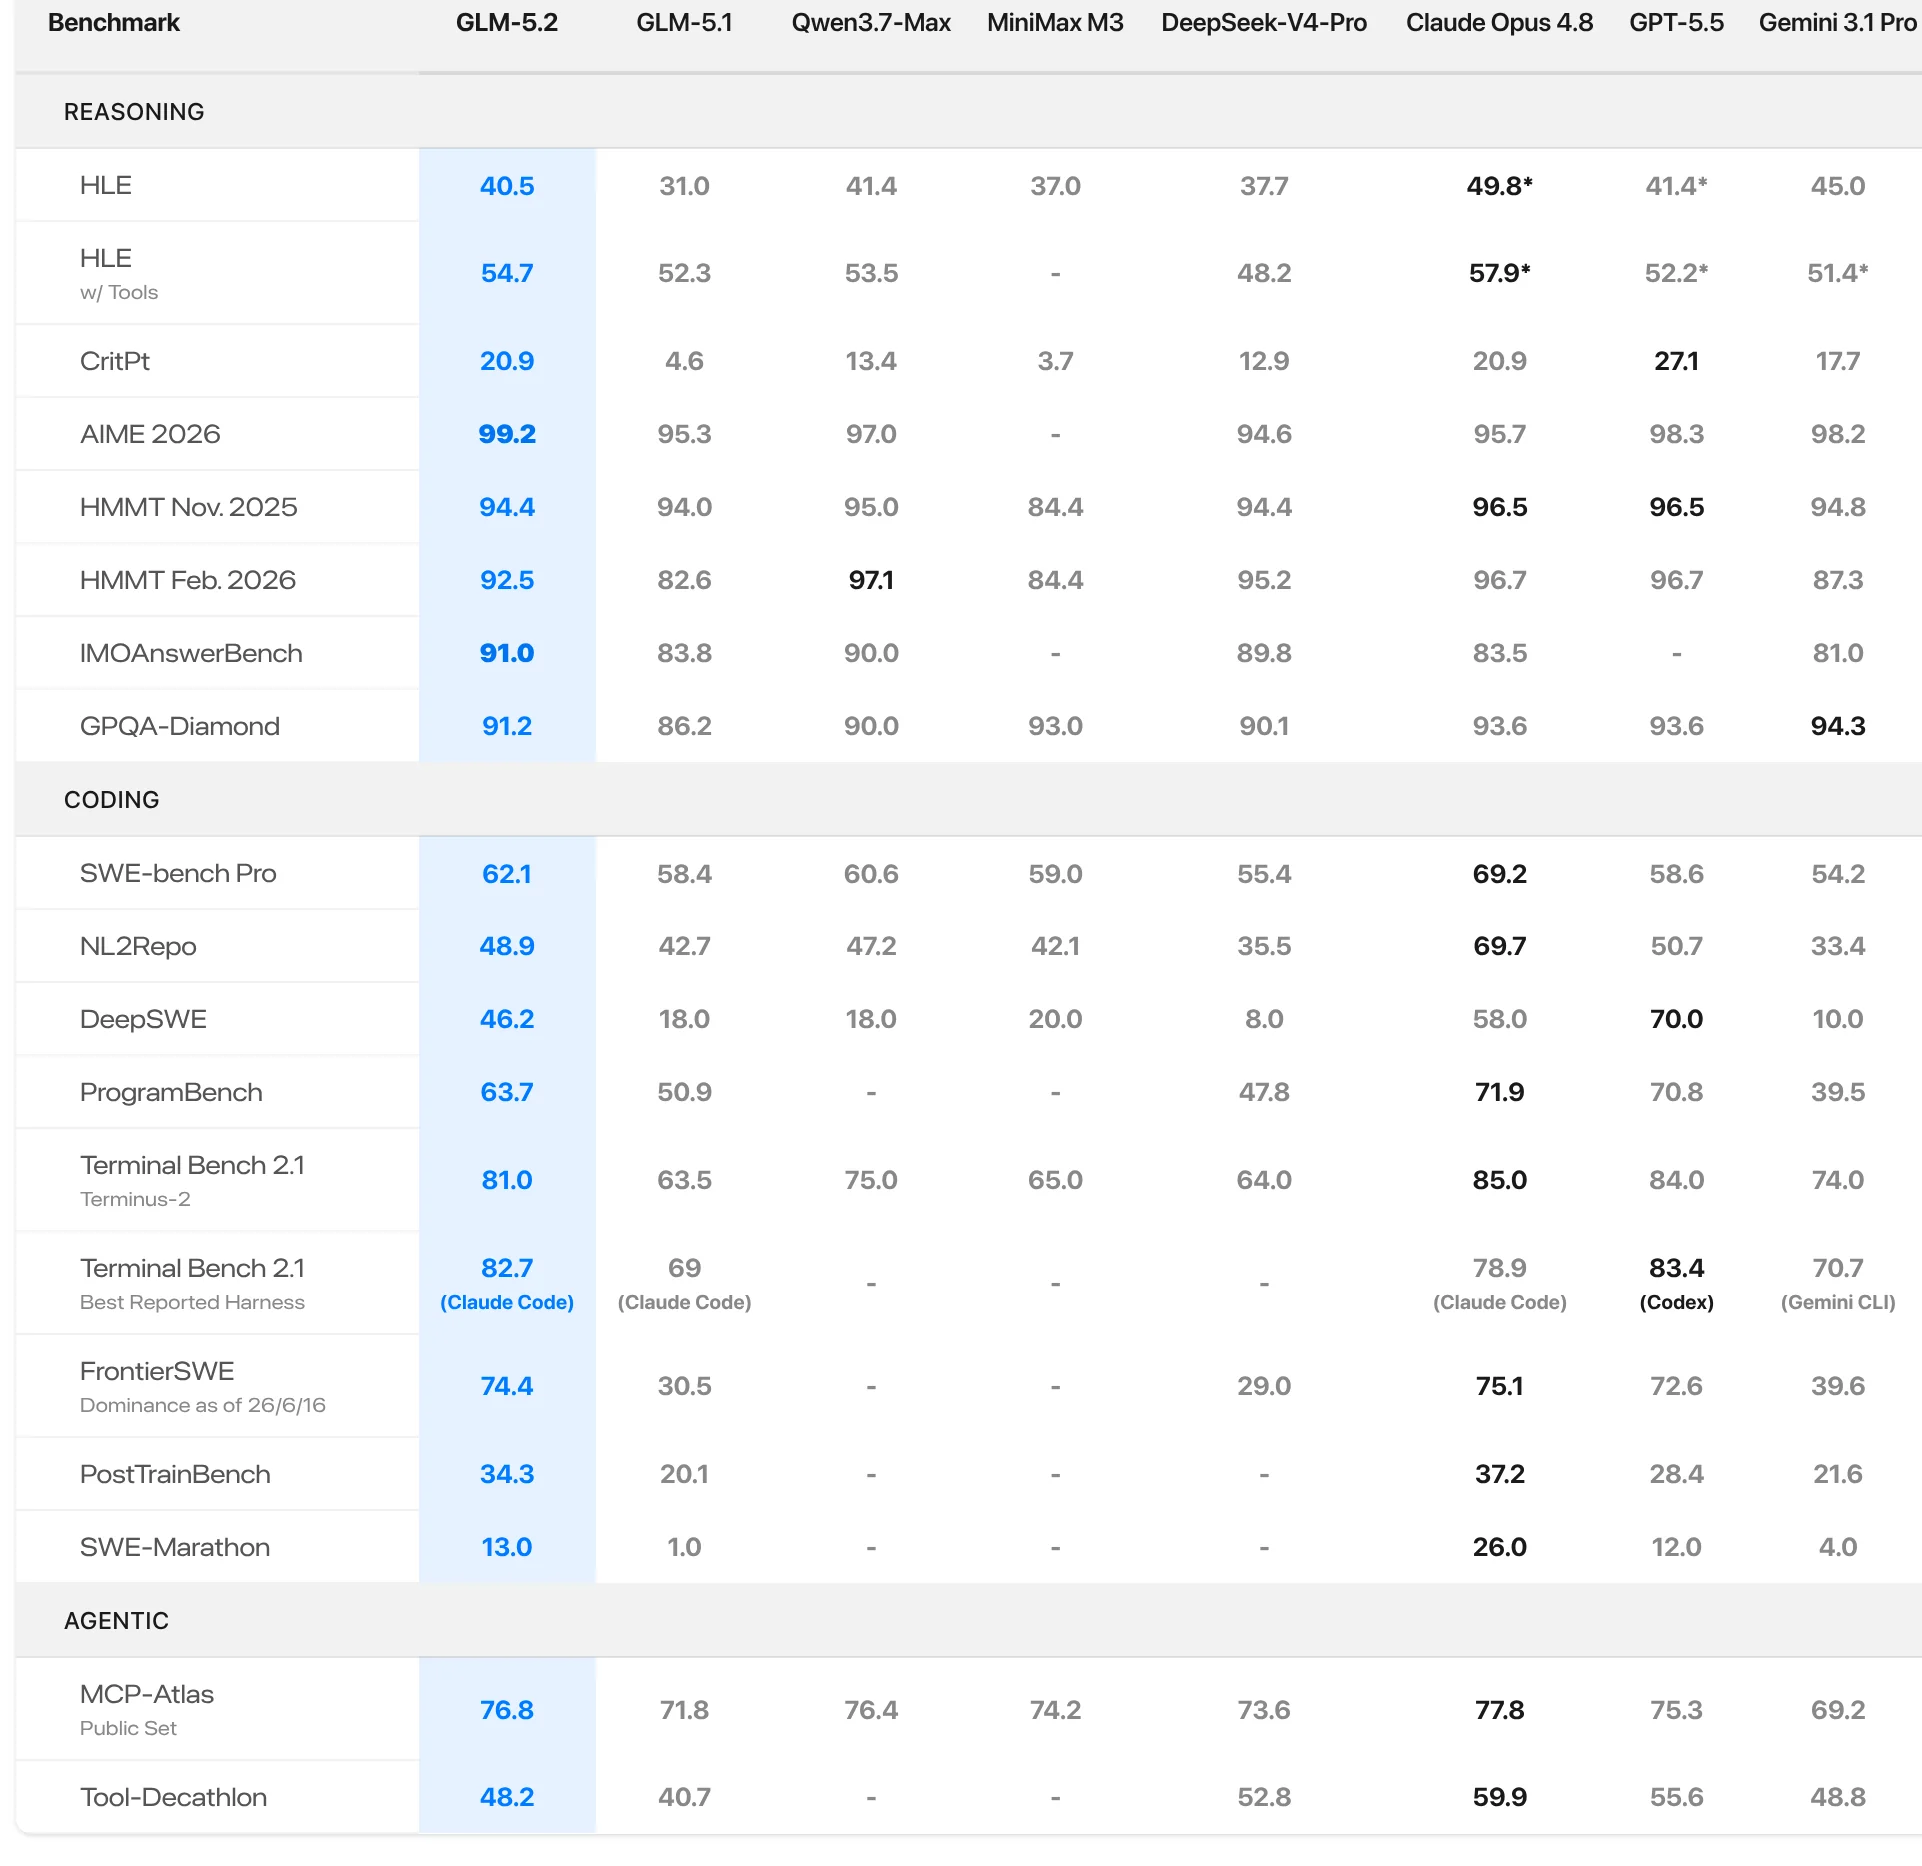
室谷代表取締役まず素点から並べますか。Terminal-Bench 2.1は GLM-5.2 が81.0、Opus 4.8が85.0、GPT-5.5が84.0、Gemini 3.1 Proが74.0。
前モデルのGLM-5.1は63.5なので、土台が一段上がってるんですよね。
前モデルのGLM-5.1は63.5なので、土台が一段上がってるんですよね。
テキトー教師DotAI 認定講師ここで見落とされがちなのが伸び幅のほうで。10ポイント以上いっきに上がってるのは、触った感じでも「別モデルになった」に近い印象です。
室谷代表取締役ただSWE-bench Proになると GLM-5.2が62.1、Opus 4.8が69.2、GPT-5.5が58.6でGemini 3.1 Proは54.2。GPT-5.5は抜いてるけど、Opusには7ポイント届かない。
テキトー教師DotAI 認定講師短いタスクの精度はOpusが上、という並びは素直に受け取っていいと思います。
FrontierSWEの数値が示す長時間タスクの伸び方
室谷代表取締役で、FrontierSWE。数時間から数十時間規模の自律タスクです。
GLM-5.2が74.4、Opus 4.8が75.1、GPT-5.5が72.6。
GLM-5.2が74.4、Opus 4.8が75.1、GPT-5.5が72.6。
テキトー教師DotAI 認定講師GLM-5.1が30.5なので、ここが一番の変化点ですね。30から74って、もう競技が変わってる感じがします。
室谷代表取締役1%差ですからね。Opusに並んだと言っても言い過ぎじゃない。
テキトー教師DotAI 認定講師初めて触る人は「何時間も走らせて大丈夫なの」と身構えるんですが、数字の上ではそこを狙って作られたモデルなんですよ。
SWE-Marathonで開いたOpus 4.8との差はどこから来るのか
室谷代表取締役ところがSWE-Marathon、超長時間のソフトウェア工学タスクになると GLM-5.2が13.0、Opus 4.8が26.0、GPT-5.5が12.0。ここで一気に差が開く。
テキトー教師DotAI 認定講師数時間は並ぶのに、その先で失速するんですよね。最初に戸惑うのがまさにこの部分です。
室谷代表取締役経営目線で言うと、何十時間も回す案件は1回の失敗の損失が大きいので、この差は料金差以上に見えることがあるんですよ。モデル単体というより、立て直し力の差かなと。
テキトー教師DotAI 認定講師PostTrainBenchも34.3対37.2で、近いけど詰め切れてない。その位置づけが正確だと思います。
思考努力レベルをHighとMaxで切り替える使い分け
室谷代表取締役で、そこを埋めるための仕組みが思考努力レベル。HighとMaxから選べて、Maxにすると難しいタスクに計算を多く割けます。
テキトー教師DotAI 認定講師現場でよく聞くのは「常にMaxでいいのでは」なんですが、待ち時間も消費も増えるので、まずHighで流して詰まったところだけMaxに上げるほうが現実的です。
室谷代表取締役その切り分けは人間側の設計なんですよね。ツールが勝手に最適化してくれるわけじゃない。
テキトー教師DotAI 認定講師たしかに。ベンチマークは前提つきの素点なので、自分のタスクで一度回してみるのが一番早いですね。
1Mトークンのコンテキストは実務で何ができるようになる?
IndexShareで計算量を2.9倍削減
室谷代表取締役1Mトークンって聞くと「数字が大きいね」で終わりがちなんですが、中身は IndexShare という仕組みで、DSA のインデクサーを4層ごとに共有してるんですよ。その結果、1M長のコンテキストでも計算量が2.9倍削減されてる。
テキトー教師DotAI 認定講師そこ、地味に見えて一番効くところです。長い文脈を入れると普通は待ち時間とコストが跳ね上がるので、まず「実用に耐えるのか」が問題になる。
削減の話はその前提を崩す話なんですよね。
削減の話はその前提を崩す話なんですよね。
室谷代表取締役経営目線で言うと、長い文脈が使えるかどうかは「入るか」じゃなくて「単価が合うか」なんですよ。ここが2.9倍違うと、同じ予算でできる仕事の量が変わってくる。
MTPで受理率を最大20%改善
室谷代表取締役もうひとつが MTP 層の改良で、投機的デコードの受理率が最大20%改善されてる、と。出力側は最大128Kトークンまで出せる。
テキトー教師DotAI 認定講師速くなる話と長く出せる話は別物なんですけど、両方そろうと「一気に最後まで書かせる」使い方が現実的になります。途中で切れる前提で設計しなくて済むのが大きい。
室谷代表取締役なるほど。出力が長く出る前提になると、こっちの頼み方も変わりますね。
テキトー教師DotAI 認定講師そうなんです。最初に戸惑うのが、長い回答を分割して出させるクセが抜けないこと。
そこは意識して変えていい部分だと思います。
そこは意識して変えていい部分だと思います。
リポジトリ全体や長いログをそのまま渡せる現場感覚
テキトー教師DotAI 認定講師現場でよく聞くのは「どのファイルを渡すか選ぶのが一番しんどい」という声です。リポジトリ全体をそのまま入れて、探させる方が早いケースが増えました。
室谷代表取締役選別の時間が消えるのがでかいんですよ。時給で換算すると、モデルの賢さよりそっちの削減幅の方が大きかったりする。
テキトー教師DotAI 認定講師長いログも同じで、エラーの前後を切り貼りする手間がなくなります。切り貼りの時点で情報が落ちてるんですよね、たぶん。
室谷代表取締役その「落ちてる」に気づかないまま原因不明で詰まる、というのがよくあるパターンな気がします。
広いコンテキストが効く場面と、そうでもない場面
室谷代表取締役ただ、全部1Mに放り込めばいいかというと違うと思うんですよ。関係ないコードまで入れると、それはそれでノイズになる。
テキトー教師DotAI 認定講師たしかに。効くのは横断的な調査や、依存関係をまたぐ修正。
逆に単一ファイルの小さな直しなら、狭く渡した方が安定します。
逆に単一ファイルの小さな直しなら、狭く渡した方が安定します。
室谷代表取締役うちの現場でも、でかいリポジトリを丸ごと渡すより対象を絞った方が当たることは普通にあります。道具の上限が上がったからといって、常に上限まで使うのが正解ではないんですよね。
テキトー教師DotAI 認定講師最初に戸惑うのがそこなんです。「入るから入れる」じゃなくて「入れる価値があるか」で選ぶ。
この基準に慣れると、使い方が一気に変わります。
この基準に慣れると、使い方が一気に変わります。
オープンウェイトのGLM-5.2をローカルで動かすには何が必要?
量子化レベル別の必要メモリを数字で並べる
室谷代表取締役ローカルで動かす話、先に数字を置いた方が早いんですよね。GLM-5.2は744Bパラメータでアクティブ40BのMoE構成。
フル精度で載せようなんて発想が出ないサイズなんですよ。
フル精度で載せようなんて発想が出ないサイズなんですよ。
テキトー教師DotAI 認定講師初めて触る人がだいたいここで固まります。「量子化って何を選べばいいんですか」って。
なので先に並べますね。
なので先に並べますね。
| 量子化 | 必要メモリの目安 |
|---|---|
| 16bit(フル) | 約1.5TB |
| 8bit | 約810GB |
| 4bit | 約372〜475GB |
| 2bit(UD-IQ2_M) | 約245GB |
| 1bit(UD-IQ1_S) | 約223GB |
室谷代表取締役16bitが1.5TB、8bitでも810GB。ここだけで一般的なワークステーションは圏外なんですよね。
4bitの372〜475GBでも、GPUのVRAMに全部収める発想だと詰む数字です。
4bitの372〜475GBでも、GPUのVRAMに全部収める発想だと詰む数字です。
テキトー教師DotAI 認定講師現場感覚で言うと、「VRAMに全部載せる」を捨てられるかが分かれ目なんですよ。CPU側のメモリに逃がす前提に切り替わると、一気に現実味が出てきます。
245GBで動く2bit構成は何が必要で、精度はどう落ちるのか
室谷代表取締役245GBっていう数字、実は狙い目なんですよ。256GB統合メモリのMac、あるいは24GBのVRAM+256GB RAMのMoEオフロード構成で動く、と公開情報では言われてます。
テキトー教師DotAI 認定講師ただ精度は落ちます。2bitでtop-1が約82%、1bitだと約76.2%。
サイズは84〜86%減なので、体感としては「別物ではないけど、細かい指示の取りこぼしが増える」感じです。
サイズは84〜86%減なので、体感としては「別物ではないけど、細かい指示の取りこぼしが増える」感じです。
室谷代表取締役コスト目線で言うと、そのメモリを積んだマシンの金額と、APIを叩いた金額を並べて判断した方がいいんですよね。毎日回すなら元が取れる計算になるのか、月に数回なら素直にAPIか、と。
テキトー教師DotAI 認定講師たしかに。あと1bitは最後の手段で、まず2bitで自分の用途に耐えるか試す順番が現実的ですね。
transformers・vLLM・SGLang・xLLM・ktransformersのどれを選ぶか
室谷代表取締役で、動かす側のソフトを何にするか。公式が対応として挙げているのはtransformers、vLLM、SGLang、xLLM、ktransformersなんですよ。
テキトー教師DotAI 認定講師最初に戸惑うのがここで。「どれでも動くなら好きなのでいいの?」となるんですが、役割が違うんです。
まず動作確認ならtransformers、速度や並列で回すならvLLMやSGLang側、という住み分けで見てます。
まず動作確認ならtransformers、速度や並列で回すならvLLMやSGLang側、という住み分けで見てます。
室谷代表取締役手元の1台で試す段階なら、量子化フォーマットと噛み合うかで選ぶのが現実的。GGUF形式の量子化版を使うなら、配布元の手順に従うのが一番早いんですよね。
テキトー教師DotAI 認定講師そうですね。どの組み合わせが自分の環境で動くかは構成次第なので、公式と配布元の最新手順を確認してから始めるのが安全です。
GLM Coding Planの料金とクォータは今どうなっている?
2026年7月30日から、プロンプト制ではなくクレジット制
GLM Coding Plan 新旧プラン比較(2026年7月30日移行)
| 項目 | 新プラン(クレジット制) | 旧プラン(Legacy Plan V2) |
|---|---|---|
| 課金単位 | クレジット | プロンプト |
| Lite枠 | 5時間2,000/週10,000 | 5時間約80/週約400 |
| Pro枠 | 5時間12,000/週60,000 | 5時間約400/週約2,000 |
| Max枠 | 5時間28,000/週140,000 | 5時間約1,600/週約8,000 |
| 月額目安 | Lite 18ドルから | — |
| 利用モデル | GLM-5.3/GLM-5.3-Flashのみ | — |
| 新規契約 | 適用 | × |
室谷代表取締役まず前提を揃えておきたいんですけど、GLM Coding Planって2026年7月30日から課金の数え方が変わってるんですよ。プロンプト制からクレジット制へ、という移行ですね。
テキトー教師DotAI 認定講師そこが一番の落とし穴で。初めて契約する人が古い情報を見て「5時間で80回しか使えないの?」って不安になるパターン、現場でよく聞きます。
室谷代表取締役で、もっと大事なのが、現行プランで使えるモデルがGLM-5.3とGLM-5.3-Flashだけなんですよね。GLM-5.2を名指しで投げても自動で5.3に流される。
つまりCoding Plan経由では5.2を選んで使うことはできないんです。
つまりCoding Plan経由では5.2を選んで使うことはできないんです。
テキトー教師DotAI 認定講師そこ、混同する人が多いんですよ。「5.2を使いたいからCoding Plan」と思って入ると、実際に動くのは後継モデルのほうなんですよね。
Lite・Pro・Maxのクレジット枠と消費量の計算式
室谷代表取締役現行のクレジット枠、数字を並べるとこうなります。
| プラン | 5時間あたり | 週あたり | 月額の目安 |
|---|---|---|---|
| Lite | 2,000 | 10,000 | 18ドルから |
| Pro | 12,000 | 60,000 | 上位プラン |
| Max | 28,000 | 140,000 | 上位プラン |
テキトー教師DotAI 認定講師で、消費量の計算式がまた独特で。(入力トークン×入力倍率+キャッシュ入力トークン×キャッシュ倍率+出力トークン×出力倍率)÷10,000。
GLM-5.3の場合の倍率は入力6.9、キャッシュ1.7、出力24です。
GLM-5.3の場合の倍率は入力6.9、キャッシュ1.7、出力24です。
室谷代表取締役ここ、見積もりを立てる立場から言うと、この式を知らないまま「とりあえずLiteで」と入ると、長い出力を出させる使い方で一気に削られるんですよ。出力の倍率が24なので。
テキトー教師DotAI 認定講師入力6.9に対して出力24ですからね。短い質問を大量に投げるより、長いコードを書かせるほうが枠を食う。
料金と設定の細かいところはGLM Coding Planの料金・クレジット・Claude Code設定を最新情報で整理で解説しています。
料金と設定の細かいところはGLM Coding Planの料金・クレジット・Claude Code設定を最新情報で整理で解説しています。
ネット上に出回る「5時間80プロンプト」は旧プランの話
テキトー教師DotAI 認定講師ここで最初の話に戻るんですけど、ネット上に出回っている「5時間80プロンプト」という数字は、2026年7月30日より前に契約した人向けの旧プラン(Legacy Plan V2)の目安なんですよ。
室谷代表取締役旧プランの数字も一応整理すると、Liteが5時間で約80プロンプト・週約400、Proが5時間約400・週約2,000、Maxが5時間約1,600・週約8,000。1プロンプトはモデル呼び出し15〜20回相当という単位です。
テキトー教師DotAI 認定講師新規契約には適用されないので、この数字を前提にすると見積もりがズレるんですよね。旧プランは契約継続中の人がそのまま使い続けられる、という扱いです。
ピーク時間を外すと消費が半額になる仕組み
室谷代表取締役あと見逃せないのが、ピーク時間以外は消費が0.5倍になる点です。UTC+8の月〜金14:00〜18:00がピークで、そこを外すと半額になります。
テキトー教師DotAI 認定講師日本時間に直すと15時から19時ですね。重い処理をその帯からずらすだけで、同じ枠が実質2倍使えるという感覚です。
室谷代表取締役経営目線で言うと、これはチームで「ピークを避ける」運用ルールを決めるかどうかでコストが変わるってことなんですよね。同じ月額で回せる量が変わるなら、そこは運用で回収したい。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこです。「なんで時間帯で消費が違うの?」って。
でも慣れると、まとめて走らせる使い方を自然と夜に寄せるようになります。
でも慣れると、まとめて走らせる使い方を自然と夜に寄せるようになります。
Claude CodeやClineにGLM-5.2を組み込むには?
Claude Codeは環境変数2つを設定して起動するだけ
Claude CodeにGLM-5.2を組み込む手順
- 01GLM Coding Planのキーを用意する認証に使うAPIキーを取得
- 02ANTHROPIC_BASE_URLを設定https://api.z.ai/api/anthropic を指定
- 03ANTHROPIC_AUTH_TOKENを設定手順1で用意したキーを指定
- 04普段どおりclaudeコマンドを起動モデル名の指定は不要。接続先ごと差し替えるイメージ
室谷代表取締役組み込み方、拍子抜けするくらいシンプルなんですよ。Claude Codeの場合、環境変数を2つ設定して、あとは普段どおりclaudeコマンドを叩くだけです。
テキトー教師DotAI 認定講師最初に戸惑うのがそこなんですよね。「専用のアプリを入れるんですか」と聞かれるんですが、実際は既存の道具の接続先を差し替えるだけなんです。
室谷代表取締役手順はこうです。
- GLM Coding PlanのAPIキーを用意する
- 環境変数
ANTHROPIC_BASE_URLにhttps://api.z.ai/api/anthropicを設定する - 環境変数
ANTHROPIC_AUTH_TOKENに用意したキーを設定する - 通常どおり
claudeコマンドを起動する
これだけで、あとはいつもと同じ画面で動きます。戻したいときは変数を外すだけなので、検証用と本番用を行き来するのも楽なんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのは、シェルの設定ファイルに書いたまま別のプロジェクトで起動して「あれ、なんか違う」となるパターンです。プロジェクト単位で切り替えられるようにしておくと安全ですよ。
Cline・OpenCode・Codex・Aiderなど20以上の対応ツール
テキトー教師DotAI 認定講師Claude Code専用の話かというとそうでもなくて、Cline、OpenCode、Codex、Aider といったあたりまで含めると20以上のツールが対応しています。手元の道具を変えずに試せるのが大きいですね。
室谷代表取締役ここは構造的に面白くて。モデル側から主要なコーディングツールを先に押さえにいくのは、配布チャネルを自前で作らずに既存のワークフローに乗る戦略なんですよ。
ユーザー側は乗り換えコストゼロで触れるわけです。
ユーザー側は乗り換えコストゼロで触れるわけです。
テキトー教師DotAI 認定講師画面が違うだけで中身は同じモデルなので、Clineで試してからClaude Codeに移す、みたいな比較がしやすいんですよね。乗り換えの判断材料が揃うのは助かります。
室谷代表取締役ただ、Coding Plan経由で使う場合は注意があって。いま指定できるモデルはGLM-5.3系で、GLM-5.2を指定してもGLM-5.3へ自動で振り分けられます。
設定手順は同じでも中身が変わるので、そこは頭に入れておいたほうがいいです。
設定手順は同じでも中身が変わるので、そこは頭に入れておいたほうがいいです。
pay-as-you-goのAPIから呼ぶときはmodelにglm-5.2を指定
室谷代表取締役どうしてもGLM-5.2そのものを動かしたいなら、Coding PlanではなくAPIを直接叩くルートになります。この場合はmodelパラメータに "glm-5.2" を指定するだけです。
テキトー教師DotAI 認定講師ここで詰まりやすいのが、ツール側の設定画面が「モデル名を自由入力」なのか「一覧から選ぶ」なのかの違いで。後者のタイプだと一覧に無ければ出てこないので、初めて触る人はここで止まりがちです。
室谷代表取締役その場合はカスタムモデルとして登録するか、SDKから直接呼ぶ形ですね。cURLやSDKのサンプルが公式ドキュメントに載っているので、まずはそこで疎通を見るのが早いです。
従量課金なので、チームで回すなら先に月の上限を決めておく。料金制度まわりの細かい話はGLM Coding Planの料金・クレジット・Claude Code設定を最新情報で整理にまとまっているので、設定前に一度確認しておくと安心です。
従量課金なので、チームで回すなら先に月の上限を決めておく。料金制度まわりの細かい話はGLM Coding Planの料金・クレジット・Claude Code設定を最新情報で整理にまとまっているので、設定前に一度確認しておくと安心です。
テキトー教師DotAI 認定講師あと、環境変数方式とAPI直叩き方式を同じ端末で混ぜると、どっちのキーが効いているのか分からなくなりがちです。切り替え用のシェル関数をひとつ用意しておくと、そういう事故が減りますよ。
APIの料金はいくら?中国本土のbigmodel.cnと国際版の違い
中国本土の公式価格は入力8元・出力28元・キャッシュ2元
室谷代表取締役APIの従量課金でGLM-5.2を使うといくらなのか。これ、「どこで契約するか」で話が変わるんですよね。
テキトー教師DotAI 認定講師たしかに。料金表を見ても、どのプラットフォームの価格なのか書いてない記事が多いんですよ。
初めて触る人がそこで止まるんです。
初めて触る人がそこで止まるんです。
室谷代表取締役智譜の中国本土向けプラットフォーム、open.bigmodel.cnの公式価格表だと、入力8元・出力28元・キャッシュヒット2元。いずれも100万トークンあたりで、人民元なんですよね。
テキトー教師DotAI 認定講師しかもこれ、最新旗艦のGLM-5.3と同額なんですよ。一世代前だから安い、というわけではないのが面白いところで。
その数字は人民元決済の中国本土契約のもの
室谷代表取締役ここが曖昧になりがちなポイントで。この8元・28元というのは、人民元で決済する中国本土契約の価格なんです。
テキトー教師DotAI 認定講師現場でよく聞くのは「ドルだといくら?」なんですよね。日本人の感覚だとそこが一番知りたいところで。
室谷代表取締役国際版のz.ai、api.z.aiのほうは米ドル決済で、契約体系そのものが別枠なんです。今回の調査では米ドル単価のページを確認できなかったので、正確な数字は公式サイトで直接見てもらうのが確実です。
テキトー教師DotAI 認定講師為替も絡みますから、換算した数字を鵜呑みにするより契約画面で確認するほうが安心ですね。
単価を見るときに効くのは出力側とキャッシュ
室谷代表取締役経営目線で言うと、入力8元に対して出力28元。出力が入力の3.5倍なんですよ。
エージェントを回すと出力が膨らむので、コストの重心はそこに寄るんですよね。
エージェントを回すと出力が膨らむので、コストの重心はそこに寄るんですよね。
テキトー教師DotAI 認定講師キャッシュヒットが2元というのも効きます。同じ長いコンテキストを何度も投げる使い方だと、体感の請求額がかなり変わってきますから。
室谷代表取締役あと、この単価がGLM-5.3と同額という点は構造的にも面白くて。後継が出ても旧モデルの値段が下がらないなら、安さを理由に5.2へ戻る動機は生まれにくいわけです。
テキトー教師DotAI 認定講師そこは選択の基準が「価格」じゃなく「必要な性能かどうか」になる、ということですね。GLMシリーズ全体の料金体系はGLMとは何か、最新GLM-5.3の進化と料金・ライセンスを実務目線で整理のほうで整理されています。
2026年10月現在、GLM-5.2を使おうとすると何が起きる?
GLM Coding Planでglm-5.2を指定してもGLM-5.3に回される
室谷代表取締役まず前提を揃えておくと、2026年10月時点でCoding Planの契約からGLM-5.2を名指しで呼ぶことはできないんですよね。現行プランがサポートしているのはGLM-5.3とGLM-5.3-Flashだけで、5.2を指定したリクエストは自動的に5.3へルーティングされる仕様になっています。
テキトー教師DotAI 認定講師現場でよく聞くのが「モデル名を変えたのに挙動が変わらない」という声なんですよ。設定ファイルに古い名前が残っていても裏で振り分けられているので、そこに気づけないまま議論が進んじゃう。
室谷代表取締役これは事業側から見ると地味に厄介で、コスト計算の前提が変わるんですよ。クレジットの消費倍率はモデルごとに決まっているので、実際にどれが動いたかを把握していないと見積もりが狂う。
経緯はZ.aiの「GLM-5.3」とは?Amazon Bedrockで企業向け提供開始で解説しています。
経緯はZ.aiの「GLM-5.3」とは?Amazon Bedrockで企業向け提供開始で解説しています。
それでもGLM-5.2そのものを使うべき3つの場面
GLM-5.2を使う手段と注意点
Coding Plan経由
- GLM-5.2を名指しで呼べない
- サポートはGLM-5.3とGLM-5.3-Flashのみ
- 5.2指定リクエストは自動で5.3へルーティング
- モデル名を変えても挙動が変わらない
- クレジット消費倍率はモデルごとに異なり見積もりが狂う
pay-as-you-go API
- modelに「glm-5.2」を直接指定
- モデル名を自分で指定したい検証環境向け
テキトー教師DotAI 認定講師じゃあ5.2を触る意味はもう無いんですか、という質問が来そうですね。
室谷代表取締役用途は残っていて、挙げるなら3つなんですよ。ひとつは重みを手元に置いた検証で、MITライセンスで公開されていて地域制限もないから社内ネットワークに閉じて動かせる。
ふたつ目は世代を固定した再現性のある評価。みっつ目は、モデル名を自分で直接指定したい検証環境ですね。
ふたつ目は世代を固定した再現性のある評価。みっつ目は、モデル名を自分で直接指定したい検証環境ですね。
テキトー教師DotAI 認定講師最初に戸惑うのが、一体どこで5.2を選べるのかという点なんですよ。プランの画面を探しても出てこないので、そこで手が止まる人が多いんですよね。
室谷代表取締役そこは経路の話で、pay-as-you-goのAPIでmodelに「glm-5.2」を指定するか、公開されている重みをtransformersやvLLM、SGLangあたりでローカルに立てるかの二択になります。6月の発表直後の記事は、この置き換わりの事実に触れていないものが多いんですけどね。
Claude・GPT・DeepSeekとの使い分けと、中国製モデルを選ぶときの注意
室谷代表取締役性能の位置づけで言うと、長時間の自律タスクを示すFrontierSWEではClaude Opus 4.8が75.1、GLM-5.2が74.4でほぼ並ぶんですよ。一方でSWE-Marathonのような超長時間タスクは26.0対13.0で差が開く。
だから何時間も走らせ続ける案件はまだClaude側に置く、という判断になるんですよね。
だから何時間も走らせ続ける案件はまだClaude側に置く、という判断になるんですよね。
テキトー教師DotAI 認定講師使い分けの感覚で言うと、GLM-5.2はオープンウェイトでここまで来たこと自体に価値があるモデルなんですよ。DeepSeekと並べて語られることもありますけど、条件を揃えた比較は手元に無いので、そこは各自で確かめた方がいいと思います。
室谷代表取締役中国製モデルを業務に入れるときの注意は、契約主体とデータの置き場所なんですよ。中国本土のbigmodel.cnと国際版のapi.z.aiでは決済も管轄も違う。
法務と情シスを通す前提で経路を先に決めてから触る、というのが順番だと思います。
法務と情シスを通す前提で経路を先に決めてから触る、というのが順番だと思います。
テキトー教師DotAI 認定講師たしかに。技術検証と本番導入を分けて考えると、判断がぶれにくいですね。
よくある質問
Q1. 日本語の品質は実際どう?英語モデルと比べて不安です。
室谷代表取締役日本語の品質、気になりますよね。うちでも英語モデルと日本語モデルを同じタスクで走らせて、出力の自然さと指示追従を見比べることが多いんですよ。
テキトー教師DotAI 認定講師現場でよく聞くのは「日本語だと急に敬語が崩れる」とか「固有名詞の表記が不安定」という声です。ただ、プロンプトの型を変えるだけで改善することも多いので、いきなり諦めなくて大丈夫です。
室谷代表取締役そうそう。評価用に自社の文書を10本くらい用意して、要約と校正をやらせると差が見えるんですよね。
ベンチマークより手元のデータの方が判断材料になる。
ベンチマークより手元のデータの方が判断材料になる。
Q2. 機密データをAPIに送るのが不安です。何を確認すべき?
テキトー教師DotAI 認定講師最初に戸惑うのがそこですよね。入力データが学習に使われるかどうかは、提供元の規約とプランで変わるので、契約前に必ず確認する必要があります。
室谷代表取締役経営目線だと、事故ったときの損害の方が大きいので、機密性の高いデータは匿名化するか、ローカルで動かす選択肢も残しておく。国際版と中国本土版で扱いが違う可能性もあるので、そこも確認ポイントですね。
テキトー教師DotAI 認定講師たしかに。社内の情報管理ルールと照らし合わせて、送っていいデータの線引きを先に決めておくと、後で揉めません。
Q3. ClaudeやGPTと併用するマルチモデル運用は現実的?
室谷代表取締役これ、実務ではもう普通になりつつあるんですよね。重い推論は高性能モデル、大量の下書きや分類は安いモデル、みたいに振り分ける。
テキトー教師DotAI 認定講師現場感覚で言うと、最初から全部を一つのモデルに寄せようとすると、コストか品質のどちらかが破綻しがちです。ルーティングを噛ませるだけでもだいぶ変わります。
室谷代表取締役ただし管理するモデルが増えると、プロンプトの互換性や障害時の切り替えが面倒になる。運用コストも含めて考えると、2〜3モデルくらいが現実的な落としどころかもしれません。
Q4. GLM-5.2のアップデートは今後も続く?乗り換えタイミングは?
室谷代表取締役モデルの寿命、気になりますよね。基本的には新しいバージョンが出たら、性能と料金のバランスで乗り換えを検討する流れになります。
テキトー教師DotAI 認定講師ただ、現場では「今動いているものが安定しているなら、すぐ飛びつかなくてもいい」という判断も多いです。特に本番系は検証環境で試してからですね。
室谷代表取締役移行コストを見積もっておくと判断が早い。APIの互換性が高いうちは乗り換えやすいですが、プロンプトを大幅に直す必要があるなら、費用対効果で考えた方がいいです。
Q5. 個人開発者が最初に試すなら、何から始めるのがいい?
テキトー教師DotAI 認定講師最初は小さなCLIツールか、自分用の要約ボットみたいなところから触るのがハマりにくいです。いきなり大規模なアプリに組み込むと、どこで詰まっているか分からなくなります。
室谷代表取締役あとは、無料か従量課金の範囲で一度コストを測ってみる。1リクエストあたりのトークン数と時間を見れば、月いくらかかるかの肌感がつかめるんですよね。
テキトー教師DotAI 認定講師そうですね。動かしてログを見る、を一日やってみるだけで、記事を読むより理解が早いと思います。
まとめ
室谷代表取締役ここまで見てきた通り、GLM-5.2は性能と価格のバランスで選ばれるモデルなんですよね。特に長いコンテキストとオープンウェイトは、使い方によってはかなり効きます。
テキトー教師DotAI 認定講師そうですね。ただ、記事でも触れた通り、GLM-5.3が出た後の現在地は変わりやすいので、導入前に公式の最新情報を見るのが前提になります。
室谷代表取締役ビジネス目線だと、いきなり全社導入ではなく、一つの業務フローで試してROIを見る。時給換算でペイするか、まず数字で確認するのがいいと思います。
テキトー教師DotAI 認定講師個人で試すなら、小さなタスクで一週間使ってみるのがおすすめです。APIのレスポンスや日本語の癖も、実際に触ると見えてきますから。
室谷代表取締役うん、迷ったら小さく始めて、データで判断する。それが一番堅いですね。